
11.10.2026 à 08:54
What is umami?
Loïc Briand, Biologiste moléculaire et spécialiste du goût, Directeur de Recherche et Directeur du CSGA, Inrae
Texte intégral (3082 mots)
Characterised at the beginning of the 20th century in Japan, umami literally means “delicious taste” or “tasty taste”. Umami flavour was accepted as one of the five basic tastes at the beginning of the 2000s, on the basis of its detection by the taste receptors present within the patches of tissue or papillae on our tongue. Umami’s distinctive, savoury flavour is mainly produced by certain amino acids that make up proteins, including glutamic acid or its salt form, glutamate (sodium).
Umami has a unique characteristic: a phenomenon of synergy. This means that the flavour of glutamate is drastically increased by certain compounds found in certain foods or ingredients such as bonito – a cousin of tuna – dried (katsuobushi) or yeast extracts.
A mysterious flavour in the West
Although many molecules can produce the umami taste, it is one of the most little known and difficult sensations to describe, mainly because of the rarity of compounds that possess a pure umami taste.
The umami taste can however be generated among foods that are far more widespread than you would imagine: this is the case for algae (kombu algae), mushrooms (shiitake, truffle…) and also as has long been the case with basic kitchen staples like cheese (Parmesan, mature Comté, for example), cured meats (salami, dried ham…), fresh fish (especially bonito, salmon), seafood (shrimp, crabs, scallops…) or simply… tomato juice.


Glutamate is the reference molecule mainly behind umami, although it gets its salty taste from the presence of sodium ions. In powder form it tastes like cooking broth or soy sauce if you disregard its strong, salty flavour. In many Asian countries, glutamate (where its flavour is well known) is used in cooking as an ingredient in its own right.
Westerners on the other hand, lack a reference compound so tend to refer to a broth-like taste or borrow soy sauce as a familiar umami food which despite its strong saltiness, produces a pronounced umami taste.
The History of how umami was discovered
The discovery of umami is a long story. In his book la Physiologie du goût, published in 1826, French gastronome Jean Anthelme Brillat-Savarin describes a specific taste associated with the water-soluble part of meat. In 1866, German chemist Karl Heinrich Ritthausen found and chemically identified glutamic acid by breaking down wheat gluten and separating out a new compound, noting that it is capable of generating a different flavour.


The umami flavour concept was then put forward in 1908 by Kikunae Ikeda. A professor of chemistry at the time at the Tokyo Imperial University, Ikeda isolated glutamate from dried seaweed and was the first to describe its unique taste properties, which sit apart from the other basic tastes (sweet, bitter, sour and salty), and giving the flavour a Japanese name, in her “mother tongue”.
In 1913, Professor Shintaro Kodama highlighted the synergy (or the ability to amplify) of glutamate with compounds derived from RNA degradation (“ribonucleotides” such as inosinate and guanylate).
But it wasn’t until the 21st century that the umami flavour receptor called TAS1R1/TAS1R3 was identified in human papillae in 2002. From then onwards the umami flavour was completely accepted as the fifth basic taste among the scientific community.
The physiological role of umami
Our sense of taste is a chemical detection system dedicated to assessing food’s nutrient content. Its physiological role is to guide our food choices.
Therefore, detecting sweet molecules allows us to identify energy-rich nutrients, which is why we are naturally drawn to sweet things.
It’s a different story for the bitter taste, which provides the basis for our aversions to certain foods, allowing us to avoid potentially toxic compounds that have an unpleasant taste.
Detecting saltiness is of primary importance for maintaining our electrolyte balance. It is essential for finding sodium in our environment, because our bodies constantly lose sodium through our bodily excretory and secretory processes (sweat and urine).
Finally, acidity is an indicator of fruit maturity or the presence of microbial contamination. Identifying acidity also helps protect the body against eating food that is highly acidic that could damage our teeth and skin tissue.
But what about umami? It is believed that the physiological role of this particular taste is to detect amino acids and reveal the presence of protein and molecule-rich foods, which are crucial for ensuring our body functions properly.
Umami in world cuisine
Ingredients rich in umami compounds were introduced into our diet in ancient times to improve cooking. Garum was a condiment used in Rome as early as the Etruscan period. This sauce, derived from the fermentation of the heads and intestines of pickled fish, was used in many dishes and is comparable to nuoc-mâm, a Vietnamese sauce made from fermented fish in brine, that’s almost inseparable from spring rolls. We can also compare garum to pissalat, a French sauce made from fish (mackerel, sardines and anchovies) that is macerated in salt.
Soy sauce is a condiment hailing from China, which was introduced in Japan and spread worldwide. It is obtained by fermenting soya beans mixed with roasted cereals, and salt water. Its umami taste is very intense, as is its saltiness!
Another less well-known example to mention is Worcestershire sauce, which is popular in the UK. Invented in 1837, it is made from molasses and malt vinegar containing anchovies, onions and various spices. Viandox based on soy sauce, yeast extract, and meat extract, launched in France at the beginning of the 1920s, also packs a strong dose of umami.
And last but not least, if there is one cuisine that has showcased this taste, it is Japanese cooking culture. Unlike French cuisine, which is built on layering elements and tastes, it seeks to refine the plate by extracting the quintessence of its most prized produce such as fish, seafood, and seaweed.
Umami is one of the first flavours for babies’ mouths
Glutamate, i.e. the salt of glutamic acid, is commonly used as a flavour enhancer in the food industry in the form of monosodium glutamate (E621). The most widely consumed food additive, it has a global production estimated at several billion tons.
Although glutamate is the focus of debate over the risk of over-consuming it, it should be remembered that it is the most concentrated, free amino acid in breast milk, where it is present at a concentration of 175 milligrams per litre. Since this concentration sits above the threshold of what humans can detect (120 milligrams per litre), umami taste is one of the first flavours babies are exposed to.
Umami is lost on giant pandas
Umami’s physiological role is to alert carnivores to the presence of essential proteins. For example, physiological studies into cat food preferences have shown that our feline companions are also very fond of amino acids.


However, genetic studies have shown that the giant panda is insensitive to the umami taste. But what makes pandas (aguesiac or who have lost their sense of taste) unable to detect umami? The giant panda belongs to the ursid family, of the carnivore order. Their diet (bamboo represents 99% of what they eat) sets them apart from their other animal cousins as they are vegetarian, which paradoxically, makes them strict herbivores.
As mentioned above, umami compounds are detected in the mouth by a single receptor consisting of two subunits (TAS1R1 and TAS1R3). However, a study of the genetic heritage of the giant panda’s genetic heritage has shown that the gene encoding one of the subunits is defective, leading to an inactive umami-like receptor. It is for this reason that giant pandas have no perception whatsoever of umami. It is thought that, during evolution, this gene was lost, simply because the selection pressure on this receptor was let go of, as the species’ survival did not depend on its ability to identify protein.
This article is published as part of the Fête de la science, an annual event in France honouring Science in all its forms (which runs until October 12, 2026) – A The Conversation France partner event. This new edition focuses on the theme “Saveurs Savantes”. Find all the events at Fetedelascience.fr.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Loïc Briand is the President ofthe European Chemoreception Research Organization (ECRO).
11.10.2026 à 08:53
La perte du « goût » est en réalité souvent une perte d’odorat
Thierry Thomas-Danguin, Directeur de recherche - Centre des sciences du goût et de l'alimentation (UMR CSGA), Inrae
Texte intégral (2360 mots)
L’ESSENTIEL
Notre système gustatif ne perçoit que cinq saveurs : le sucré, le salé, l’acide, l’amer et l’umami.
Les goûts que nous percevons résultent de l’intégration de ces informations avec celles issues de la détection de molécules odorantes par le nez, et de sensations « chimiques » provoquées par diverses molécules spécifiques.
Les véritables pertes sensorielles du goût, qui concernent les cinq saveurs, sont beaucoup moins fréquentes que les pertes olfactives.
Un café devenu presque indiscernable d’une tasse d’eau chaude, une pêche dont il ne reste que la douceur et la texture : c’est souvent ainsi que l’on se rend compte d’une « perte du goût ».
Tout le monde peut être concerné, temporairement ou durablement, que ce soit à la suite d’une infection, d’un traumatisme, de la prise de certains traitements, ou encore simplement en raison de l’avancée en âge.
Il faut pourtant savoir qu’il est très rare que ce que l’on appelle « perte du goût » en soit vraiment une, autrement dit que cette expression ne désigne qu’une incapacité à percevoir les saveurs. En réalité, le plus souvent, il s’agit d’une altération de l’odorat.
Pour comprendre pourquoi une même expression peut recouvrir plusieurs troubles sensoriels, il faut se pencher sur la façon dont fonctionne le système qui nous permet de percevoir, non pas uniquement les goûts, mais plutôt les « flaveurs ». Explications.
De la bouche au cerveau, où se construit la flaveur ?
Dans le langage courant, le mot « goût » désigne l’ensemble des sensations éprouvées lorsque nous mangeons. Cependant, pour les scientifiques, cette perception globale correspond en réalité à la « flaveur ».
Ce terme désigne le résultat de l’intégration de trois types principaux d’informations : les saveurs, les odeurs et les sensations « trigéminales ». Ces dernières sont transmises par le nerf trijumeau, un nerf crânien dont les terminaisons sensitives innervent notamment les muqueuses de la bouche et du nez.
Avant tout, rappelons que c’est le système gustatif, situé dans la sphère orale, qui permet de percevoir les saveurs : le sucré, le salé, l’acide, l’amer et l’umami. Les molécules responsables de ces saveurs, libérées par les aliments et dissoutes dans la salive, stimulent les bourgeons gustatifs localisés principalement sur la langue.
Qu’est-ce que l’umami ? Le terme japonais umami peut se traduire approximativement par « savoureux ». Il désigne notamment la saveur caractéristique du dashi, un bouillon traditionnel japonais préparé à partir d’algue kombu. Cette saveur est principalement liée au glutamate, un composé naturellement présent dans les tomates mûres, les champignons, les fromages affinés ou certains bouillons.
Mais alors, pourquoi les goûts que nous percevons ne se limitent-ils pas à ces cinq saveurs ? Parce que d’autres informations sont également collectées lorsque nous mangeons.
Ainsi, le nerf trijumeau est lui aussi activé par certaines molécules, notamment celles responsables des sensations, telles que le piquant du piment, la fraîcheur de la menthe. Ces perceptions relèvent de la « chemesthésie ». Ce terme désigne l’ensemble des sensations provoquées par l’action de certaines molécules sur les terminaisons sensitives du nerf trijumeau. La chemesthésie exprime donc une notion de « sensibilité chimique ». Elle comprend, par exemple, le piquant du piment, la fraîcheur de la menthe, le pétillant d’une boisson gazeuse ou la sensation brûlante de l’alcool.
Les aliments libèrent également des molécules odorantes, qui sont détectées dans le nez par le système olfactif. Ces molécules sont transportées par les flux d’air liés à la respiration et atteignent la partie supérieure de la cavité nasale, où elles activent des récepteurs portés par les neurones sensoriels olfactifs. Ces derniers transmettent ensuite l’information au bulbe olfactif, puis à différentes régions cérébrales.
Ce sont ces molécules odorantes qui contribuent largement à l’identité aromatique de ce que nous goûtons, qu’il s’agisse d’une pêche, d’un café ou du bouquet d’un vin. En effet, avant même qu’un aliment n’entre dans la bouche, certaines molécules volatiles atteignent la cavité nasale lorsque nous respirons son odeur. Cette première activation olfactive, qui se produit lorsque les molécules parviennent au nez via l’air ambiant inspiré, est dite « orthonasale ».
Pendant la mastication, d’autres molécules sont libérées dans la bouche, puis remontent vers le nez par l’arrière-gorge, où elles vont être détectées : on parle alors d’olfaction rétronasale. Celle-ci joue un rôle essentiel dans la perception des aliments.
Pourtant, lorsque nous attribuons au café que nous buvons son arôme torréfié, nous n’avons pas forcément conscience que cette information est détectée dans le nez : elle semble provenir de la bouche, comme les saveurs !
Ces trois sortes d’informations (gustatives, trigéminales et olfactives) sont transmises au cerveau par des voies nerveuses distinctes. Elles y sont ensuite traitées conjointement, dans différentes régions cérébrales. C’est ainsi que le cerveau construit la représentation d’une flaveur, et fait d’une perception multisensorielle une expérience cohérente.
Point intéressant à souligner : la flaveur peut être influencée par la texture, la température et la couleur des aliments, ainsi que – c’est plus surprenant – par certains sons.
Dans un dessert, une texture plus épaisse peut, par exemple, diminuer la perception de la saveur sucrée ou l’intensité de l’arôme de vanille ; sa température agit également sur la libération des molécules odorantes et sur la perception de certaines saveurs.
La vision intervient elle aussi. Ainsi, un vin blanc artificiellement coloré en rouge peut être décrit à l’aide du vocabulaire associé à l’univers des fruits rouges (cassis, framboise…). Enfin, les sons produits lors de la mastication d’une chips participent à la perception de son caractère croustillant.
Pas « une » mais « des » pertes du goût
« Perdre le goût » peut donc correspondre à plusieurs situations. L’hyposmie et l’anosmie correspondent, par exemple, aux atteintes de l’odorat.
Une personne anosmique, dont l’odorat n’est plus fonctionnel, peut ainsi reconnaître qu’un aliment est sucré, salé, acide ou amer, tout en éprouvant des difficultés à l’identifier. L’aliment conserve ses saveurs et sa texture, mais perd une grande partie de son identité aromatique. Une plainte de « perte de goût » révèle donc souvent une perte d’odorat.
D’autres personnes peuvent souffrir d’hypogueusie, un terme désignant une diminution de la perception des saveurs, ou d’agueusie, dans le cas où ces dernières ont complètement disparu.
Les troubles ne se limitent pas toujours à une baisse de sensibilité. Les patients atteints de parosmie, perçoivent, par exemple les odeurs de manière déformée : le café ou le chocolat peuvent ainsi sembler systématiquement avoir une odeur de plastic brûlé.
La phantosmie correspond à une odeur perçue sans source présente. Enfin, la dysgueusie désigne une perception gustative modifiée, comme une saveur amère ou métallique persistante.
On comprend pourquoi l’expression « perte du goût » ne suffit pas, à elle seule, à identifier le problème. Pour orienter l’évaluation clinique, il est crucial de distinguer ces troubles, qui peuvent par ailleurs être transitoires ou persister.
La validation d’un test olfactif à visée clinique, auprès de personnes âgées de 15 à 91 ans, a permis de caractériser les déficits de détection et d’identification des odeurs.
Qui est concerné ?
Il faut souligner que les véritables pertes gustatives – c’est-à-dire celles qui concernent les cinq saveurs – sont beaucoup moins fréquentes que les pertes olfactives.
Une altération de l’odorat ou de la gustation peut néanmoins survenir à tout âge. Elle peut être brutale. C’est le cas lorsqu’elle résulte, par exemple, d’une infection respiratoire, de maladies nasales, sinusiennes ou neurologiques, ou d’un traumatisme crânien. Elle peut aussi s’installer progressivement. Enfin, il arrive qu’elle soit présente dès la naissance : certaines personnes viennent en effet au monde sans odorat.
Cette anosmie congénitale, qui peut être isolée ou associée à un syndrome génétique, comme le syndrome de Kallmann, reste toutefois très rare, puisqu’elle concernerait environ une personne sur 10 000. Elle est parfois découverte tardivement, lorsque la personne compare son expérience à celle de son entourage. Une telle anosmie réduit la perception des arômes et la capacité à détecter certains dangers, mais les personnes concernées développent souvent précocement des stratégies de compensation.
Les capacités olfactives tendent également à diminuer avec l’âge, en fonction de l’état de santé et des médicaments consommés (certains médicaments et traitements altèrent en effet l’odorat ou la gustation).
Le Covid-19, révélateur des troubles chimiosensoriels
Le Covid-19 n’a pas créé les pertes olfactives, mais les a fait connaître à une échelle sans précédent. Dès le début de la pandémie, la disparition soudaine de l’odorat, parfois sans nez bouché, est apparue comme un signe évocateur de l’infection.
Une enquête internationale menée auprès de plus de 4 000 personnes déclarant avoir reçu un diagnostic de Covid-19 a étudié séparément l’odorat, la gustation et la chemesthésie. Les participants rapportaient une forte diminution de l’odorat et de la gustation ainsi qu’une altération moindre des sensations trigéminales. Le Covid-19 pouvait donc toucher plusieurs composantes de la perception chimiosensorielle.
Chez la plupart des personnes, les perceptions se sont progressivement rétablies. Mais une étude de suivi conduite jusqu’à onze mois après l’infection a montré que certains participants conservaient une diminution de l’odorat ou développaient une parosmie ou une phantosmie. Recommencer à percevoir des odeurs ne signifie donc pas toujours retrouver celles d’avant la maladie.
Pourquoi est-il important d’en parler ?
La perte ou la déformation de la perception de la flaveur ne constitue pas seulement une curiosité sensorielle. Lorsque les aliments deviennent fades ou méconnaissables, le plaisir associé aux repas peut diminuer, tout comme l’envie de cuisiner ou de manger avec d’autres personnes, ce qui peut dégrader la qualité des relations sociales.
Certains patients concernés mangent moins et perdent du poids, ce qui est préoccupant chez les personnes âgées, malades ou déjà fragilisées. D’autres compensent en privilégiant des aliments plus sucrés ou salés, les épices, le croquant ou les contrastes de température. Dans une telle situation, il faut en effet réapprendre à choisir, préparer et apprécier ce que l’on mange.
La parosmie entraîne quant à elle des difficultés particulières : des aliments appréciés peuvent devenir insupportables. Or, leur éviction peut réduire la diversité alimentaire. S’y ajoutent la perte d’un plaisir quotidien, le sentiment d’isolement et la difficulté à partager les repas.
Enfin, n’oublions pas que l’odorat contribue aussi à la détection de potentiels dangers, qu’il s’agisse d’une odeur de fumée, de gaz ou d’aliment altéré. Sa disparition peut donc exposer à des risques qui dépassent l’alimentation.
En définitive, perdre le goût ne signifie donc pas toujours perdre les saveurs des aliments. Identifier la composante sensorielle atteinte est essentiel pour en comprendre la cause et limiter ses conséquences sur l’alimentation, la qualité de vie et la sécurité.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Thierry Thomas-Danguin ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
11.10.2026 à 08:52
Grand âge : comment les Ehpad repensent leurs liens avec la vie locale
Manon Labarchède, Docteure en sociologie - Architecte D.E. Postdoctorante en sociologie, Projet ANR-COMPAC | Laboratoire Passages (UMR CNRS 5319), Centre national de la recherche scientifique (CNRS)
Texte intégral (2125 mots)
L’ESSENTIEL
Longtemps conçus comme des lieux autonomes de vie et de soins, les Ehpad cherchent à mieux s’ancrer dans leurs territoires.
Tiers-lieux et services ouverts aux habitants transforment progressivement leur relation à l’extérieur.
Cette ouverture oblige aussi à repenser l’architecture et les usages des établissements.
Aujourd’hui, en France, l’accompagnement des personnes âgées les plus dépendantes repose en majorité sur les établissements d’hébergement pour personnes âgées dépendantes (Ehpad). Loin de faire l’unanimité, ces structures sont souvent considérées comme des solutions par dépit lorsque le maintien à domicile, solution d’accompagnement largement privilégiée par les personnes âgées elles-mêmes et par les politiques publiques, n’est plus envisageable.
Cette image négative s’est renforcée au cours des dernières années sous l’effet d’une médiatisation importante des difficultés rencontrées par les établissements, notamment lors de la crise du Covid-19, mais aussi avec la parution de l’ouvrage les Fossoyeurs, de Victor Castanet (2022), qui dénonce les conditions de vie et de prise en charge au sein d’un groupe d’établissements privés lucratif. Dans ce contexte, la question de l’avenir des Ehpad fait l’objet de débats nourris.
Des établissements historiquement conçus pour favoriser l’autarcie résidentielle
Héritiers des hospices du XXᵉ siècle, les Ehpad ont connu, au cours des quarante dernières années, de profondes transformations visant à améliorer les conditions de vie des personnes âgées accueillies. Ces évolutions cherchaient notamment à faire de ces structures des lieux de vie, et non plus uniquement des lieux de soins.
À lire aussi : Personnes âgées : une solidarité familiale trop souvent passée sous silence
Dans cette perspective, les établissements se sont peu à peu efforcés de recréer, autant que possible, les conditions de vie que les résidents connaissaient à leur domicile en cherchant à leur offrir l’ensemble des services, qu’ils soient médicaux ou sociaux, dont ils ont besoin pour vivre. Ainsi, des services habituellement accessibles à l’extérieur ont été intégrés au sein même des établissements (coiffeur, restaurant, lieu de culte, espace bien-être, etc.) afin d’en faciliter l’accès aux résidents.
Si cette logique répond à des objectifs légitimes d’amélioration de la qualité de vie des résidents, elle produit également des effets ambivalents.
D’un point de vue architectural, elle implique une diversification et une augmentation des surfaces à intégrer au programme : aux chambres et espaces de vie des résidents s’ajoutent de nombreux espaces collectifs, médicaux, techniques et logistiques dédiés à l’accompagnement de la vie quotidienne des résidents.
De même, la concentration au sein d’un même espace de l’ensemble des services nécessaires à la vie quotidienne favorise les logiques d’entre-soi et limite les occasions d’interactions avec l’extérieur.
L’amélioration de la qualité de vie peut alors s’accompagner d’un sentiment de mise à l’écart du reste de la société vécus par les résidents, comme perçu par le reste de la société.
À lire aussi : Tout sauf l’Ehpad ? Les ambiguïtés de la politique du grand âge
Surtout, cette logique d’autarcie tend à limiter les liens entre l’établissement et son environnement d’implantation. L’Ehpad est alors pensé comme un modèle largement reproductible, relativement indépendant des spécificités locales et territoriales. Cette standardisation contribue à rendre ces établissements facilement identifiables, mais aussi à les distinguer du tissu social et urbain dans lequel ils s’inscrivent, participant à une forme de stigmatisation des personnes qui y sont hébergées.
Des établissements qui s’ouvrent progressivement sur l’extérieur
En avril dernier, Camille Galliard-Minier, ministre déléguée chargée de l’autonomie et des personnes en situation de handicap, a annoncé un projet de transformation des Ehpad à travers la labellisation de l’ensemble des établissements en « Maisons France Autonomie » d’ici 2027. L’objectif est d’« accompagner la transformation des établissements en des maisons ouvertes sur l’extérieur, en lieux de vie ».
Présentée comme une des six priorités du plan France Autonomie, cette proposition s’inscrit dans la continuité du « virage domiciliaire » engagé par les différents gouvernements depuis une dizaine d’années. Il désigne la réorientation des politiques publiques vers le maintien à domicile, afin de permettre aux personnes âgées de rester autant que possible dans leur environnement de vie. Il repose sur le développement et la coordination des services d’aide et de soins à domicile, l’adaptation des logements, le développement de solutions d’habitat intermédiaires (habitat inclusif, résidences autonomie, etc.) et le soutien aux proches aidants.
Le virage domiciliaire interroge aussi la place de l’Ehpad. S’il ne conduit pas nécessairement à sa disparition, il implique la redéfinition de sa fonction et de son rôle dans les parcours des individus. Ainsi, les réflexions sur l’« Ehpad du futur », portées par les acteurs du champ et les politiques publiques, ne se limitent pas à l’évolution de l’organisation et de modes d’accompagnement des établissements, jugés trop rigides, médicalisés et ne respectant pas toujours les volontés et libertés des personnes. Elles interrogent aussi l’inscription de l’Ehpad dans des dynamiques territoriales à travers l’ouverture des établissements.
En ce sens, une première approche vise à ouvrir davantage les Ehpad sur leur territoire en étendant leurs interventions au-delà du périmètre des établissements.
Dans un premier temps, les expérimentations de dispositifs d’ « Ehpad hors les murs » ont ainsi permis de développer des services externalisés et une prise en charge renforcée afin de favoriser le maintien à domicile des personnes âgées : accès à des professionnels spécialisés dans le champ de la gérontologie, solutions de répit, téléassistance, transport, activités sociales, etc.
Plus récemment, les centres de ressources territoriaux (CRT), financés par appels à projets des Agences Régionales de Santé, ont prolongé et élargi cette dynamique. À l’accompagnement renforcé des personnes âgées à domicile s’ajoute à présent un appui aux professionnels libéraux du territoire intervenant à domicile, à travers par exemple des actions de formation, la mise à disposition d’équipements ou encore le partage d’expertise.
Dans une approche davantage centrée sur la dimension sociale que sanitaire, le développement de tiers-lieux au sein des établissements, largement soutenu et financé par la Caisse nationale de solidarité pour l’autonomie (CNSA) est pensé dans l’optique de créer :
« Un lieu, dans l’enceinte de l’établissement, qui soit librement accessible aux résidents comme aux habitants des environs, et qui permette les échanges, les rencontres, les animations entre personnes de tous âges. »
Restaurant, épicerie, jardin partagé, médiathèque ou même bistrot, sont autant d’espaces, qui voient le jour au sein des établissements.
Si elle peut paraître très institutionnalisée, l’ouverture des établissements sur leur environnement est aussi pensée par les acteurs de terrain et s’appuie sur une multitude d’initiatives plus informelles, développées localement par les établissements, les associations ou les habitants eux-mêmes afin de favoriser la rencontre et l’échange.
À Bordeaux, par exemple, l’Ehpad Village Terre-Nègre a ouvert un café associatif destiné à accueillir à la fois les résidents et les habitants du quartier, faisant entrer des activités ordinaires de la vie locale au sein de l’établissement. À Brest, c’est le restaurant de l’Ehpad qui accueille une clientèle nouvelle et élargie.
Repenser l’architecture des Ehpad pour les ouvrir sur leur territoire
Dans la conception même des établissements, l’ouverture implique un changement profond. Celui-ci repose à la fois sur une meilleure prise en compte du contexte local d’implantation (services disponibles à proximité, desserte des établissements, offre manquante sur le territoire) et sur l’organisation des espaces au sein des établissements. L’ouverture ne peut être envisagée comme une simple caractéristique fonctionnelle ; elle constitue un principe structurant de production de l’espace institutionnel.
Elle influence non seulement la relation de l’établissement à son environnement immédiat et le traitement de ses interfaces avec l’extérieur, mais également l’organisation des espaces intérieurs et les usages qui s’y déploient entre accès au public et intimité. Une logique d’autant plus importante, que l’analyse des établissements, tels qu’ils sont construits aujourd’hui, souligne déjà des incohérences obligeant par exemple les résidents à passer par les espaces collectifs pour se rendre aux douches communes, ou encore les visiteurs à traverser l’ensemble du couloir desservant les chambres pour se rendre dans un lieu collectif.
L’ouverture des établissements poursuit donc un objectif commun : renforcer les interactions entre l’Ehpad et son environnement de proximité. Il s’agit de faire de l’établissement non plus seulement un lieu d’hébergement et de soins, mais également un lieu inscrit dans une dynamique sociale et d’offre de proximité du territoire.
Dans cette perspective, il est nécessaire de ne pas oublier qu’ouvrir l’Ehpad sur son environnement ne consiste pas seulement à proposer de nouveaux services ou à faire entrer des acteurs extérieurs dans l’établissement. Il s’agit aussi de permettre aux résidents de bénéficier davantage des ressources déjà présentes sur le territoire : activités culturelles et sportives, commerces, services publics, associations ou lieux de sociabilité.
Le projet COMPAC sur lequel s'appuie cet article est soutenu par l’Agence nationale de la recherche (ANR), qui finance en France la recherche sur projets. L’ANR a pour mission de soutenir et de promouvoir le développement de recherches fondamentales et finalisées dans toutes les disciplines, et de renforcer le dialogue entre science et société. Pour en savoir plus, consultez le site de l’ANR.

Manon Labarchède a reçu des financements de la Fondation Médéric Alzheimer pour sa thèse de doctorat en sociologie "Les espaces de la maladie d'Alzheimer: conditions de vie, hébergement et hospitalité" (Université de Bordeaux, 2021)
11.10.2026 à 08:52
Trump peut-il acheter les midterms ?
Frédérique Sandretto, Adjunct assistant professor, Sciences Po
Texte intégral (1687 mots)
L’ESSENTIEL
Donald Trump a promis 5 000 dollars à chaque citoyen des États-Unis si les républicains conservent la majorité au Congrès à l’issue des élections de mi-mandat du 3 novembre.
Cette approche relève d’une « politique-business » propre au magnat new-yorkais : l’État est présenté comme une entreprise dont les citoyens sont les actionnaires, qui ont donc droit à un « dividende » quand l’État fait des bénéfices.
Or, les États-Unis affichent un déficit budgétaire colossal et le financement de cette promesse semble pour le moins douteux. D’ailleurs, les électeurs semblent peu enclins à y croire…
La scène était exceptionnelle à plus d’un titre. À Dallas, le 10 septembre dernier, Donald Trump a transformé la première convention républicaine organisée à l’occasion des élections de mi-mandat en un immense meeting à sa gloire.
À l’approche des midterms du 3 novembre, le président ne s’est pas contenté de soutenir les candidats de son parti. Il a voulu faire de cette élection un référendum sur sa propre personne. Il a même demandé aux électeurs de voter comme si son nom lui-même figurait sur le bulletin de vote. Pendant près de deux heures, le locataire de la Maison-Blanche a occupé la scène, multipliant les attaques contre les démocrates et affirmant que son bilan était exceptionnel et devait nécessairement se traduire par une victoire de sa formation.
Surtout, il a dégainé un argument massue : si les républicains conservent la majorité à la Chambre des représentants et au Sénat, chaque citoyen états-unien adulte recevra 5 000 dollars (l’équivalent de 4 500 euros).
Un dividende de 5 000 dollars
Trump a choisi un mot extrêmement révélateur pour désigner cette somme : le « dividende ».
Le terme n’est pas anodin. Un dividende est normalement une somme versée aux actionnaires d’une entreprise lorsque celle-ci réalise des bénéfices. En utilisant ce vocabulaire, le chef de l’État se place une nouvelle fois dans une posture de chef d’entreprise. Il présente les États-Unis comme une immense société dont les citoyens seraient les actionnaires, invités à reconduire l’équipe dirigeante s’ils souhaitent bénéficier d’un joli chèque.
Mais de quelle somme parle-t-on réellement ? Le pays comptant environ 260 millions de citoyens adultes, une allocation de 5 000 dollars représenterait potentiellement près de 1 300 milliards de dollars. À titre de comparaison, le budget de la défense des États-Unis, premier poste de dépense du gouvernement fédéral, sera de 1 150 milliards de dollars en 2027, un montant jamais atteint jusqu’ici.
La question du financement surgit donc immédiatement. Or Trump n’a pas expliqué précisément comment ce programme serait financé. Il n’a pas présenté de dispositif législatif détaillé, alors qu’un tel versement nécessiterait l’intervention du Congrès. Le président ne peut pas décider seul de distribuer 1 300 milliards de dollars aux citoyens. Le caractère spectaculaire de l’annonce est donc très supérieur, pour le moment, à sa traduction juridique et budgétaire.
Cette promesse rappelle surtout les précédents de la politique économique trumpienne. En 2025, l’idée d’un DOGE dividend avait déjà circulé. Le principe était alors de reverser aux contribuables une partie des économies que l’éphémère Department of Government Efficiency, dirigé pendant les premiers mois de son activité par Elon Musk, devait permettre de réaliser. Le chiffre de 5 000 dollars avait déjà été évoqué. Donald Trump avait lui-même repris l’idée, mais elle ne s’était jamais transformée en programme concret.
Vers un modèle de « politique-business »
Ce précédent est important parce qu’il permet de comprendre la mécanique politique actuelle. L’idée n’est pas simplement de distribuer de l’argent, mais de transformer des instruments de politique publique en produits politiques immédiatement compréhensibles.
Les économies réalisées par le DOGE deviennent un dividende. Les recettes douanières deviennent un remboursement. Les bons résultats économiques deviennent une prime. Et maintenant, la victoire républicaine aux élections devient la condition permettant d’obtenir 5 000 dollars.
Cette « politique-business » repose sur une conception très transactionnelle du pouvoir. La politique est présentée comme un contrat. Trump affirme qu’il apporte de la croissance, de la puissance, des investissements, des emplois ou des économies ; en échange, l’électeur lui doit sa confiance et surtout son vote.
Une promesse risquée
La question est évidemment de savoir si une telle promesse peut réellement faire pencher la balance du côté du parti républicain.
La réponse est plus complexe qu’il n’y paraît. Sur le plan psychologique, 5 000 dollars représentent une somme suffisamment importante pour attirer l’attention de millions d’électeurs. Dans une période où le coût de la vie, l’inflation et le prix de l’énergie préoccupent fortement les Américains, la promesse d’un versement direct peut avoir un impact immédiat. D’autant qu’elle permet également à Donald Trump de déplacer la campagne sur un terrain qui lui est favorable : celui de l’argent, du pouvoir d’achat et de la capacité à obtenir des résultats concrets.
Mais cette promesse comporte également plusieurs risques.
Le premier est sa crédibilité. Les électeurs ont déjà entendu parler du DOGE dividend et du tariff dividend (en novembre 2025, Trump avait promis de redistribuer aux Américains au moins 2 000 dollars par personne, ce qui représentait selon lui une partie des recettes supplémentaires provenant des droits de douane qu’il avait instaurés) sans jamais recevoir les sommes annoncées. La promesse des 5 000 dollars peut donc être reçue avec un certain scepticisme.
D’ailleurs, d’après un sondage conduit mi-septembre, seuls 21 % des personnes interrogées croient que, en cas de victoire, Trump mettra réellement cet engagement en œuvre. Et selon une autre enquête, conduite quelques jours plus tard, la promesse de Trump ne change rien aux intentions de vote de 52 % des électeurs, tandis que 32 % affirment qu’elle les rend moins susceptibles de voter en faveur des candidats républicains, et 15 % seulement reconnaissent qu’elle peut les inciter à déposer dans l’urne un bulletin du parti du président.
Le deuxième risque est budgétaire. Le gouvernement fédéral affiche déjà un déficit extrêmement important. Le Bureau du budget du Congrès américain (CBO) prévoit un déficit annuel d’environ 2 100 milliards de dollars. Verser plus de 1 000 milliards de dollars supplémentaires supposerait soit d’obtenir de nouvelles recettes, soit de réduire massivement certaines dépenses, soit d’accroître la dette. Les économistes soulignent également qu’une injection aussi importante de liquidités dans une économie déjà confrontée à des tensions inflationnistes pourrait alimenter de nouvelles hausses de prix.
Le troisième risque est politique. Juridiquement, la promesse de Trump ne relève pas d’un achat de vote au sens strict, puisque le versement serait destiné à tous les citoyens, indépendamment de leur vote individuel et ne constituerait pas une récompense pour avoir personnellement voté républicain. Mais politiquement, l’annonce place plus que jamais Trump, en sa qualité de chef de l’État fédéral, au cœur de la campagne, ce qui peut, certes, mobiliser son électorat le plus fidèle, mais aussi éloigner les indépendants et certains électeurs modérés – et galvaniser l’électorat démocrate, qui pourrait aller voter plus massivement que si le président s’était tenu à l’écart de la campagne.
Quels enjeux pour le 3 novembre prochain ?
La question des prochaines semaines ne sera donc plus seulement de savoir si Donald Trump peut promettre 5 000 dollars à 260 millions de personnes, mais combien d’électeurs américains croiront à la promesse d’un tel dividende. Jusqu’où les électeurs sont-ils encore prêts à miser sur Trump ?
Le 3 novembre, l’Amérique dira si elle est encore prête à investir dans l’entreprise politique de Donald Trump ou si elle estime désormais que le rendement promis ne justifie plus le risque.

Frédérique Sandretto ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
11.10.2026 à 08:51
Pourquoi le prix du bois chute-t-il après un incendie ou une tempête ?
Marielle Brunette, Directrice de recherche, Inrae
Killian Baué, doctorant en économie forestière, Inrae
Texte intégral (2857 mots)
L’ESSENTIEL
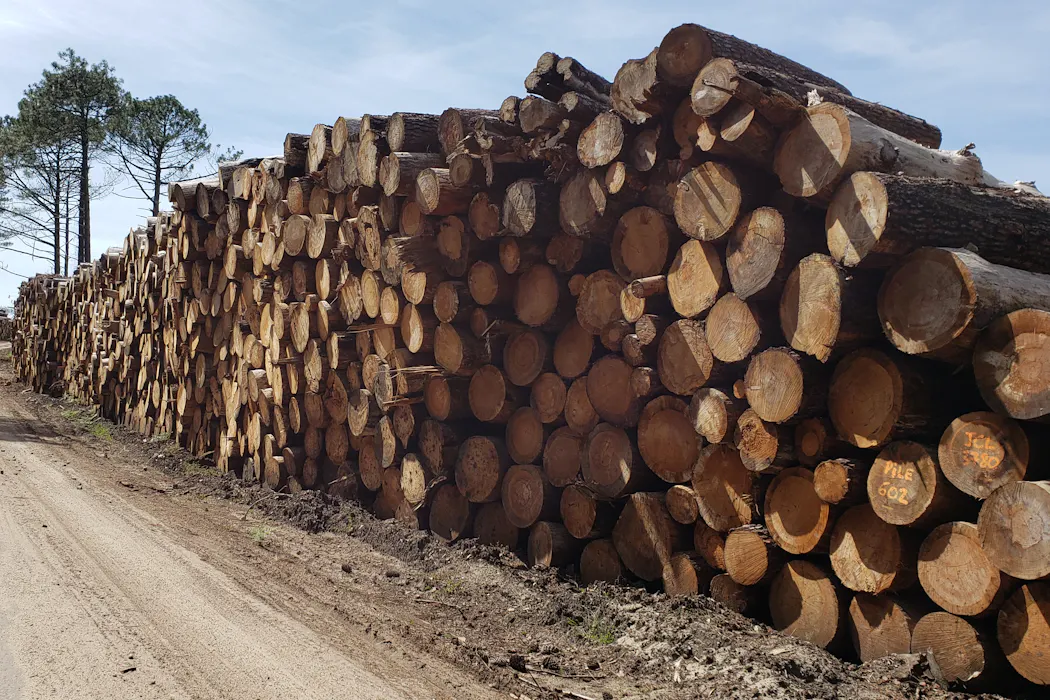
Après une tempête ou un incendie, de nombreux arbres endommagés peuvent être vendus si on agit rapidement.
Un afflux de bois à écouler dans les plus brefs délais sur le marché fait alors baisser les prix.
Quelques années plus tard, l’inverse peut survenir : la production d’arbres a diminué et les prix remontent.
C’est un phénomène qui peut parfois surprendre : après des événements catastrophiques de type incendie ou tempête, le prix du bois a tendance à chuter. Le grand public peut souvent s’étonner de cette réalité, en pensant qu’il y a sûrement moins de bois disponible après ces fléaux et que la rareté de cette matière première en augmente forcément les prix. La réalité est tout autre, voici pourquoi.
Beaucoup de bois à écouler rapidement
Après une catastrophe de grande ampleur, beaucoup d’arbres sont endommagés simultanément. Mais cela ne signifie pas que le bois est perdu. S’il est récolté rapidement, il reste exploitable pour la plupart des usages, de la construction à l’énergie, même s’il perd l’accès aux débouchés les plus valorisants.
Une partie ne sera jamais récoltée, non parce qu’elle est inutilisable, mais parce que ce ne sera pas rentable. Le reste doit cependant être exploité rapidement afin de limiter leur dégradation et de préserver leur valeur commerciale. Il en résulte un afflux potentiel de bois sur le marché, mais la filière forêt-bois ne peut pas nécessairement absorber une telle quantité en peu de temps.
Un exercice périlleux en temps limité
Le premier verrou se situe en forêt, où les capacités d’exploitation habituelles, en bûcherons, en engins et en accès aux parcelles, ne suffisent pas à récolter dans le temps imparti l’afflux d’arbres abattus par une catastrophe. Prélever le bois endommagé en forêt est, dans la grande majorité des cas, le travail des entreprises de travaux forestiers (ETF), qui réalisent environ 80 % des travaux d’exploitation en France. Or, le Conseil général de l’alimentation, de l’agriculture et des espaces ruraux (CGAAER) souligne que la profession est confrontée à des difficultés d’attractivité et de recrutement. Les travaux de récolte sont en outre décrits comme physiquement exigeants et dangereux par l’interprofession nationale.
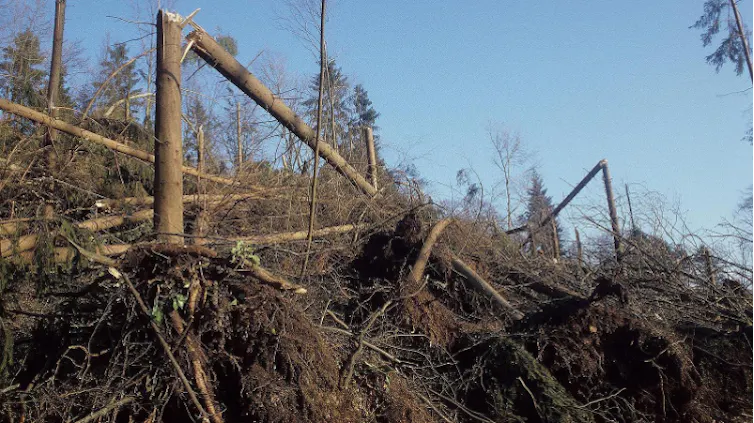
Dans le cas d’une tempête, par exemple, l’exploitation des chablis (les arbres renversés ou brisés par le vent) est particulièrement contraignante : enchevêtrés au sol, ils présentent des difficultés techniques et de sécurité spécifiques pour les exploitants (cf. photo ci-dessous). Pour cette raison, les [pouvoirs publics] ont notamment retenu un surcoût forfaitaire d’exploitation des chablis de 10 euros par mètre cube, déductible du revenu forestier des propriétaires sinistrés, après les tempêtes de 1999 et, dans le Sud-Ouest, après la tempête Klaus en 2009.
Dans ce contexte, la capacité effective de récolte peut être réduite au moment même où le volume à exploiter augmente fortement.
Une logistique complexe et des scieries de moins en moins nombreuses
Le deuxième verrou concerne la logistique. Les bois doivent être abattus, façonnés, débardés (sortis des parcelles jusqu’en bord de route), transportés et, lorsque leur conservation l’exige, stockés dans des conditions permettant de ralentir leur dégradation.
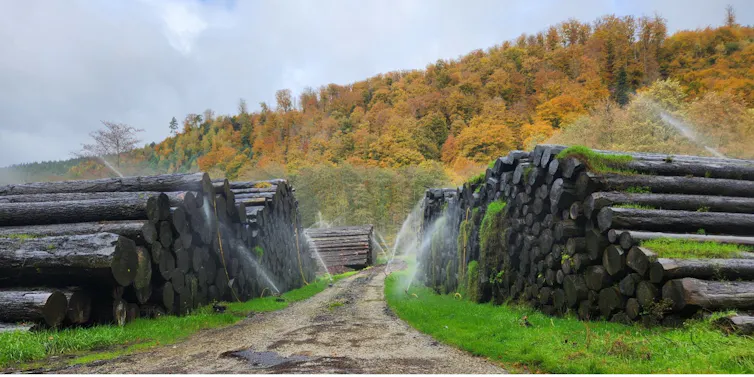
Lors des grandes tempêtes, une partie des troncs abattus (les grumes) a été conservée par aspersion : un arrosage continu maintient le bois saturé en eau, ce qui limite l’apport d’oxygène et ralentit le développement des champignons et insectes responsables de sa dégradation (cf. photo ci-dessous). Cette technique a permis notamment de réguler l’afflux de chablis sur le marché.
La tempête Caetano, en novembre 2024, illustre cette contrainte dans la vallée de la Tarentaise, en Savoie : l’Office national des forêts (ONF) estimait à environ 60 000 mètres cubes le volume de chablis à exploiter, soit, pour la seule commune des Allues, l’équivalent d’environ vingt années d’exploitation habituelle. Un an après, en novembre 2025, l’essentiel de ces bois avait été évacué, façonné et écoulé auprès d’acheteurs partout en France, grâce à des contrats d’approvisionnement mobilisés en urgence.
Le troisième verrou est industriel. Selon l’Agreste, la France comptait 1 214 scieries en 2022, contre 9 000 en 1973, selon la Cour des comptes. La Cour des comptes souligne surtout le sous-dimensionnement de l’outil français : avec une surface forestière inférieure d’environ un tiers, l’Allemagne produit plus de deux fois plus de sciages.
S’y ajoute un décalage structurel, le « paradoxe français » : les sciages portent à 80 % sur des résineux alors que la forêt est feuillue à environ deux tiers. La France importe ainsi chaque année environ 2 millions de mètres cubes de sciages résineux.
Un choc d’offre
Il résulte de cette situation un décalage : après une tempête, un incendie ou une infestation de scolytes (des petits coléoptères qui coupent la circulation de la sève de certains conifères en creusant des galeries dans le bois), la quantité de bois qui pourrait être vendue dépasse largement la quantité qui peut effectivement être récoltée, transportée et transformée dans la fenêtre de temps où ce bois conserve sa valeur. Les prix s’effondrent, tandis qu’une partie des volumes se dégrade sur pied ou en forêt avant d’avoir pu être mobilisée.
En langage économique, on dit que l’offre est supérieure à la demande. Dans ce contexte, la réaction du marché, c’est une chute des prix. En effet, plus un produit est disponible, plus son prix est bas et, inversement, plus un produit est rare, plus il est cher. Il n’est donc pas surprenant qu’un afflux massif de bois sur le marché génère ce que l’on appelle un « choc d’offre ».
Un tel choc fut observé à la suite des tempêtes de 1999 et de 2009. D’après le Centre d’études et de prospectives (CEP) du ministère de l’agriculture, le prix du pin maritime a ainsi chuté de près de 60 % après la tempête Klaus de 2009.
Ce phénomène a également été observé, dans une moindre mesure, dans l’est de la France, en 2018 à la suite des ravages des scolytes. Les conséquences économiques de ces ravages ont été encore plus manifestes dans d’autres pays, en République tchèque par exemple, où la crise des scolytes de 2018 a provoqué une hausse de 340 % des quantités de bois endommagés, engendrant une chute des prix du bois de 73 %.
Un contrecoup possible
Un choc d’offre, cela signifie une urgence à traiter immédiatement, mais aussi des problèmes d’approvisionnement à anticiper. En effet, beaucoup de bois maintenant, cela signifie moins de bois plus tard, car les arbres mettent du temps à pousser. Par conséquent, une baisse brutale des prix peut être suivie après quelques années par une hausse brutale, puisque le bois devient plus rare. On l’observe clairement sur le graphique ci-dessous avec le prix du pin maritime qui s’est effondré à la suite de la tempête Klaus de 2009 avant de remonter progressivement jusqu’à atteindre deux fois le prix d’avant tempête (environ 25 euros par mètre cube en 2005 versus 50 euros en 2018).
Certaines caractéristiques peuvent contribuer à accentuer cette chute de prix. Tout d’abord, si les dommages sont concentrés dans une zone assez restreinte, le marché local va s’effondrer. De plus, la baisse du prix est plus importante quand le bois est homogène en essence et en usage.
Ces deux caractéristiques ont été rencontrées lors de la tempête Klaus de 2009. Cette tempête a touché essentiellement le sud-ouest de la France, endommageant principalement du pin maritime. La chute de prix qui s’est ensuivie fut spectaculaire, atteignant un prix de zéro en 2009-2010. Dans ce cas précis, il devient urgent d’alimenter un marché plus large, d’évacuer les bois vers d’autres régions, voire d’autres pays. Si la catastrophe avait touché plusieurs régions et des essences variées, l’impact aurait été moindre, comme ce fut le cas avec la tempête de 1999 (cf. graphique).
Peut-on minimiser la baisse des prix ?
Comment, dès lors, limiter ces chutes et hausses des prix ?
Les propriétaires peuvent utiliser des contrats d’approvisionnement qui stipulent une date de récolte et un prix, de manière à ne pas subir la volatilité courante des prix du bois. Toutefois, cet instrument ne fonctionne pas en cas d’aléa, car le propriétaire impacté n’est pas en mesure de respecter les clauses du contrat, notamment en matière de qualité et de diamètre.
Une pratique souvent mise en œuvre est de demander aux propriétaires d’être solidaires. En effet, on va suggérer aux propriétaires qui n’ont pas été touchés d’attendre, de décaler leur récolte afin de limiter les bois disponibles sur le marché. Par exemple, après les incendies de 2022 dans le Sud-Ouest, les ventes d’automne par appel d’offres ont été annulées afin de permettre la récolte des bois sinistrés dans les meilleures conditions.
Ensuite, plusieurs politiques publiques peuvent être mises en œuvre, dont certaines ont déjà été testées. Par exemple, une politique de stockage a déjà été mise en œuvre à la suite des tempêtes de 1999 et de 2009. Il s’agit d’entreposer les bois sur des aires de stockage spécifiques, ce qui permet de lisser l’offre de bois dans le temps, c’est-à-dire d’écouler les bois sur le marché plus lentement.
Des subventions au transport ont également déjà été mises en place après les mêmes tempêtes. Elles ont pour objectif de favoriser la circulation des bois sur le territoire et au-delà, c’est-à-dire d’élargir le marché. Enfin, la fixation d’un prix plancher est également une mesure disponible, mais qui, à notre connaissance, bien que parfois discutée, n’a jamais été décidée. Cette fois, il s’agit d’imposer un prix minimum de vente afin d’éviter la ruine du vendeur.
Des aléas de plus en plus fréquents
Sous l’effet du changement climatique, les aléas naturels deviennent plus fréquents et plus intenses. On observe notamment une récurrence d’aléas dans les mêmes zones géographiques. Le Sud-Ouest a ainsi subi une sécheresse en 2021, des incendies de l’été 2022 et les attaques de scolytes qui ont suivi. Ou encore, plus récemment, avec l’arrivée de la nématode du pin à Seignosse dans les Landes en novembre 2025, suivie de la tempête Nils en février 2026, et des grands incendies de l’été 2026. Ces risques multiples et en cascade vont encore accentuer l’instabilité du marché du bois et accroître la volatilité des prix.

Ce travail a bénéficié de l’appui de l’Observatoire pour L’Economie de la Forêt (OLEF) - https://doi.org/10.17180/hk4v-2a37, plateforme de l’UMR BETA. Les auteurs remercient Alexandra Niedzwiedz pour ses conseils et la réalisation du graphique. Ce travail a reçu le soutien du MP XRisques d’INRAE et du projet X-RISKS du PEPR FORESTT (ANR-24-PEFO-0005).
Ce travail a bénéficié de l’appui de l’Observatoire pour L’Economie de la Forêt (OLEF) - https://doi.org/10.17180/hk4v-2a37, plateforme de l’UMR BETA. Les auteurs remercient Alexandra Niedzwiedz pour ses conseils et la réalisation du graphique. Ce travail a reçu le soutien du MP XRisques d’INRAE et du projet X-RISKS du PEPR FORESTT (ANR-24-PEFO-0005).
11.10.2026 à 08:51
Près de 2,7 € de retombées économiques pour chaque euro investi : les universités, moteurs de croissance des territoires
Yannick L’Horty, Économiste, professeur des universités, Université Gustave Eiffel
Laetitia Challe, Docteure en Sciences Économiques - Ingénieure de recherche, Université Gustave Eiffel
Texte intégral (1590 mots)
L’ESSENTIEL
Par leurs dépenses et les publics qu’elles attirent, les universités irriguent le tissu économique.
Si ces retombées se repèrent vite, leurs effets sur la compétitivité sont plus difficiles à mesurer localement.
Un champ de recherche en essor permet d’estimer plus clairement l’apport des universités aux territoires.
Les retombées économiques des établissements d’enseignement supérieur et de recherche (ESR) sur leurs territoires sont souvent peu identifiées par les citoyens.
Le programme Investigation socio-économique sur l’impact territorial des universités (In Situ) permet de les mettre en lumière, en procédant à une réévaluation systématique de la mesure de leur impact local. Déployé en 2025 sur les 6 universités membres de l’association L’initiative, il concernera plus de 10 universités fin 2026.
Ces travaux révèlent qu’1 € investi par l’État dans les universités implique 2,7 euros de retombées économiques pour les collectivités. Il s’agit là d’un résultat robuste, confirmé pour toutes les universités où ce type de calcul a été réalisé.
Différents canaux d’impact
Par leur mission d’enseignement, ces établissements améliorent les compétences des étudiants, ce qui s’apparente, d’un point de vue économique, à un investissement en capital humain. Par leur mission de recherche, ils produisent et diffusent des innovations, des brevets et des connaissances scientifiques qui alimentent le progrès technique, la compétitivité et l’efficacité globale de l’économie.
Ces relais majeurs améliorent les conditions de l’offre de biens et services et jouent un rôle de premier plan dans un contexte de transitions technologique, écologique et sociétale. Mais ils sont spatialement diffus et, bien souvent, ne sont ni perceptibles ni même mesurables à une échelle locale.
Il n’en va pas de même des relais du côté de la demande. Une université est aussi un agent économique et, comme toutes les entreprises ou les acteurs institutionnels, elle engage des dépenses qui ont un effet direct sur la croissance économique et la création d’emplois. L’université réalise par elle-même des dépenses de fonctionnement et d’investissement dans le cadre de ses missions. Ses personnels génèrent des dépenses là où ils résident, en matière de logement, de transport et de consommation. Les étudiants sont aussi des consommateurs et ils peuvent occuper des emplois salariés pendant leur formation, en cas d’alternance. Ces flux irriguent le tissu économique local et méritent d’être objectivés.
Des régions de plus en plus investies
Les collectivités l’ont bien compris et elles investissent depuis plusieurs années dans le financement de l’enseignement supérieur et de recherche (ESR). Si la région est la collectivité territoriale la plus contributrice, à hauteur de 67 %, entre 2018 et 2021, les communes, les intercommunalités et les départements contribuent également alors même que la compétence de l’ESR y est facultative ou optionnelle.
L’État demeure néanmoins le financeur principal de l’ESR, avec la subvention pour charge de service public (SCSP), introduite en 2001, qui représente près de 70 % du budget des universités, auquel s’ajoutent les frais d’inscription et les recettes issues du secteur économique (apprentissage, formation continue, partenariats).
Des difficultés méthodologiques à considérer
Les travaux qui se proposent de mesurer l’impact économique d’une Université se situent dans un champ qui s’est développé depuis plus d’une cinquantaine d’années, principalement aux États-Unis, depuis l’étude de Caffrey et Isaacs Estimating the Impact of a College or University on the Local Economy, publiée en 1971, puis en Europe et notamment en France où un grand nombre de travaux ont été menés à bien selon la même perspective.
Une signature de ce champ de littérature est de distinguer des effets directs et indirects, en adoptant une approche quasi-comptable, et des effets induits, en faisant alors appel à une modélisation d’inspiration keynésienne.
Cette littérature est toutefois marquée par plusieurs limites bien identifiées. D’une part, la grande hétérogénéité des multiplicateurs régionaux retenus et leurs niveaux parfois très élevés (valeurs allant de 1 à 7 selon les études) reflètent des choix méthodologiques et des hypothèses souvent peu harmonisés.
D’autre part, la plupart des applications reposent sur des données agrégées et sur des matrices input-output construites à des niveaux géographiques relativement larges, ce qui limite la capacité à suivre finement les flux de dépenses selon l’identité des fournisseurs ou la localisation précise des étudiants et des personnels.
Dépense publique et effets de proximité
Le programme In Situ repose quant à lui sur l’exploitation de données internes de gestion exhaustives et localisées à la commune, combinées à des données d’enquête et à des simulations, selon une méthode harmonisée permettant de comparer les établissements entre eux, dans l’espace et dans le temps. L’étude pilote sur le périmètre de l’Université Gustave-Eiffel illustre la force des effets de proximité en montrant que sa commune d’implantation, Champs-sur-Marne, capte à elle seule 30,5 % de l’effet emploi de la communauté d’agglomération de Paris-Vallée de la Marne, alors qu’on y dénombre 12,5 % des emplois. La communauté capte elle-même 34,9 % de l’effet départemental, alors qu’elle en représente 17 % des emplois. Le département de Seine-et-Marne capte 40,2 % de l’effet régional alors qu’il représente 8 % de l’emploi de la région Île-de-France.
Ce programme a d’ores et déjà couvert les six universités membres de l’association l’Initiative. Sur ce périmètre qui correspond à une cohorte de 206 000 étudiants, l’impact économique total atteint près de 4 milliards d’euros au niveau national, soit environ 0,13 point de PIB, pour 83 500 emplois en équivalent temps plein, soit l’équivalent d’un grand groupe industriel.
Cette mesure d’impact a été rapportée à la subvention pour charge de service public, pour conclure que chaque euro investi par l’État dans ces universités génère en moyenne 2,7 euros d’activité économique dans les territoires, avec un effet multiplicateur compris entre 2,3 et 3,4 selon les établissements.
Ce résultat central est très solide. Il repose sur des données de gestion localisées et sur très peu d’hypothèses. Surtout, environ 80 % de cet effet transite uniquement par le canal des dépenses des étudiants, ce qui rend la dépense publique universitaire tout à fait singulière : l’université est le seul établissement public qui détermine la mobilité résidentielle de ses usagers, les étudiants, et les concentre durablement dans l’espace, conduisant à des effets économiques de proximité de grande ampleur, sans équivalent dans d’autres établissements publics.
Cet effet d’entraînement territorial unique mériterait d’être mieux pris en compte dans les arbitrages budgétaires sur le financement de l’enseignement supérieur et de la recherche.
Cet article est publié à l’occasion du Congrès 2026 de France Universités, autour de la question « Quel pacte universitaire pour la France de demain ? », organisé le 15 octobre 2026.

Yannick L’Horty a reçu des financements de l'ANR et de plusieurs agences publiques. Le programme In Situ est soutenu par L'initiative, qui réunit 6 universités lauréates I-Site.
Laetitia Challe a reçu des financements de l'ANR.
11.10.2026 à 08:50
Programmes déclarés « sérieux » ou « intenables » : rendre les hypothèses économiques discutables est un enjeu démocratique pour 2027
Kilian Rouge, Doctorant au CIRED, AgroParisTech – Université Paris-Saclay
Matthieu Bordenave, Doctorant MSCA en économie écologique, Università di Siena
Texte intégral (1748 mots)
L’ESSENTIEL
En 2027, les programmes économiques des candidates et candidats à la présidentielle seront chiffrés et comparés à l’aide de modèles macroéconomiques.
Ces modèles peuvent aboutir à des conclusions très différentes, sans que leurs hypothèses soient discutées publiquement.
L’enjeu est démocratique : avant même le débat politique, ces hypothèses déterminent ce qui paraîtra « sérieux » ou « intenable ».
En 2022 puis en 2024, deux modèles macroéconomiques appliqués à des programmes de gauche très proches concluaient, l’un à une hausse de la dette publique de plus de cinq points de PIB, l’autre à une baisse de dix points. L’écart tenait en grande partie aux modèles eux-mêmes et à leurs hypothèses, restées hors du débat. En 2027, les programmes présidentiels passeront à leur tour au crible de modèles macroéconomiques, et leurs hypothèses pèseront sur ce qui paraîtra « sérieux » ou « intenable ».
Concrètement, un modèle macroéconomique est une représentation de la réalité mettant en cohérence des informations telles que l’emploi, le produit intérieur brut ou l’inflation. Il peut servir à estimer les effets d’une réforme avant sa mise en œuvre, mais également à mieux comprendre les mécanismes économiques, à arbitrer entre objectifs contraires et à évaluer les incertitudes.
En France, ces outils sont mobilisés par les ministères, l’Insee, la Banque de France ou les laboratoires de recherche. Ces modèles macroéconomiques ne sont pas neutres. Des choix techniques orientent la manière dont les problèmes économiques sont appréhendés ; ils contribuent à définir le champ des politiques jugées possibles.
Nous avons consacré à ces outils un chapitre de la feuille de route remise au Conseil des droits de l’homme en juin 2026. Nous y montrons que les hypothèses retenues pour construire un modèle influencent ses résultats, alors même qu’elles restent largement absentes du débat public.
L’enjeu est démocratique : en amont des choix politiques, ces hypothèses décident déjà de ce qui paraîtra réaliste ou impossible.
Choix des modèles
« Tous les modèles sont faux, mais certains sont utiles », résumait le statisticien George Box. Un modèle isole certains mécanismes et écarte les autres. Ce qui importe est de comprendre ce que le modèle macroéconomique choisit de représenter et comment il le fait. Trois choix sont à prendre en compte :
Ce que le modèle représente
Un modèle ne produit de résultat que sur ce qu’il représente.
Par exemple, de nombreux modèles d’équilibre général utilisés en France réduisent l’ensemble des ménages et des entreprises à un agent représentatif, un « Français moyen ». Une réforme peut ainsi, à première vue, sembler bénéfique pour Monsieur ou Madame Tout-le-Monde, alors que ses effets sont en réalité très inégalement répartis entre les ménages riches et pauvres.
Comportement des Français et des Françaises
Les modèles macroéconomiques font des hypothèses sur la manière dont les ménages et les entreprises adaptent leurs comportements lorsque leur situation économique change.
De nombreux modèles utilisés pour la transition écologique supposent par exemple que la hausse du prix des énergies fossiles conduit les entreprises à leur substituer des énergies décarbonées. Cette réponse à l’évolution des prix dépend d’un paramètre fixé à l’avance appelé élasticité de substitution ; plus il est élevé, plus la transition paraît simple et bon marché.
Qui s’ajuste à qui ?
Les équations comptables ne suffisent pas à elles seules à déterminer l’ensemble des variables. Il faut décider quelles variables sont fixées et lesquelles doivent s’ajuster. C’est ce qu’on appelle la « clôture du modèle ».
Deux exemples : est-ce l’épargne disponible qui limite l’investissement, ou l’investissement qui crée ensuite l’épargne ? Les salaires s’ajustent-ils pour préserver l’emploi, ou sont-ils rigides ?
Ces règles déterminent qui supporte les effets d’un choc. Face à la même crise, un modèle fera baisser les salaires, un autre supprimera des emplois.
Le cas de la transition écologique
Prenons un exemple pour illustrer l’enjeu de ces hypothèses. Pour construire sa stratégie de neutralité carbone 2050, la Commission européenne évalue les mêmes scénarios – mêmes objectifs climatiques et mêmes montants d’investissement – avec plusieurs modèles :
L’un d’eux, GEM-E3, suppose par construction une économie sans ressource inemployée, où l’investissement dans la rénovation empêche l’investissement productif ailleurs. L’économie tourne déjà à plein régime : mobiliser des travailleurs et de l’argent pour la transition revient donc à les retirer à d’autres secteurs.
Un autre, E3ME, suppose au contraire l’existence de moyens inutilisés – chômeurs, et usines au ralenti – et que l’investissement peut être financé sans qu’une épargne préalable soit nécessaire. Dans ce cas, la même dépense permet de faire travailler des personnes qui étaient sans emploi ou d’utiliser des capacités de production qui restaient disponibles. Elle contribue à relancer l’activité sans réduire celle des autres secteurs.
En 2050, le PIB est inférieur de 1,3 % au scénario de référence avec le premier modèle, et supérieur de 2,2 % avec le second. Même scénario, deux verdicts opposés.
Aucun modèle n’est parfait
Il n’existe pas de modèle parfait. Chacun est plus ou moins adapté à la question posée. L’enjeu est de rendre explicites les hypothèses retenues et de permettre la confrontation des résultats obtenus.
Alors, comment rendre leur usage plus démocratique ?
Besoin de transparence
Les institutions tiendraient un inventaire public des modèles qu’elles emploient et indiqueraient lesquels ont servi à chaque évaluation. Chaque modèle serait documenté par une fiche standardisée précisant son type, son usage prévu, ses conditions de calibration, ses hypothèses structurantes et ses limites connues.
Besoin de pluralisme
L’évaluation gagnerait à s’appuyer sur au moins deux traditions de modélisation distinctes. Si le recours à un modèle unique peut se justifier par la comparabilité qu’il assure au cours du temps, cet avantage ne doit pas empêcher la confrontation à des modèles différents.
Ce type d’exercice existe déjà. C’est le cas des travaux de la plateforme intergouvernementale scientifique et politique sur la biodiversité et les services écosystémiques (IPBES) mobilisant treize modèles de nature très différente – modèles de processus écologiques, approches statistiques, évaluation des services écosystémiques – pour l’évaluation des tendances en matière de biodiversité et de services écosystémiques.
Décrypter la fabrique de l’expertise économique
Comme on l’a vu, un modèle n’informe que sur ce qu’il représente. Tout comme les modèles d’équilibre utilisés avant 2008 n’ont pas vu venir la crise, faute de représenter en détail le fonctionnement du secteur financier et la possibilité d’un défaut de paiement, un modèle où ne figurent ni la santé ni les inégalités ni l’état des écosystèmes ne peut pas dire si une politique les améliore ou les dégrade.
C’est au regard de ces dimensions qu’il faudrait évaluer la viabilité de la transition.
Documenter et confronter les modèles ne les rendra pas neutres ; ils ne peuvent pas l’être. Cela rendra leurs hypothèses lisibles et discutables. Derrière les chiffres se trouve toujours une certaine représentation de l’économie : la finance est-elle un simple intermédiaire ? Les inégalités freinent-elles la croissance ? Les limites écologiques transforment-elles le fonctionnement même de l’économie ?
Décrypter la fabrique de l’expertise économique, c’est lever le brouillard technique au profit du débat démocratique.

Matthieu Bordenave est membre de Ecohésion France.
Kilian Rouge ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
11.10.2026 à 08:50
« Dark kitchens » : comment les cuisines fantômes transforment nos villes et notre manière de manger
Khuong Nguyen Huy, Doctorant en Sciences de Gestion, Université Paris-Panthéon-Assas
Jean-Baptiste Welté, Professeur de Sciences de Gestion, Université Paris-Panthéon-Assas
Texte intégral (1547 mots)
L’ESSENTIEL
Cuisines sans salle ni vitrine, les « dark kitchens » prospèrent dans les grandes villes avec l’essor des plateformes de livraison.
Ces établissements suivent d’autres logiques d’implantation que les commerces traditionnels. La proximité des zones à livrer compte plus que la visibilité de la façade.
Ce basculement dépasse l’urbanisme. Il dissocie la préparation, la commande et la consommation du repas. Et interroge ce qu’il reste de la coprésence alimentaire.
Vous avez peut-être déjà commandé un repas de cuisine fantôme sans le savoir. On ne peut pas s’y attabler, il n’y a aucune salle à l’adresse indiquée sur l’application. Ni terrasse, ni vitrine, ni enseigne. Dans la rue, on passe sans le savoir devant ces restaurants invisibles, qui redessinent nos villes depuis plusieurs années.
On appelle ces établissements des « dark kitchens » ou « cuisines fantômes ». Le principe est simple : on y prépare des repas uniquement pour la livraison. Des commandes arrivent par écran. Les préparateurs s’activent aux fourneaux. Enfin, des livreurs viennent récupérer les sacs de nourriture et repartent aussitôt.
Phénomène international
La Direction générale de la concurrence, de la consommation et de la répression des fraudes (DGCCRF) a contrôlé 646 établissements proposant des plats livrés en 2023, dont 103 dark kitchens, confirmant l’installation de ce modèle dans le paysage français.
Des rapports montrent aussi l’ampleur du phénomène à l’étranger. En Angleterre, les dark kitchens représenteraient environ 15 % des points de vente alimentaires référencés sur les trois principales plateformes de livraison, selon une étude publiée en 2025. Au Brésil, une enquête menée dans trois grandes villes a classé 27,1 % des établissements analysés comme cuisines fantômes.
Cet essor dépasse les questions d’urbanisme. Il touche quelque chose de plus profond : ce que le repas perd quand il n’a plus besoin d’un lieu commun.
Où installer son restaurant ?
Dans le commerce de restauration traditionnel, l’emplacement compte avant toute chose. L’attractivité du quartier. La visibilité de la façade. Le passage piéton à proximité.
Mais quelle est la valeur de l’emplacement lorsque le client ne se déplace plus ? Pour une dark kitchen, la localisation compte toujours. Mais ses critères changent de nature. La visibilité de la façade compte moins. Ce qui importe, c’est la capacité à couvrir rapidement une zone de livraison dense.
À lire aussi : L’avenir de la gastronomie française ne se joue pas uniquement dans l’assiette
Un rapport de l’Assemblée nationale relève que l’implantation des dark kitchens dépend notamment de la densité de population et des conditions de desserte. L’Atelier parisien d’urbanisme observe quant à lui que ces établissements s’installent souvent dans d’anciens commerces ou restaurants, en rez-de-chaussée, au pied des immeubles parisiens. Certains s’implantent également dans des communes limitrophes, afin de bénéficier de surfaces plus importantes et d’une zone de livraison couvrant Paris et la proche banlieue.
Comment les dark kitchens transforment la rue
Une étude géographique publiée en 2025 confirme cette logique à plus large échelle. Les dark kitchens privilégient l’accessibilité logistique et les zones résidentielles denses plutôt que l’attractivité visuelle des rues. Leur implantation tient moins aux critères classiques du commerce. Elle s’explique surtout par la position dans les flux de livraison.
À lire aussi : De Byzance à nos tables : l’étonnante histoire de la fourchette, entre moqueries, scandales et châtiment divin
Concrètement, cela change la nature de la rue. Une dark kitchen peut fonctionner derrière une façade parfaitement discrète. Elle peut même sembler fermée. Pourtant l’activité y est bien réelle. Les commandes arrivent, la préparation se fait, les livreurs vont et viennent… La différence n’est donc pas entre une activité présente et une activité absente. Elle est entre une activité conçue pour être vue et une activité qui n’a plus besoin de l’être. Plus un restaurant devient visible sur un écran, moins il a besoin de l’être dans la rue.
Ce que le repas perd sur le chemin de la livraison
Cette réorganisation spatiale ne se fait pas sans conséquences sociales. Car les cuisines fantômes défont ce qui réunissait la préparation, la commande, le service et la consommation d’un repas. Des étapes qui étaient souvent réunies dans un même lieu, au même moment.
Le sociologue Claude Fischler a montré comment la commensalité (c’est-à-dire le fait de partager son repas avec d’autres personnes) participe aux relations sociales et aux formes de sociabilité. On peut prolonger cette réflexion par une question. Que devient la coprésence des convives quand la production, la commande et la consommation sont séparées dans l’espace ?
La dark kitchen contribue, à sa manière, à dissocier les différentes étapes du repas. La préparation se déroule dans une cuisine spécialisée. La commande passe par une interface numérique. Un livreur assure le déplacement physique du repas. La consommation a lieu ailleurs : dans un logement, un bureau ou n’importe quel espace privé.
Le repas circule ainsi entre plusieurs lieux et plusieurs étapes. Ce n’est pas seulement le restaurant qui perd sa localisation. C’est l’expérience synchrone et partagée du repas qui peut s’en trouver reconfigurée.
Isolement alimentaire
Faut-il pour autant accuser les dark kitchens d’avoir inventé l’isolement alimentaire ? Non, ce serait excessif. Le fait de manger seul fait, depuis longtemps, l’objet de recherches en sciences sociales. Des travaux consacrés au solo dining (le fait de manger seul au restaurant) montrent notamment que manger en solitaire ne signifie pas nécessairement rompre avec toute forme de sociabilité : cette pratique peut aussi donner lieu à de nouvelles formes de commensalité.
Plus largement, une revue de littérature a recensé 29 études consacrées aux liens entre solitude, isolement social et comportements alimentaires, confirmant que ces relations constituent désormais un objet de recherche bien identifié.
Les dark kitchens n’inventent rien. Elles offrent simplement à ces pratiques une infrastructure économique et spatiale sur mesure. Elles pourraient ainsi en accélérer la diffusion.
Une question qui dépasse chaque cuisine isolée
Le véritable enjeu concerne les collectivités publiques. Une dark kitchen isolée ne menace pas à elle seule la vie d’un quartier. Mais que se passe-t-il quand une part croissante de l’alimentation urbaine fonctionne sans jamais rassembler personne au même endroit au même moment ?
On peut alors se demander si la rue ne perd pas aussi une fonction plus discrète. Celle de mettre en présence, même brièvement, des personnes qui n’avaient pas prévu de se rencontrer.
D’autres aspects du phénomène méritent chacun un traitement à part. De la gestion des emballages aux conditions de travail des livreurs, le cadre réglementaire reste encore largement à construire.
L’essor des dark kitchens oblige à reconsidérer une évidence qu’on tenait pour acquise. Un repas n’est pas seulement une nourriture qu’on consomme. C’est un moment et un lieu partagés. Lorsque le restaurant cesse d’être un lieu où l’on se rend, c’est peut-être toute la fonction du repas dans la ville qu’il faut repenser.

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
11.10.2026 à 08:49
Les animes du studio Ghibli et la culture du riz au Japon
Marica Gambina, Doctorante en études cinématographiques, Université de Lille
Texte intégral (2365 mots)
L’ESSENTIEL
Motif récurrent du quotidien nippon, le riz s’impose comme un marqueur culturel par excellence de la société japonaise.
Princesse Mononoke et le Voyage de Chihiro, notamment, produits par Ghibli, illustrent avec précision la pratique de la riziculture et la façon dont on consomme le riz au Japon.
Du point de vue culturel, ces films d’animation japonais du célèbre studio fondé en 1985 par Hayao Miyazaki et Isao Takahata font déjà partie des classiques du genre.
Le riz représente l’un des symboles du Japon par excellence tant à l’intérieur du pays qu’à l’international. Arrivée dans l’archipel vers 350 avant notre ère., la culture de cette céréale remplace progressivement le mode de vie des chasseurs-cueilleurs jusqu’à s’imposer comme l’un des piliers de l’identité japonaise. L’anthropologue Emiko Ohnuki-Tierney le résume ainsi :
« La symbolique du riz est double : d’une part, “le riz, notre nourriture” et, d’autre part, “les rizières, notre terre”, ces deux aspects se renforçant mutuellement. »
Les animes constituent l’un des principaux produits d’exportation du Japon et véhiculent de nombreuses représentations du riz, offrant au public non nippon un aperçu de ses implications sociales ainsi que historiques et territoriales. Les animes du studio Ghibli, sans doute parmi les plus appréciés à l’échelle globale, illustrent largement le riz. À travers des scènes allant de sa culture à sa consommation, inscrites dans divers contextes historiques, les films du studio Ghibli permettent de saisir l’importance du riz dans la société nippone.
La rizière : contexte agricole et développement urbain
Dans les animes (dessin animé japonais, ndlr) Ghibli, le paysage japonais d’autrefois se présente souvent avec une verdure luxuriante qui recouvre les montagnes encadrant la rizière entre ses flancs. Cette image du territoire japonais est présente jusque dans Princesse Mononoké (Hayao Miyazaki, 1997), dont l’intrigue se déroule à l’époque Muromachi (1337-1573).
La rizière y est déjà présente, mais avec une forme plutôt arrondie et des dimensions irrégulières. Bien qu’elle soit encore éloignée du modèle rectangulaire et homogène qui s’imposera au Japon au fil des siècles, sa présence encadre déjà le territoire japonais, tout en renvoyant aux bouleversements explorés dans le film, notamment la déforestation liée au développement technique et agricole.
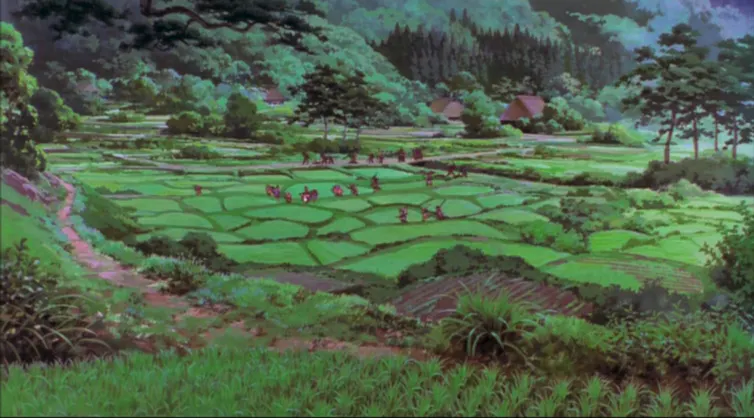
Dans Mon voisin Totoro (Hayao Miyazaki, 1988), la rizière, en harmonie avec la forêt, est l’un des éléments fondamentaux de la représentation de l’univers narratif. Elle ne s’inscrit pas parmi les éléments perturbateurs du milieu naturel ; au contraire, elle participe à la description du paysage rural de la région de Tokyo dans les années 1950. Dans le film, cet espace rural, dernier témoignage de la vie traditionnelle nippone face au Japon de l’après-guerre en plaine modernisation, apparaît déjà profondément distinct de la ville, qui s’étendra et gagnera la campagne au cours des décennies suivantes.
La course à l’urbanisation pendant la Haute Croissance est au cœur de la narration dans Pompoko (Isao Takahata, 1994), où le paysage idyllique des rizières encadrées par les montagnes s’impose comme l’objet du désir, non pas des humains, mais des animaux menacés par l’expansion immobilière des années 1960.
Ce contexte rural constitue également un refuge pour les salariés qui quittent la grande ville. Dans Souvenirs goutte à goutte (Isao Takahata, 1991), il s’agit en effet d’échapper à une vie stable, mais dépourvue de passion, au profit d’un travail exigeant dans les champs, où le riz est cultivé selon des méthodes traditionnelles, les bottes et les mains plongées dans le fond aqueux de la rizière.
La préparation du riz et les changements alimentaires
La préparation du riz dans la Colline aux coquelicots (Gorō Miyazaki, 2011) intervient quelques secondes après le début du film, lors de la préparation du petit-déjeuner. Dans ce film, qui se déroule dans les Japon des années 1960, le riz apparaît immergé et vraisemblablement déjà lavé dans un donabe, cuiseur à riz traditionnel en terre cuite munie d’un couvercle en bois. Très présent dans les images des animes Ghibli, le donabe traditionnel renvoie non seulement au rituel quotidien de préparation du riz, mais également à l’omniprésence de cette céréale dans les repas, dont elle constitue un élément indispensable.
Les films Ghibli montrent également le remplacement progressif du donabe traditionnel par le rice cooker électrique ; ne relevant pas uniquement du progrès technique et du miracle économique nippon, sa présence témoigne également de l’évolution des habitudes alimentaires japonaise. En effet, le cuiseur électrique est souvent accompagné de produits alimentaires industriels – eux-mêmes issus du modèle d’importation conséquent au miracle économique – tels que le pain de mie et toute sorte de snacks et de boissons.
Le petit-déjeuner de la protagoniste de Si tu tends l’oreille (Yoshifumi Kondō, 1995), composé de pain industriel et dépourvu du traditionnel bol de riz, s’inscrit dans ces transformations des habitudes quotidiennes, comme le montre la présence du carton de lait (milk) à l’arrière-plan, qui témoigne de l’évolution de l’alimentation japonaise au XXᵉ siècle.
Cependant, les repas familiaux continuent d’inclure la préparation du riz. Par ailleurs, la distribution du riz par la mère, principale responsable du foyer, relève des coutumes sociales, puisqu’elle reflète la hiérarchie familiale.
Manger le riz : survie et identité
Dans le Tombeau des lucioles (Isao Takahata, 1988), la possibilité de consommer du riz détermine la survie des protagonistes dans le Japon vaincu de la fin de la Seconde Guerre mondiale. Les précieux kimonos de la mère des protagonistes deviennent alors la monnaie d’échange permettant de se procurer cet aliment humble et essentiel, nécessaire à la survie.
Cependant, le riz, le bien japonais par excellence, est lui-même rationné au sein du foyer : en raison de ses qualités nutritionnelles, il est réservé aux travailleurs de la nation qui, en contribuant au bien de la patrie, y ont davantage droit que les enfants.
Dans le Voyage de Chihiro (Hayao Miyazaki, 2001), les bols de riz constituent le repas des travailleurs du palais des bains de Yubaba. Miyazaki souligne ainsi la différence entre les mets de luxe souvent riches en protéines animales destinés aux kamis, les divinités clientes de Yubaba, et ceux réservés à la main-d’œuvre.
Toutefois, le riz est également l’un des éléments centraux de l’une des scènes les plus iconiques du film. Bouleversée par son arrivée dans ce monde parallèle au sien, où ses parents sont transformés en cochons, Chihiro perd son identité : en l’embauchant, Yubaba lui vole son prénom.
Son seul allié dans ce monde étranger est le dragon Haku, qu’elle retrouve en privé, à l’abri des massifs floraux. Le dragon la rassure en lui remettant des objets qui lui rappellent son identité, ainsi que des onigiris enchantés. Tout en dévorant les onigiris préparés par Haku, Chihiro fond en larmes.
Encas extrêmement simples, les onigiris que mange Chihiro sont des boulettes de riz triangulaires. L’enchantement de ces onigiris réside dans leur préparation manuelle, fondée sur le rituel préalable du lavage et de la cuisson du riz.
Destinés à réconforter Chihiro, ils dépassent ainsi la simple fonction alimentaire ; leur préparation ne relève pas seulement de l’acte culinaire, mais s’apparente à un geste d’amour. La simplicité de cet encas, dépourvu de toute sophistication de la matière, associée au don des objets personnels, contribue à raviver l’identité perdue de Chihiro par le biais du riz lui-même.
En effet, ces onigiris ne se limitent pas à leur statut de plat traditionnel ; leurs grains de riz évoquent le paysage natal – et idéalisé – des rizières, les efforts nécessaires pour se procurer un bol de riz pendant la guerre, le donabe (ou rice cooker) des repas familiaux… Les larmes de Chihiro coulent, car ces onigiris la ramènent symboliquement chez elle, au cœur d’un monde étranger.
Cet article est publié dans le cadre de la Fête de la science (qui a eu lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Marica Gambina ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
09.10.2026 à 17:07
Navi Pillay, prix Nobel de la paix 2026 : le droit international contre la loi du plus fort
Chloé Maurel, SIRICE (Université Paris 1/Paris IV), Université Paris 1 Panthéon-Sorbonne
Texte intégral (2129 mots)
L’ESSENTIEL
En récompensant Navi Pillay, ancienne Haut-Commissaire des Nations unies aux droits de l’homme et figure majeure de la justice pénale internationale, le comité Nobel place la défense des victimes et la responsabilité des États au cœur de la conception de la paix.
Ce choix est particulièrement significatif à l’heure où les institutions multilatérales sont fragilisées et où les crimes internationaux restent largement impunis.
Cette décision peut aussi être lue comme un désaveu infligé à Donald Trump, qui avait, comme l’année dernière, affirmé que le prix devait lui revenir.
Ce 9 octobre 2026, à Oslo, le Comité Nobel norvégien a attribué le prix Nobel de la paix à Navanethem « Navi » Pillay, juriste sud-africaine de 85 ans, pour son engagement en faveur de la paix et du droit international. Le président du comité, Jørgen Watne Frydnes, a salué un parcours consacré à faire répondre les États et leurs dirigeants de leurs actes, ainsi qu’à redonner espoir aux victimes de violences et de conflits. Le comité souligne notamment la contribution de la lauréate à la consolidation d’un ordre juridique international capable de poursuivre les crimes de guerre, les crimes contre l’humanité et le génocide.
Cette distinction dépasse largement la consécration d’une carrière individuelle. Elle pose une question centrale de science politique : comment construire la paix lorsque les rapports de force militaires, les intérêts nationaux et les calculs des grandes puissances tendent à l’emporter sur les règles communes ?
En distinguant Navi Pillay, le comité rappelle que la paix ne se réduit ni à l’arrêt momentané des combats ni à la conclusion d’accords entre dirigeants. Elle suppose aussi la justice, la reconnaissance des victimes et l’existence de mécanismes permettant de sanctionner les responsables de crimes. Le comité Nobel met ainsi en valeur les principes du droit international portés par l’ONU, laquelle n’a d’ailleurs pas manqué de se féliciter rapidement de l’attribution de la récompense à l’une de ses anciennes responsables.
Une juriste née sous l’apartheid, figure de la justice internationale
Née le 23 septembre 1941 à Durban, dans une famille sud-africaine d’origine tamoule indienne, Navi Pillay grandit sous le régime d’apartheid institutionnalisé à partir de 1948. La ségrégation raciale organise alors l’accès au logement, à l’éducation, à l’emploi et à la représentation politique. Issue d’une communauté soumise à de multiples discriminations, elle parvient à entreprendre des études de droit et à devenir avocate.
En 1967, elle ouvre le premier cabinet d’avocats dirigé par une femme dans la province du Natal. Dans l’exercice de son métier, elle défend des opposants à l’apartheid, dans un contexte où les militants politiques, les organisations de résistance et leurs soutiens sont exposés à la répression. Elle s’engage à la fois pour l’accès des femmes à des professions judiciaires dominées par les hommes, et pour la défense des droits face à un État raciste et ségrégationniste.
La transition démocratique sud-africaine, engagée au début des années 1990 et consacrée par les élections multiraciales de 1994, ouvre une nouvelle séquence. En 1995, elle est la première femme de couleur à siéger à la Haute Cour sud-africaine. Et en mai 1995, elle devient juge au Tribunal pénal international pour le Rwanda (TPIR), créé par le Conseil de sécurité de l’ONU en novembre 1994, après le génocide des Tutsis qui a fait environ 800 000 morts. Par la jurisprudence qu’elle initie, elle contribue à faire reconnaître le viol de guerre comme un instrument possible de destruction collective.
Pillay préside ensuite le TPIR de 1999 à 2003. Elle rejoint la Cour pénale internationale (CPI), à La Haye, en 2003, avant d’être nommée Haut-Commissaire des Nations unies aux droits de l’homme en 2008. Elle occupe cette fonction jusqu’en 2014. À ce poste, elle défend l’universalité des droits humains, y compris lorsque leur protection implique de mettre en cause des gouvernements puissants.
Son itinéraire donne ainsi une cohérence particulière à la distinction de 2026 : de la lutte contre l’apartheid aux tribunaux internationaux, la justice apparaît, avec ce prix, comme une condition de la paix durable, conformément aux principes de l’ONU.
Le Nobel de la paix : une procédure indépendante, pas un concours de popularité
Attribué depuis 1901, le prix Nobel de la paix répond à une logique particulière. Dans son testament de 1895, Alfred Nobel confie la désignation du lauréat à un comité de cinq personnes choisies par le Parlement norvégien, le Storting. Ce Comité Nobel norvégien est distinct des institutions suédoises chargées des autres prix Nobel.
Le processus de sélection s’étend sur plusieurs mois. Les candidatures doivent être soumises avant le 31 janvier. Seules certaines catégories de personnes sont habilitées à proposer des noms : parlementaires et ministres, chefs d’État, universitaires répondant aux critères, anciens lauréats ou membres du comité, notamment. Il n’est pas possible de se porter soi-même candidat. En 2026, le comité a enregistré 287 candidatures : 208 personnes et 79 organisations. La tendance récente, et louable, est en effet d’attribuer le prix à des organisations plutôt qu’à une seule personne, afin de valoriser l’engagement collectif. Ainsi, dernièrement, le prix a été attribué en 2017 à la Campagne internationale pour l’abolition des armes nucléaires (connue sous son sigle anglais ICAN), en 2020 au Programme alimentaire mondial (PAM) et en 2022 à deux ONG (une ukrainienne et une russe), ainsi qu’au chef emprisonné d’une troisième ONG, bélarusse.
À lire aussi : Des médecins militant pour la prévention de la guerre nucléaire : l’IPPNW et son double prix Nobel de la paix
Après vérification de leur validité, les propositions sont examinées par les cinq membres du comité, qui établissent une liste restreinte. Des experts norvégiens et internationaux peuvent être sollicités pour éclairer les dossiers. Les délibérations se poursuivent jusqu’à la décision finale, généralement prise entre la fin de l’été et le début de l’automne. Le consensus est recherché, mais une majorité simple suffit. Les noms des candidats et les documents relatifs aux délibérations demeurent confidentiels pendant cinquante ans.
Pillay et le rapport sur le génocide à Gaza : un engagement aux implications géopolitiques immédiates
L’histoire du Nobel de la paix montre que ses choix ne sont pas exempts de controverses. L’attribution du prix à Henry Kissinger en 1973 avait provoqué de vives critiques. Des polémiques ont également accompagné les choix de Barack Obama en 2009, de l’Union européenne en 2012, du premier ministre éthiopien Abyi Ahmed en 2019 ou encore de la Vénézuélienne Corina Machado l’année dernière, opposante d’extrême droite et ultra-libérale (qui a dédié son prix à Donald Trump) – liste non exhaustive.
À lire aussi : Les prix Nobel de la paix controversés, signe d’une réforme nécessaire ?
La désignation de Navi Pillay, elle aussi, ne manquera pas de faire grincer des dents chez les plus réactionnaires. Donald Trump, ennemi de longue date des institutions de la justice internationale, avait fait de l’obtention du Nobel de la Paix un objectif politique affiché, se vantant encore le 7 octobre 2026 d’avoir « mis fin à huit guerres ». Mais en multipliant les atteintes aux droits fondamentaux aux États-Unis, tout en défendant à l’international une politique de puissance unilatérale qui va à l’encontre du droit international, que ce soit vis-à-vis du Venezuela ou de l’Iran, il ne pouvait raisonnablement prétendre au Nobel de la Paix.
L’attribution du prix a déjà fait réagir avec véhémence le gouvernement de Benyamin Nétanyahou.
En effet, de 2021 à novembre 2025, Navi Pillay a présidé la Commission internationale indépendante d’enquête des Nations unies sur le Territoire palestinien occupé, qui a publié en septembre 2025 un rapport (immédiatement rejeté par Tel-Aviv, mais aussi par Washington) concluant qu’un génocide avait été commis à Gaza et que certains hauts responsables israéliens en portaient la responsabilité.
En tout état de cause, le Nobel attribué à celle qui a été, quatre ans durant, présidente de cette commission (dirigée désormais par le juriste indien Srinivasan Muralidhar) confère une visibilité supplémentaire au travail d’établissement des faits et à la protection des civils de Gaza. Il vise à rappeler que le droit international humanitaire et la Convention de 1948 pour la prévention et la répression du crime de génocide ne peuvent être appliqués à géométrie variable selon l’identité des auteurs présumés ou leurs alliances stratégiques.
À lire aussi : Génocide à Gaza : le mot et la chose
Un signal adressé aux grandes puissances et aux institutions multilatérales
Le choix de Navi Pillay s’inscrit dans un contexte de crise de l’ordre international. Son parcours rappelle que les institutions juridiques internationales, et notamment celles de l’ONU, constituent des espaces où des victimes peuvent faire reconnaître leurs droits, où les faits sont consignés et où les dirigeants peuvent être confrontés à des obligations qui dépassent leurs intérêts immédiats.
Soulignons également que cette récompense, la quatrième pour l’Afrique du Sud après Albert John Luthuli (1960), Desmond Tutu (1984) et le « duo » Nelson Mandela/Frederik De Klerk (1993), est la 21ᵉ attribuée à une femme, sur 113 personnes lauréates, soit moins d’un cinquième.
En distinguant une juriste qui a consacré sa vie à la lutte contre l’apartheid, aux poursuites des crimes internationaux et à la défense des droits humains, dans un monde où des dirigeants souvent autoritaires et unilatéralistes revendiquent volontiers le mérite des accords conclus par la force, le Comité Nobel rappelle que la paix se mesure aussi à la capacité collective des sociétés à faire respecter des règles communes et démocratiques, conformes au droit international – quand bien même cette notion et ses interprétations demeurent parfois controversées, comme le montrent certaines des premières réactions à l’annonce de l’identité de la lauréate…

Chloé Maurel ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
09.10.2026 à 16:30
Pourquoi les universités américaines remettent en question leur examen d’entrée historique
Beth Kania-Gosche, Professor of Education, Missouri University of Science and Technology
Texte intégral (2209 mots)
L’ESSENTIEL
Créé en 1926, le SAT, un examen standardisé, a révolutionné l’accès aux universités américaines en uniformisant les examens d’entrée.
Ses résultats restent très liés à l’origine sociale des élèves, ce qui alimente les critiques sur son équité.
Devenu facultatif dans la majorité des universités, le SAT reste un passage incontournable pour de nombreux lycéens.
En juin 1926, le SAT, un examen standardisé américain d’admission à l’université, était organisé pour la première fois. Quelque 8 000 lycéens y participaient, dans l’espoir d’intégrer les universités les plus prestigieuses.
Depuis sa création, il y a cent ans, le SAT a connu de nombreuses évolutions, tant dans ses modalités d’organisation que dans les matières et les connaissances évaluées.
Un tournant majeur s’est produit autour de l’an 2000, lorsque quelque 280 établissements d’enseignement supérieur ont commencé à autoriser les candidats à postuler sans fournir leurs résultats au SAT ou à l’ACT, un autre examen standardisé couramment utilisé. Aujourd’hui, environ 86 % des universités et établissements d’enseignement supérieur américains n’exigent plus ces résultats pour examiner les candidatures.
La question de savoir si le SAT évalue fidèlement les capacités scolaires des élèves continue de faire débat. Certaines recherches montrent que cet examen constitue un bon indicateur de leurs compétences, de leurs connaissances et de leurs chances de réussite dans l’enseignement supérieur.
D’autres recherches mettent en évidence les failles fondamentales du SAT et de l’ACT, notamment le fait que les élèves issus de familles aisées obtiennent généralement de meilleurs résultats au SAT. Il faut dire que passer cet examen est payant et que les familles les plus favorisées peuvent financer des cours particuliers et des préparations spécifiques. Leurs enfants fréquentent aussi généralement des lycées publics ou privés disposant de moyens importants.
En tant que professeure en sciences de l’éducation, je considère qu’il est essentiel de connaître l’histoire du SAT pour comprendre les débats actuels autour de cet examen.
Un nouveau type d’examen
Le SAT a été conçu dans les années 1920 par le College Board, un organisme fondé en 1900 par les présidents de douze grandes universités américaines afin d’harmoniser les procédures d’admission dans l’enseignement supérieur. À l’époque, chaque université possédait son propre examen d’entrée. Ces épreuves prenaient la forme de dissertations, rédigées par les candidats puis corrigées et notées par des professeurs.
En 1926, un examen SAT identique pour tous les candidats a été utilisé pour la première fois. Il comportait 315 questions auxquelles les élèves devaient répondre en 97 minutes, soit environ 18 secondes par question. Il n’était toutefois pas attendu qu’ils répondent à toutes les questions.
L’examen initial comprenait neuf sections, dont certaines ressemblent à celles que passent encore les élèves aujourd’hui, notamment la compréhension de textes et l’arithmétique. D’autres ont en revanche disparu, comme l’épreuve de langue artificielle. Celle-ci consistait à construire des phrases codées en respectant un ensemble de règles complexes, par exemple : « Le pluriel se forme en ajoutant -o. »
En 1928 et 1929, puis de 1936 à 1941, le SAT ne comportait aucune question de mathématiques. Entre 1930 et 1935, les questions de mathématiques étaient toutes à réponse libre, et non à choix multiples, contrairement à ce qui se pratique généralement aujourd’hui. À l’époque, le SAT représentait une véritable révolution : il rompait avec les examens sous forme de dissertations, dont les sujets et les questions étaient définis par les professeurs de chaque université.
Les questions à choix multiples ou à trous pouvaient être corrigées rapidement et de manière objective. Les lycéens n’avaient plus besoin de se rendre sur un campus universitaire pour passer un examen d’entrée. Grâce au SAT, des milliers d’élèves pouvaient désormais passer la même épreuve près de chez eux, sans avoir à supporter les contraintes d’un déplacement jusqu’à l’université.
Les résultats pouvaient être examinés par plusieurs universités, et non plus par une seule. Le SAT a ainsi renforcé la concurrence entre les candidats tout en élargissant les possibilités d’accès à l’enseignement supérieur. Mais toutes les universités, ni même tous les enseignants du secondaire, n’ont accueilli favorablement cette innovation. Certains craignaient notamment que le contenu de l’examen finisse par dicter les programmes scolaires des lycées.
À cette époque, le SAT restait toutefois relativement peu utilisé : à la fin des années 1930 et au début des années 1940, seuls 10 000 élèves environ le passaient chaque année.
En 1947, l’Educational Testing Service (ETS), un organisme privé à but non lucratif spécialisé dans les examens et la recherche en éducation, a été créé pour organiser le SAT et concevoir d’autres épreuves. Cet organisme avait tout intérêt à promouvoir le SAT auprès des établissements d’enseignement supérieur, ce qui a contribué à sa généralisation.
Le SAT s’impose progressivement
Au lendemain de la Seconde Guerre mondiale, les universités américaines ont enregistré une forte hausse des candidatures, notamment grâce au GI Bill. Ce programme gouvernemental accordait aux anciens combattants des aides financières et des avantages pour poursuivre leurs études.
Face à cet afflux de candidats, les universités ont commencé à durcir leurs critères d’admission et à s’appuyer davantage sur les résultats du SAT pour sélectionner les étudiants.
En 1960, le système des universités de Californie est devenu le premier grand réseau d’universités publiques à rendre le SAT obligatoire. C’est également cette année-là qu’a été créé l’ACT. Au cours des décennies suivantes, de plus en plus d’établissements ont intégré le SAT parmi leurs critères habituels d’admission.
Pour limiter l’avantage que pouvaient procurer les cours particuliers, les concepteurs du SAT ont également allongé la durée de l’examen et remanié les questions.
En 1994, une nouvelle évolution a marqué l’histoire du SAT : pour la première fois, les candidats ont été autorisés à utiliser une calculatrice pendant l’examen.
Bien plus qu’un simple examen
Passer le SAT ou l’ACT représente un enjeu majeur pour les élèves. Non seulement leurs résultats peuvent déterminer leur admission à l’université, mais une amélioration de seulement 50 à 100 points peut aussi leur permettre d’obtenir plusieurs milliers de dollars de bourses d’études.
Les écarts de résultats au SAT entre les différents groupes raciaux sont largement documentés et font l’objet de débats depuis des décennies.
Les élèves d’origine asiatique obtiennent en moyenne les meilleurs résultats au SAT, devant les élèves blancs Les élèves issus de familles aisées ont 13 fois plus de chances que ceux des milieux modestes d’obtenir au moins 1 300 points au SAT, sur un maximum de 1 600.
Certaines recherches mettent en évidence un lien entre les revenus familiaux, les résultats aux examens et la réussite universitaire, cette dernière étant mesurée à partir des notes obtenues, de la poursuite des études et de l’obtention du diplôme.
D’autres recherches montrent que les notes obtenues au lycée permettent de mieux prédire la réussite à l’université que les résultats au SAT.
Les universités remettent en question le SAT
Face aux interrogations sur l’utilité du SAT dans la sélection des étudiants, quelque 280 universités et établissements d’enseignement supérieur ont décidé, autour de l’an 2000, de rendre cet examen facultatif dans leurs procédures d’admission.
Le début de la pandémie de Covid-19, en 2020, a constitué une expérience grandeur nature pour les admissions sans examen standardisé obligatoire. Les risques de transmission du virus empêchaient tout simplement les élèves de passer le SAT. Résultat : en 2020 et 2021, presque aucune université n’exigeait de résultats au SAT ou à l’ACT pour examiner les candidatures.
Six ans plus tard, plus de 2 000 universités et établissements d’enseignement supérieur n’exigent toujours pas le SAT pour examiner les candidatures. Mais cette classification peut être trompeuse, car l’obtention de certaines bourses peut rester conditionnée aux résultats de cet examen.
En 2025, plus de deux millions d’élèves, soit environ 47 % des lycéens en dernière année, ont passé le SAT. C’est le chiffre le plus élevé enregistré depuis le début de la pandémie. La même année, 36 % des lycéens, soit 1,38 million d’élèves, ont passé l’ACT.
Un rite de passage pour les lycéens
Le SAT continue d’évoluer. En 2024, sa durée a été ramenée de trois heures à deux heures et quinze minutes. L’examen se rapproche ainsi de sa durée initiale, il y a cent ans, qui était de 97 minutes. Toujours en 2024, le SAT est devenu entièrement numérique.
Aujourd'hui, cet examen ne reflète pas parfaitement le potentiel et les compétences des élèves, mais il reste un rite de passage pour la plupart des lycéens américains qui envisagent de poursuivre leurs études à l’université.

Beth Kania-Gosche a bénéficié de financements de la National Science Foundation (Fondation nationale pour la science). Elle est présidente de la Missouri Association of Colleges for Teacher Education (Association des établissements d’enseignement supérieur du Missouri pour la formation des enseignants).
09.10.2026 à 16:30
À quoi pourrait ressembler une journée à l’école en 2035 ?
Guillermo José Navarro del Toro, Research Professor at the University of Guadalajara - Centro Universitario de Los Altos, Universidad de Guadalajara, Universidad de Guadalajara
Texte intégral (1780 mots)
L’ESSENTIEL
En 2035, l’intelligence artificielle et les technologies immersives pourraient transformer profondément les façons d’apprendre.
Les examens traditionnels laisseraient alors place à des projets collaboratifs et à une évaluation continue des compétences.
On peut imaginer que les enseignants resteraient essentiels, mais leur rôle évoluerait vers l’accompagnement personnalisé et le développement de l’esprit critique.
Nous vivons dans un monde où l’intelligence artificielle dialogue avec les élèves, où les examens ont cédé la place à des défis concrets et où les salles de classe n’ont plus de murs. Face à ces transformations, une question se pose : à quoi ressemblera l’école dans dix ans ? Cet article explore les évolutions déjà à l’œuvre aujourd’hui qui dessinent l’avenir de l’éducation.
Apprendre sans aller en classe
Imaginez qu’une journée d’école ordinaire ne commence plus par un réveil matinal, un trajet en bus et une place derrière un bureau. À la place, vous enfilez des lunettes de réalité augmentée ou vous vous connectez à une plateforme immersive depuis chez vous, un parc ou même un autre pays.
Les technologies de réalité virtuelle (VR) et de réalité augmentée (AR) permettent aux élèves d’explorer un volcan en éruption ou de parcourir les rues de la Rome antique sans quitter leur chaise. En 2035, apprendre ne se résumera plus à rester entre quatre murs : il s’agira d’explorer, de construire, de collaborer et d’expérimenter.
Et si le professeur était une IA ?
Loin de relever de la science-fiction, il existe aujourd’hui des outils d’intelligence artificielle comme Khanmigo de la Khan Academy, lauréate du prix Princesse des Asturies de la coopération internationale en 2019, ou encore ChatGPT, capables de dialoguer avec les élèves, de répondre à leurs questions et même de concevoir des exercices sur mesure.
Dans un avenir proche, ces IA joueront le rôle de tuteurs personnels. Elles connaîtront si bien chaque élève qu’elles pourront adapter les contenus à son rythme, à sa manière d’apprendre et à ses centres d’intérêt. Mais elles ne remplaceront pas les enseignants. Au contraire, elles leur permettront de consacrer davantage de temps à l’essentiel : accompagner les élèves sur le plan émotionnel, développer leur esprit critique et les aider à trouver leur propre voix.
Des projets concrets plutôt que des examens
Beaucoup d’élèves rêvent d’un monde sans examens. Ce rêve pourrait devenir réalité plus tôt qu’on ne le pense. Les exercices traditionnels cèdent progressivement la place à des projets ancrés dans le monde réel, où l’on apprend en résolvant des problèmes concrets : concevoir un système de recyclage à l’échelle d’un quartier, développer une application accessible à tous ou améliorer l’alimentation à la cantine scolaire.
L’évaluation ne reposera plus sur une épreuve sanctionnée par une note finale, mais sur un suivi continu des apprentissages, à travers des portfolios numériques, des retours en temps réel et une réflexion personnelle sur les progrès accomplis.
Le nouveau rôle des enseignants
En 2035, les enseignants resteront indispensables, mais leur rôle ne consistera plus simplement à transmettre des connaissances. Ils concevront des expériences d’apprentissage, stimuleront la réflexion et accompagneront le développement des compétences humaines.
Des initiatives comme Education Reimagined ou HundrED contribuent déjà à cette transformation. Ces plateformes mettent les enseignants en relation et montrent comment créer des environnements d’apprentissage plus humains, plus inclusifs et plus enrichissants.
Apprendre tout au long de la vie
La plus grande révolution sera peut-être que l’éducation ne constituera plus une étape de la vie qui s’achève un jour. Apprendre fera partie intégrante de notre vie d’adulte, aussi bien professionnelle que personnelle. Nos parcours de formation seront plus souples et s’adapteront à nos évolutions, à nos métiers et à nos passions.
Des institutions comme l’Organisation de coopération et de développement économiques (OCDE) encouragent déjà la reconnaissance des apprentissages tout au long de la vie, y compris en dehors des établissements d’enseignement traditionnels.
L’école de demain est déjà en train de se construire. Et son avenir ne dépend pas seulement de la technologie, mais aussi de la manière dont nous choisirons d’éduquer, d’accompagner et de former les nouvelles générations. Car même si les formes d’enseignement évoluent, l’objectif reste le même : apprendre à être humain dans un monde toujours plus complexe.
Une journée dans la vie de Luna, élève en 2035
À quoi ressemble une journée d’école dans le futur ? Prenons l’exemple de Luna, une élève de 14 ans en 2035.
Luna se réveille à 7 h 30, non pas au son d’une alarme, mais grâce à son assistant personnel d’intelligence artificielle, AURA, qui lui rappelle en douceur son programme de la journée. Elle n’a pas besoin de se rendre dans un établissement scolaire : sa salle de classe est dans le cloud.
Pendant son petit-déjeuner, elle consulte l’avancement de son projet collaboratif international sur les microplastiques dans les océans. Elle travaille avec trois autres élèves, en Argentine, au Japon et en Afrique du Sud. Aujourd’hui, ils ont prévu une séance immersive en réalité augmentée avec Dreamscape pour observer en temps réel les effets des déchets sur la vie marine.
Dreamscape Learn est une plateforme éducative innovante qui associe narration cinématographique et technologies immersives pour transformer les méthodes d’enseignement et d’apprentissage. Grâce à des expériences interactives fondées sur le storytelling, les élèves sont plongés dans des univers virtuels où ils doivent résoudre des problèmes concrets au sein de scénarios captivants. Cette approche ne se contente pas de retenir leur attention et d’éveiller leur curiosité : elle développe également des compétences essentielles comme l’esprit critique, la collaboration et la prise de décision. En créant un lien émotionnel avec les contenus pédagogiques, elle favorise un apprentissage plus approfondi et durable.
À 9 heures, Luna enfile ses lunettes de réalité augmentée de Labster et se connecte à une simulation qui l’emmène au fond de l’océan. Grâce à l’intelligence artificielle intégrée, elle peut dialoguer avec des scientifiques virtuels, formuler des hypothèses et tester des solutions, comme de nouveaux matériaux biodégradables.
Ensuite, au lieu de passer un examen, elle enregistre une vidéo dans laquelle elle présente la solution qu’elle propose. Son enseignante, qui joue auprès d’elle un rôle de mentor, lui apporte des conseils sur le plan pédagogique et émotionnel. L’IA analyse également sa vidéo et lui suggère des améliorations concernant la qualité de son raisonnement critique, la clarté de son propos et les sources utilisées.
En milieu d’après-midi, Luna assiste à un cours d’éthique numérique, au cours duquel elle débat avec son groupe des implications de la création d’intelligences artificielles capables d’éprouver des émotions. Elle termine sa journée en programmant un assistant écologique destiné à aider les personnes âgées, grâce à la plateforme collaborative Global Nomads, à réduire leur consommation d’énergie.
Un avenir éducatif à portée de main
L’histoire de Luna, bien qu’elle se déroule dans un futur qui semble encore lointain, n’a rien d’une fantaisie : elle reflète des évolutions déjà à l’œuvre aujourd’hui. Les outils qui accompagnent ses apprentissages, comme l’intelligence artificielle adaptative, la réalité augmentée, la réalité virtuelle et les plateformes de collaboration internationale, ne relèvent pas de la science-fiction. Ils existent déjà et sont en train de révolutionner l’éducation.
Des plateformes comme Dreamscape Learn associent des récits immersifs à la réalité virtuelle pour stimuler l’esprit critique et encourager l’exploration active. Labster permet aux élèves du monde entier d’accéder à des laboratoires virtuels où ils peuvent expérimenter sans risque ni contraintes matérielles. Global Nomads met en relation des jeunes d’horizons différents afin de favoriser le dialogue interculturel et l’empathie à l’échelle mondiale.
Ce que vit Luna dessine un avenir de l’éducation qui est déjà à notre portée. Son histoire est en réalité un appel à agir sans attendre : innover, transformer les salles de classe et préparer les nouvelles générations. Non pas au monde d’hier, mais à celui qui se construit déjà sous nos yeux.

Guillermo José Navarro del Toro ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
09.10.2026 à 16:29
Quel rôle le collège et le lycée jouent-ils dans la santé mentale des élèves ? Une étude australienne lève un coin du voile
Sarah Stevens, Postdoctoral Research Fellow in Adolescent Mental Health at the Black Dog Institute, UNSW
Aliza Werner-Seidler, Professor and Program Lead in Adolescent Mental Health at the Black Dog Institute; Clinical Psychologist, UNSW
Texte intégral (1570 mots)
L’ESSENTIEL
Une étude australienne a suivi plus de 1 500 élèves de 35 établissements secondaires.
Le sentiment d’appartenance du collégien à la communauté scolaire est associé à un meilleur bien-être psychologique deux ans plus tard.
Les relations avec les camarades et les personnels scolaires semblent compter davantage que la taille des classes ou le statut de l’établissement.
À 15 ans, un élève australien a déjà passé jusqu’à 11 000 heures à l’école.
C’est dans ce cadre que se déroulent de nombreuses expériences déterminantes pour son développement social et émotionnel. D’où un intérêt croissant pour les caractéristiques de l’environnement scolaire qui influencent le plus la santé mentale et le bien-être des élèves.
Le sentiment d’appartenance à la communauté scolaire, c’est-à-dire la mesure dans laquelle les élèves se sentent intégrés et liés aux autres membres de leur établissement, suscite un intérêt croissant chez les professionnels de l’éducation et les chercheurs.
Ce sentiment repose sur les relations que les élèves entretiennent avec leurs camarades, mais aussi avec les enseignants et les autres membres du personnel scolaire, comme les entraîneurs sportifs, les psychologues scolaires ou les agents d’accueil.
Un fort sentiment d’appartenance à la communauté scolaire est associé à plusieurs effets positifs, notamment de meilleurs résultats scolaires et moins de comportements agressifs, dont le harcèlement.
Mais, comme le montre notre nouvelle étude, de plus en plus de travaux suggèrent que ce sentiment d’appartenance pourrait également jouer un rôle essentiel dans le bien-être des élèves.
Notre étude
Dans une nouvelle étude menée au Black Dog Institute, nous avons examiné différents facteurs liés à l’environnement scolaire afin de déterminer lesquels avaient le plus d’influence sur la santé mentale et le bien-être des élèves.
Parmi les facteurs étudiés figuraient la localisation des établissements, leur statut (public ou privé), leur caractère mixte ou non (établissements réservés aux garçons, aux filles ou mixtes), le nombre d’élèves par enseignant, les ressources financières des établissements, l’assiduité des élèves, leur diversité culturelle et linguistique, la perception de la culture de l’établissement par le personnel, ainsi que l’évaluation par les élèves de leur sentiment d’appartenance et du climat scolaire.
Les membres du personnel scolaire devaient indiquer dans quelle mesure ils étaient d’accord avec des affirmations concernant la culture de leur établissement, comme « Dans cette école, les membres du personnel travaillent véritablement en équipe ».
Les élèves devaient, quant à eux, évaluer leur degré d’accord avec des affirmations telles que « Les enseignants font beaucoup d’efforts pour nous aider », « Nous nous sentons en sécurité à l’école », « Je me sens à ma place dans cet établissement » ou encore « Je me fais facilement des amis à l’école ».
Nous nous sommes appuyés sur les données recueillies auprès de plus de 1 500 élèves de quatrième, scolarisés dans 35 établissements secondaires aux profils variés, en Nouvelle-Galles du Sud.
Nous avons utilisé des données déclaratives recueillies auprès des élèves et du personnel scolaire, ainsi que des données sociodémographiques et administratives des établissements. La santé mentale des élèves a également été évaluée à l’aide de questionnaires psychologiques standardisés.
Ce que nous avons découvert
Parmi tous les facteurs examinés dans notre étude, seul le sentiment d’appartenance à la communauté scolaire des élèves de quatrième était associé à un meilleur bien-être deux ans plus tard, lorsqu’ils étaient en seconde.
Autrement dit, les élèves qui se sentaient le plus intégrés à leur établissement en quatrième avaient davantage de chances de présenter un meilleur bien-être psychologique en seconde, même en tenant compte d’autres facteurs comme le genre ou les antécédents de troubles de santé mentale. Ce résultat souligne l’importance que peuvent avoir des relations bienveillantes et stimulantes au sein de l’établissement scolaire pour le bien-être psychologique des élèves.
Notre étude n’a révélé aucun lien entre la santé mentale des élèves et d’autres caractéristiques des établissements, comme le nombre d’élèves par enseignant, la mixité ou le statut public ou privé.
Ces facteurs ont pourtant été associés à d’autres aspects importants de la scolarité, notamment la réussite scolaire. Nos résultats suggèrent toutefois qu’ils pourraient avoir moins d’importance pour le bien-être des élèves que la qualité des liens qu’ils entretiennent avec leurs camarades, le personnel de leur établissement et l’ensemble de la communauté scolaire.
Quelles conclusions en tirer ?
Nos résultats suggèrent que renforcer les liens entre les élèves et leur communauté scolaire dès les premières années du secondaire pourrait améliorer leur bien-être au cours des années suivantes.
Le sentiment d’appartenance est une composante importante de l’équilibre psychologique. L’adolescence est une période de développement rapide, durant laquelle le sentiment d’appartenir à une communauté scolaire contribuerait au bien-être psychologique des jeunes, à mesure qu’ils gagnent en autonomie et construisent leur identité.
Comment renforcer le sentiment d’appartenance ?
De récents travaux montrent que les établissements scolaires peuvent prendre des mesures concrètes pour développer et renforcer le sentiment d’appartenance des élèves à leur communauté scolaire.
Si des recherches supplémentaires sont nécessaires pour déterminer les stratégies les plus efficaces, plusieurs études suggèrent que les programmes mobilisant l’ensemble de la communauté scolaire, en associant enseignants, personnels et élèves, sont généralement ceux qui donnent les meilleurs résultats.
Parmi les initiatives possibles figurent la création de comités réunissant enseignants, personnels et élèves pour renforcer les liens au sein de l’établissement, ainsi que la mise en place d’espaces permettant aux élèves de faire remonter leurs préoccupations et leurs idées à la direction.
Les établissements avec lesquels nous avons travaillé ont également expérimenté des programmes de mentorat entre élèves de différents niveaux, ou encore des activités organisées par les enseignants pendant la pause déjeuner, autour de centres d’intérêt particuliers.
Une récente méta-analyse a également montré que les programmes reposant sur le mentorat et le développement de compétences de résolution collective des problèmes étaient plus efficaces que ceux visant à modifier le comportement des élèves.
Des questions restent en suspens
Notre étude a examiné un large éventail de facteurs liés à l’environnement scolaire chez des élèves de quatrième, au début de leur scolarité dans le secondaire. Il est possible que d’autres facteurs jouent un rôle important dans la santé mentale et le bien-être des élèves à d’autres étapes de leur parcours, notamment à l’école primaire.
Notre étude n’a pas non plus cherché à déterminer si les résultats différaient pour les élèves issus de communautés vivant dans des régions isolées ou de groupes traditionnellement marginalisés.
De nouvelles recherches seront nécessaires pour déterminer si d’autres caractéristiques de l’environnement scolaire peuvent également contribuer au bien-être des élèves les plus exposés aux problèmes de santé mentale.

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
09.10.2026 à 16:29
En Nouvelle-Zélande, la réforme de l’éducation risque-t-elle de creuser les écarts entre élèves ?
Adrian Schoone, Associate Professor, School of Education, Auckland University of Technology
Texte intégral (2129 mots)
L’ESSENTIEL
La Nouvelle-Zélande réforme son système scolaire, au risque de creuser les difficultés des élèves les plus vulnérables.
Le recours à l’enseignement alternatif augmente, révélant les limites de l’accompagnement dans les écoles ordinaires.
Pour bénéficier à tous, la réforme doit renforcer le soutien aux élèves en difficulté et le financement des structures alternatives.
Le système éducatif néo-zélandais connaît sa plus grande réforme depuis des décennies, avec de nouveaux programmes, une refonte des diplômes et des établissements davantage tenus de rendre compte de leurs résultats.
Mais alors que les responsables politiques cherchent à relever le niveau scolaire, un autre défi prend de l’ampleur : comment accompagner les élèves, de plus en plus nombreux, qui rencontrent des difficultés dans les classes ordinaires ? Au cours de la dernière décennie, le nombre d’élèves scolarisés en dehors du système ordinaire a doublé, pour atteindre près de 15 000.
Plus de 9 000 élèves suivent désormais un enseignement à distance auprès de Te Kura, l’équivalent néo-zélandais du Cned,en raison de difficultés liées à leur bien-être ou à leur engagement scolaire, tandis que 2 000 autres sont accueillis par des structures d’enseignement alternatif. Le petit réseau néo-zélandais d’écoles sous contrat, dites « charter schools », a lui aussi enregistré une hausse de 200 % de ses effectifs.
Le mois dernier, l’Education Review Office (ERO), l’organisme chargé de l’évaluation du système éducatif, a alerté sur l’incapacité de la Nouvelle-Zélande à répondre aux besoins de nombreux jeunes scolarisés dans ces structures alternatives. Son appel à une refonte urgente intervient à un moment charnière.
Les pays qui ont engagé des réformes éducatives d’une ampleur comparable ont souvent vu la demande d’enseignement alternatif augmenter, en particulier lorsque les élèves les plus vulnérables ne bénéficiaient pas d’un accompagnement adapté.
En Angleterre, les effectifs des structures d’enseignement alternatif ont augmenté de 156 % entre les années scolaires 2017-2018 et 2024-2025. Cette hausse concerne surtout certains des élèves les plus vulnérables du système éducatif, notamment les adolescents âgés d’environ 14 à 16 ans et ceux qui présentent des besoins éducatifs particuliers.
Aux États-Unis, les effectifs des écoles sous contrat, dites « charter schools », sont passés de 2,7 millions d’élèves en 2014-2015 à environ 3,9 millions en 2023-2024.
Plus près de la Nouvelle-Zélande, l’Australie compte désormais quelque 70 000 élèves scolarisés dans des structures d’enseignement alternatif. Entre 2014 et 2022, les effectifs des établissements indépendants spécialisés dans l’accompagnement des élèves en difficulté ont presque triplé.
Reste donc à savoir si les réformes néo-zélandaises permettront d’améliorer les résultats scolaires sans creuser davantage les difficultés des élèves les plus vulnérables.
Les leçons du passé
Des inquiétudes se font déjà entendre : les nouveaux programmes néo-zélandais, centrés sur l’acquisition de connaissances, pourraient restreindre le choix des matières et moins bien répondre aux besoins de chaque élève.
De premiers articles de presse ont également fait état d’une baisse des résultats avec le nouveau programme de mathématiques. Par ailleurs, une baisse des résultats est attendue pendant la transition entre le système actuel du National Certificate of Educational Achievement (NCEA), le diplôme de fin d’études secondaires, et le nouveau diplôme qui doit le remplacer.
Les risques sont aussi plus larges. Les nouvelles fiches d’évaluation des établissements publiées par l’ERO visent à aider les parents à apprécier les performances des écoles. Mais si les établissements sont évalués publiquement, ils pourraient être moins enclins à accompagner les élèves en difficulté ou susceptibles de décrocher.
La Nouvelle-Zélande a déjà connu cette situation.
L’enseignement alternatif s’est développé dans le pays au début des années 1990, après que les réformes dites « Tomorrow’s Schools » avaient donné aux conseils d’administration des établissements davantage de pouvoir pour exclure des élèves. Plus tard, les classements fondés sur les taux d’obtention des diplômes ont également pénalisé les écoles qui accueillaient les élèves les plus en difficulté.
Mais ces débats sont bien antérieurs à ces réformes. Les inquiétudes suscitées par un modèle éducatif unique, censé convenir à tous les élèves, sont presque aussi anciennes que le système scolaire public néo-zélandais lui-même.
Cette tension est bien illustrée par une caricature de 1899, publiée quelques décennies seulement après que la loi sur l’éducation de 1877 a instauré un système scolaire national en Nouvelle-Zélande. On y voit un inspecteur passer en revue des rangées d’élèves, tous vêtus de la même veste « standard » et évalués à l’aide d’une même règle.

Après la Seconde Guerre mondiale, la Nouvelle-Zélande a pris une autre voie. Sous l’impulsion de Clarence Beeby, directeur de l’éducation de 1940 à 1960, les écoles ont adopté une pédagogie plus novatrice, centrée sur les élèves, qui leur a valu une reconnaissance internationale.
Beaucoup considèrent cette période comme l’apogée de l’engagement néo-zélandais en faveur d’une éducation inclusive. Beeby défendait l’idée que chaque enfant devait recevoir un enseignement « adapté à ses aptitudes », quels que soient son milieu social ou ses capacités.
Pourtant, depuis les origines, le système scolaire répond mal aux besoins de nombreux Maoris. Comme le souligne l’ERO, 58 % des élèves scolarisés dans des structures d’enseignement alternatif sont des jeunes Maoris, ou « rangatahi Māori ».
L’apparition des écoles sous contrat en Nouvelle-Zélande témoigne également de besoins non satisfaits. Environ la moitié semblent s’appuyer sur des approches dites « kaupapa Māori », ancrées dans les valeurs et la culture maories. Cela souligne une insatisfaction persistante quant à la capacité du système classique à répondre aux besoins et aux aspirations des Maoris en matière d’éducation.
Le système doit aussi s’adapter à un nombre croissant d’élèves aux profils neurodivergents, ainsi qu’à ceux qui rencontrent des problèmes de santé mentale, vivent des situations de prise en charge difficiles ou font face à des difficultés socio-économiques.
Des réformes qui bénéficient à tous
La réforme du système éducatif néo-zélandais est désormais bien engagée. Faire marche arrière risquerait de désorienter et d’épuiser un secteur déjà soumis à des changements majeurs et incessants depuis trois ans.
Cela n’empêche toutefois pas d’échelonner plus soigneusement sa mise en œuvre, tout en investissant dans l’accompagnement des élèves et l’enseignement alternatif, afin que les plus vulnérables ne soient pas laissés de côté.
Un livre blanc, récemment publié par le Youth Development and Education Network Aotearoa, un réseau néo-zélandais consacré au développement et à l’éducation des jeunes, propose quelques pistes.
Il défend l’idée que la réforme éducative doit s’accompagner d’investissements accrus en faveur des élèves les plus exposés au risque de décrochage. Il recommande notamment de généraliser, dans les établissements ordinaires, des approches qui tiennent compte des traumatismes vécus et du développement des élèves, afin de limiter le recours à l’enseignement alternatif.
Il appelle également à financer les structures d’enseignement alternatif à un niveau comparable à celui des écoles sous contrat, pour leur permettre de recruter des enseignants qualifiés aux côtés d’éducateurs spécialisés dans l’accompagnement des jeunes.
Il recommande aussi de former et de recruter des professionnels de la pédagogie sociale, qui travailleraient aux côtés des enseignants pour répondre aux besoins sociaux des élèves et les accompagner dans leur développement.
Pour que les réformes éducatives néo-zélandaises réussissent, les responsables politiques devraient écouter cet élève de 15 ans scolarisé dans une structure alternative, dont l’appel a inspiré le titre du livre blanc : « Surtout, ne renoncez pas à nous. »

Adrian Schoone est conseiller auprès de l’organisme national de l’enseignement alternatif en Nouvelle-Zélande.
09.10.2026 à 16:28
L’Angleterre fait de l’inclusion une priorité scolaire, mais que signifie-t-elle vraiment ?
Julie Wharton, Senior Lecturer, Institute of Education, University of Winchester
Texte intégral (1592 mots)
L’ESSENTIEL
Scolariser un enfant dans une école ordinaire ne suffit pas à garantir son inclusion.
L’inclusion repose aussi sur le sentiment d’appartenance, la reconnaissance et la participation à la vie scolaire.
Une définition partagée est nécessaire pour évaluer l’expérience des élèves au-delà de leur seul lieu de scolarisation.
En Angleterre, l’inclusion est devenue l’une des notions phares des politiques éducatives actuelles. Les récentes directives sur la création, dans les établissements scolaires ordinaires, de « pôles d’inclusion » destinés à accompagner les élèves ayant besoin d’un soutien supplémentaire témoignent de la place centrale qu’elle occupe dans les ambitions du ministère de l’Éducation.
Elle est également au cœur de réformes plus larges visant à soutenir les enfants et les jeunes ayant des besoins éducatifs particuliers ou en situation de handicap, désignés par l’acronyme anglais Send. Ces réformes comprennent notamment des recommandations pour aider les établissements à élaborer une stratégie d’inclusion.
Les pôles d’inclusion sont destinés aux élèves ayant des besoins éducatifs particuliers ou en situation de handicap, à ceux qui ont besoin d’un accompagnement social et émotionnel, ainsi qu’à ceux qui risquent une exclusion scolaire. L’objectif est de leur apporter un soutien ciblé tout en maintenant leurs liens avec l’enseignement ordinaire.
Selon ces directives, l’inclusion repose sur des programmes d’enseignement bien conçus et sur la coopération entre les établissements et les professionnels. Elle exige également une direction efficace et un environnement accessible.
Pourtant, malgré la place que lui accordent les politiques éducatives, une question fondamentale reste sans réponse : que signifie exactement « inclusion » ? Le sens de ce terme est souvent considéré comme allant de soi. Pourtant, les responsables politiques, les chercheurs, les enseignants, les parents et les élèves l’interprètent de différentes manières. L’inclusion peut désigner le fait de scolariser les enfants ayant des besoins éducatifs particuliers dans des établissements ordinaires, de leur y faire une place. Mais les recherches suggèrent qu’on la comprend mieux à travers l’expérience des élèves : leur sentiment d’appartenance, leur participation et la reconnaissance qui leur est accordée.
Définir l’inclusion
La déclaration de Salamanque, adoptée en 1994 lors d’une conférence mondiale de l’Unesco sur les besoins éducatifs particuliers, est un accord international sur l’éducation inclusive. Les représentants de 92 gouvernements (dont la France) et de 25 organisations internationales y ont affirmé que les enfants ayant des besoins éducatifs particuliers devaient pouvoir accéder aux établissements scolaires ordinaires, et que ceux-ci devaient s’adapter aux besoins de tous les élèves. Cette approche repose sur des « écoles pour tous », où les différences sont reconnues et prises en compte.
Mais certaines conceptions de l’inclusion dépassent la seule question du handicap. Elles englobent un large éventail de facteurs susceptibles de façonner l’expérience scolaire, comme la pauvreté, l’origine ethnique ou raciale, la langue, le parcours migratoire ou encore le fait d’être un élève LGBTQ+.
Des recherches sur les définitions de l’inclusion montrent que les façons de la comprendre varient considérablement. Elles vont d’interprétations restrictives, centrées sur le lieu où certains enfants sont scolarisés, à des conceptions plus larges, axées sur la création de communautés inclusives.
Ce flou conceptuel a été souligné dans un rapport sur l’inclusion publié par Natspec, une organisation qui fédère des établissements d’enseignement spécialisé. Selon ce rapport, les débats sur les politiques éducatives privilégient souvent la question du lieu de scolarisation, en présentant les établissements ordinaires comme le cadre à privilégier pour l’inclusion.
Pourtant, les élèves des établissements spécialisés décrivent souvent leur expérience comme très inclusive, bien qu’ils soient scolarisés séparément de leurs camarades sans handicap. À leurs yeux, l’inclusion se définit moins par le lieu de scolarisation que par le sentiment d’appartenance, la possibilité de prendre leurs propres décisions et de participer pleinement.
Un enfant peut passer beaucoup de temps dans un établissement ordinaire et être ainsi comptabilisé parmi les élèves bénéficiant de l’inclusion. Mais sa seule présence physique ne garantit ni une véritable participation à la vie sociale de l’établissement ni un sentiment d’appartenance. Les enfants peuvent se sentir « différents » et à l’écart du reste de la communauté scolaire.
De même, un enfant scolarisé dans un établissement spécialisé peut témoigner de liens sociaux solides, de relations positives et du sentiment d’avoir sa place dans une communauté.
La définition de l’inclusion prend également une importance croissante dans les dispositifs d’évaluation des établissements scolaires. Le nouveau cadre d’inspection de l’Ofsted, l’organisme chargé de l’inspection des établissements en Angleterre, fait de l’inclusion un domaine d’évaluation à part entière. Il accorde une grande importance au repérage et à la suppression des obstacles aux apprentissages et au bien-être.
Ce cadre définit une inclusion réussie par des attentes élevées à l’égard des élèves et leur participation effective. Il concerne les élèves défavorisés, ceux qui ont des besoins éducatifs particuliers ou sont en situation de handicap, ceux qui sont suivis par les services sociaux de l’enfance et tous ceux qui rencontrent des obstacles aux apprentissages. Cette évolution marque une prise en compte plus large de l’expérience vécue par les élèves à l’école. La définition retenue semble ainsi plus étendue que celle du ministère de l’Éducation.
Si les inspecteurs, les établissements et les responsables politiques ne donnent pas le même sens à l’inclusion, l’évaluation risque de se réduire à un exercice de conformité, au lieu de traduire un engagement en faveur de la participation, du sentiment d’appartenance et de l’équité.
De l’inclusion au sentiment d’appartenance
Des recherches récentes suggèrent que les discours sur l’éducation sont passés de l’intégration à l’inclusion et font désormais une place croissante à la notion de sentiment d’appartenance.
Dans mes propres travaux, j’ai constaté que l’accueil constitue la première étape de ce parcours : l’élève est alors considéré et reconnu. Le sentiment d’appartenance se construit ensuite à travers les liens qu’il noue et sa participation à la vie de la communauté scolaire.
Les directives du gouvernement sur les pôles d’inclusion reconnaissent d’ailleurs l’importance du sentiment d’appartenance, signe que l’inclusion est de plus en plus envisagée au-delà du seul lieu de scolarisation. L’objectif est de veiller à ce que les enfants accueillis dans ces pôles se sentent pleinement membres de la communauté scolaire.
Le débat sur l’inclusion ne porte pas seulement sur les structures ou les lieux d’enseignement. Il touche aux valeurs, aux relations humaines et aux finalités mêmes de l’éducation. Il faut donc accorder davantage d’attention à la définition de l’inclusion et se demander quelles voix contribuent à la façonner.
L’inclusion ne devrait pas être évaluée uniquement à partir du lieu où les élèves sont scolarisés, mais aussi selon qu’ils sont réellement reconnus, connus et valorisés, et qu’ils peuvent participer pleinement à la vie de leur communauté scolaire.

Julie Wharton ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
09.10.2026 à 09:50
L’économie selon l’extrême droite : des positions fluctuantes, une préférence nationale immuable
Caterina Froio, professeure de sciences politiques, Sciences Po
Texte intégral (1958 mots)
L’ESSENTIEL
Une enquête comparative sur les programmes des partis d’extrême droite européens montre de fortes variations dans le rapport à l’État et au marché.
Derrière cette apparente incohérence, un principe demeure : l’appartenance nationale définit qui doit bénéficier de la protection économique et sociale.
De nombreux gouvernements sociaux-démocrates au pouvoir depuis 1980 ont eu tendance à restreindre les droits sociaux des immigrés, légitimant indirectement une approche économique chauviniste.
Devant le Medef, fin août 2026, Marine Le Pen a défendu la baisse des impôts. Quelques années auparavant, le Front national (FN) mettait davantage l’accent sur la protection sociale. Alors, le Rassemblement national (RN) est-il « de gauche » ou « de droite » sur l’économie ?
Notre recherche, fondée sur l’analyse de plus de quarante ans de documents de campagne et de communication du FN/RN, de la Lega italienne, du Vlaams Belang belge et du PVV néerlandais montre que leurs positions économiques évoluent fortement dans le temps. Elles ne se situent donc pas de manière stable sur l’axe gauche-droite, traditionnellement défini par le rapport à l’État et au marché.
Faut-il pour autant y voir de l’incohérence ? Pas forcément. Les positions peuvent changer, sans que change pour autant la logique qui les relie. Les cadrages – c’est-à-dire les manières de définir et d’interpréter un enjeu – restent relativement stables. Ce qui demeure n’est donc pas nécessairement la mesure défendue, mais une même manière de définir le problème, d’en désigner les responsables et d’identifier ceux qui doivent bénéficier de la solution.
Pour les partis d’extrême droite ces cadrages ont toutefois un point commun : ils définissent les ressources économiques à partir d’une conception particulière de la communauté politique, de la contribution et de la responsabilité. L’appartenance nationale constitue notamment un principe central pour déterminer qui doit bénéficier de la protection économique et sociale.
Cette conception se distingue des traditions de gauche, qui ont davantage fondé la redistribution sur les inégalités sociales et les rapports de classe, en accordant un rôle important à l’État dans la redistribution et en défendant plus souvent une conception universaliste des droits sociaux. Elle se distingue également de la droite libérale, qui privilégie davantage le marché et la responsabilité individuelle comme principes d’allocation des ressources.
Des positions qui changent
Depuis plusieurs décennies, les politistes cherchent à situer les programmes économiques des partis d’extrême droite. Longtemps associés au libéralisme économique ces partis ont, au fil du temps et selon les périodes, adopté des positions plus interventionnistes et défendu un welfare chauvinism, qui réserve la protection sociale aux nationaux.
Certains travaux soulignent également le caractère volontairement flou de leurs positions économiques, qui leur permettrait d’élargir leur électorat.
Les données issues des programmes partisans montrent que le FN/RN s’est éloigné depuis les années 2000 du laissez-faire qui dominait dans les années 1980-1990. Faut-il pour autant le considérer comme « de gauche » ? Pas nécessairement.
Figure 1. Soutien des partis à l’intervention de l’État et à la planification économique mesuré par rapport au libéralisme de marché
La Figure 1 présente l’indice PlanEco, qui mesure le soutien à l’intervention de l’État et à la planification économique par rapport au libéralisme de marché. Des scores élevés correspondent à davantage d’intervention et de régulation de l’économie ; des scores faibles, à davantage de soutien au marché et de retenue budgétaire.
Trois logiques se dégagent :
premièrement, le FN/RN reste proche de zéro dans les années 1980-1990, puis grimpe après la Grande Récession de 2008 (pic vers 2012) : régulation de la finance, nationalisation de secteurs stratégiques, soutien aux petites et moyennes entreprises (PME).
deuxièmement, il redescend ensuite (baisses d’impôts, réduction de la dépense publique), sans retrouver son niveau initial.
troisièmement, le même schéma s’observe ailleurs, à d’autres dates : la Lega abandonne son libéralisme dès les années 1990 avant un nouveau pic après 2010, le PVV culmine en 2017, le Vlaams Belang monte plus tardivement.
Ces mouvements traduisent moins une bascule vers la gauche ou la droite que la combinaison, propre à ces partis, d’engagements pro-marché (baisses d’impôts, réduction de la dépense publique) et d’éléments nationalistes-protectionnistes (contrôle des secteurs stratégiques, protection des entreprises et des travailleurs nationaux) : selon le contexte, l’un ou l’autre registre prend le dessus.
Or, si cet indice permet de montrer les variations des positions des partis dans le temps, il ne dit rien de la manière dont ils leur donnent sens. C’est précisément cette limite qui nous intéresse. Notre recherche part donc de ces positions pour identifier les cadrages qui les relient.
Nos résultats montrent un principe stable : les ressources économiques et la protection sociale doivent d’abord bénéficier aux membres « légitimes » de la communauté nationale. Ce principe permet d’inscrire des positions différentes, voire apparemment contradictoires, dans des cadrages récurrents. Les politiques changent. Les frontières de la solidarité, elles, restent.
Une économie pour qui ?
L’analyse comparative des programmes et documents de communication partisane de quatre partis d’extrême droite européens fait ressortir trois cadrages qui, ensemble, définissent qui doit bénéficier des ressources collectives et qui est tenu pour responsable des difficultés économiques.
Le chauvinisme économique trace les frontières de la solidarité : les ressources collectives doivent d’abord protéger les membres de la communauté nationale.
Le producérisme valorise ceux qui travaillent, produisent et cotisent par opposition à ceux qui sont présentés comme bénéficiant indûment du système.
Le populisme, enfin, désigne les responsables des difficultés économiques : des élites politiques ou administratives accusées d’avoir confisqué ou gaspillé les ressources produites par les « gens ordinaires ».
Ces trois cadrages répondent à trois questions différentes : qui doit être protégé ? Qui mérite de l’être ? Qui est responsable des difficultés économiques ?
Cette grille permet de comprendre des positions qui, vues uniquement à travers l’axe marché-État, peuvent sembler contradictoires. Un impôt plus faible peut être présenté comme une récompense du travail des Français ; une baisse des dépenses publiques comme une sanction d’une bureaucratie gaspilleuse ; une augmentation des droits des douanes comme la défense des entreprises et des travailleurs français ; une restriction de l’immigration, comme la protection de l’emploi et des salaires français. Les politiques changent ; la logique qui les relie demeure.
Après 2008, le FN/RN a proposé de réguler davantage la banque et la finance, de nationaliser des secteurs stratégiques, de faciliter l’accès des PME au crédit et d’augmenter certaines dépenses pour aider les Français en difficulté, tandis que le PVV néerlandais, lors de la pandémie, promettait de stimuler l’économie et accepte une hausse de la dette publique. Dans les deux cas, ces inflexions restent présentées comme la protection des entreprises et des travailleurs « nationaux » face à la mondialisation et à « Bruxelles ».
La contribution économique ne suffit toutefois pas à déterminer qui est considéré comme un bénéficiaire légitime. Même lorsqu’ils travaillent, paient des impôts et cotisent, les immigrés peuvent être présentés comme des concurrents sur le marché du travail ou comme des bénéficiaires indus de la protection sociale. Lorsque contribution et appartenance nationale entrent en tension, le chauvinisme économique prime alors sur le producérisme.
Ces résultats permettent d’éviter deux raccourcis. Le FN/RN n’est pas simplement un parti économiquement libéral : des baisses d’impôts et de dépenses peuvent coexister avec un protectionnisme fondé sur la préférence nationale. Mais ses inflexions sociales n’en font pas pour autant un parti de gauche : l’intervention de l’État est subordonnée à une définition particulière de ceux qu’elle doit protéger.
Des idées à la mise en pratique
Notre recherche porte sur les discours des partis et non sur les politiques qu’ils mettent en œuvre une fois au gouvernement. La littérature récente montre toutefois que, au gouvernement, les partis d’extrême droite peuvent combiner politiques néolibérales et interventions de l’État, notamment en matière de protection sociale).
Les expériences de Giorgia Meloni et de Donald Trump en offrent des illustrations : baisses d’impôts, restrictions de certaines prestations et protectionnisme commercial peuvent ainsi coexister au sein d’un même agenda économique. Ces politiques, parfois contradictoires au regard de l’opposition classique entre État et marché, ont toutefois un point commun dans les cadrages qui les justifient : la protection prioritaire des membres « natifs » de la communauté nationale, et notamment de ceux considérés comme méritants ou contributeurs.
Comprendre les discours économiques est aussi essentiel pour saisir les mécanismes de normalisation de l’extrême droite. Lorsque des partis de gouvernement reprennent certains de ses cadrages, notamment l’idée que les prestations sociales doivent être réservées aux « nationaux méritants », ils ne neutralisent pas nécessairement ces partis.
Une étude portant sur 14 pays européens entre 1980 et 2018 montre ainsi que les sociaux-démocrates au pouvoir adoptent des réformes tantôt qui restreignent, tantôt qui étendent les droits sociaux des immigrés, avec en moyenne une association négative avec ces droits, et qu’ils les réduisent plus volontiers lorsque le chômage augmente.
Les questions économiques, souvent présentées comme secondaires dans le discours de l’extrême droite, peuvent ainsi devenir un puissant vecteur de sa légitimation dans le débat public.

Caterina Froio ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
08.10.2026 à 16:45
Les jeux vidéo « triple i », évolution ou trahison de l’idéal d’indépendance ?
Jenguiz Kanaani, Chercheur associé en Sciences de l'information et de la communication, Université de Lorraine
Texte intégral (2093 mots)
L’ESSENTIEL
L’expression « triple i » fait référence aux jeux vidéo dits « indépendants » et renvoie aux jeux « triple A », ceux qui sont réalisés par d’importants studios avec de gros moyens.
Mais dans l’industrie vidéoludique, la référence à l’indépendance devient une façon parmi d’autres de se distinguer, sans que les moyens employés soient toujours très différents des jeux « mainstream ».
L’appellation « triple i » met en lumière l’imaginaire lié à l’indépendance dans le jeu vidéo et permet de questionner les conditions de production de ces jeux.
Le 9 avril 2026, une vidéo intitulée « The Triple-i Initiative » a été diffusée sur YouTube. Elle proposait quarante-cinq minutes de bandes-annonces de jeux vidéo à venir, suivies de présentations plus approfondies dans lesquelles des membres des équipes de production commentaient certains aspects des jeux et de leur création.
Le site de cette initiative reste assez vague sur la signification attribuée à l’étiquette « triple i » : « C’est 50 % plus gros qu’un jeu double i… Honnêtement, nous ne savons pas vraiment nous-mêmes » (traduction de l’auteur). Deux choses peuvent être affirmées toutefois. L’expression, avec la lettre « i », fait référence aux jeux « indépendants ». La répétition de la lettre « i » renvoie quant à elle aux jeux « triple A ».
L’expression « triple A » désigne des jeux réalisés avec d’importants moyens, comme ceux de la licence Assassin’s Creed d’Ubisoft. Par extension, elle fait aussi référence aux studios qui les réalisent. Ainsi, Ubisoft, célèbre multinationale française, est considérée comme un studio « triple A ».
Quant à la notion d’indépendance, elle ne renvoie pas à une réalité fixe et les discours qui présentent l’indépendance comme une réalité clairement délimitée par opposition à des studios « dépendants » ne font pas justice aux situations concrètes de développement.
Plusieurs jalons peuvent être mentionnés. Les jeux indépendants se sont popularisés à la fin des années 2000, avec des jeux comme Super Meat Boy, réalisé par la Team Meat et publié en 2010, qui réactualise le genre du jeu de plateforme en deux dimensions.
Toutefois, une sorte d’esprit d’indépendance avait déjà commencé à se manifester des années plus tôt. En particulier en 2000, des développeurs anonymes ont publié le « Scratchware Manifesto », un texte à charge contre l’état de l’industrie vidéoludique à l’époque. Les auteurs et autrices y dénoncent aussi bien des pratiques de production toxiques que le manque de créativité de la part de studios qui cherchent avant tout à réaliser des profits plutôt que des bons jeux.
Ainsi, les jeux indépendants ont émergé en tentant de se démarquer des jeux mainstream, en particulier des triple A, comme le souligne le chercheur en études du jeu Jesper Juul. Leurs développeurs revendiquent davantage d’authenticité. En outre, de plus petites équipes les constituent.
Ces quelques éléments révèlent pourquoi l’expression « triple i » étonne. Des développeurs qui se disent indépendants acceptent une étiquette qui les rattache à la production de jeux triple A, dont ils visent pourtant historiquement à se démarquer. Cette situation paraît paradoxale.
Gagner en visibilité dans un contexte de surproduction
L’expression « triple i » n’a pas été inventée à l’occcasion de la « triple i initiative ». Aucune recherche pour le moment n’indique quand cette expression est apparue précisément. Emeric Thoa, cofondateur et directeur créatif de The Game Bakers, un studio indépendant français basé à Montpellier, développait sa vision du triple i lors du Game Camp France 2018, un événement consacré à l’industrie du jeu vidéo.
De manière significative, sa présentation est intitulée « Triple i : Conception et financement d’un jeu indépendant à plus d’un million d’euros ». Le titre annonce d’emblée un type de jeux indépendants reposant sur un budget qui, s’il n’est pas comparable à celui d’un jeu triple A – par exemple, le budget du récent Assassin’s Creed Shadows d’Ubisoft paru en 2025 dépasse les 100 millions d’euros –, est conséquent pour un jeu vidéo indépendant.
Le budget des jeux indépendants varie grandement. Ainsi, des jeux sont créés par des individus sur leur temps libre, à l’image de Balatro, jeu à succès paru en 2024, tandis que d’autres reposent sur des équipes plus importantes et des moyens qui supposent d’investir des dizaines voire des centaines de milliers d’euros – et au-delà du million d’euros pour certains jeux triple i.
Thoa distingue deux catégories de jeux indépendants à succès. Les jeux « jackpot » ont eu un grand succès sans pour autant se construire à partir de critères communs définissables. À l’inverse, les « triple i », dans leur conception, suivent une recette qui favorise leur succès.
Par exemple, Thoa explique avoir analysé plusieurs jeux indépendants à succès pour établir une liste de critères à suivre pour minimiser les risques. Il évoque des critères comme une « forte identité visuelle » ou « sonore » : le but est de sortir du lot à la fois grâce à la qualité technique et créative.
En présentant la notion de cette manière, Thoa suggère donc que ces jeux se conforment à certaines caractéristiques dont dépend leur succès.
Là est tout le paradoxe de cette appellation. En effet, les études concernant les industries culturelles montrent que la recherche de stratégies pour minimiser les risques financiers est une caractéristique des grandes entreprises. Ces mêmes grandes entreprises dont cherchaient au départ à se démarquer les indépendants.
L’existence et la revendication par certains studios de l’étiquette « triple i » sont donc révélatrices de l’évolution des notions de « jeux indépendants » et « studios indépendants ». L’indépendance fonctionne de plus en plus comme un moyen parmi d’autres de se distinguer.
Toutefois, l’explosion du nombre de jeux indépendants disponibles sur le marché a rendu l’étiquette moins distinctive que par le passé. Cette situation de surabondance de jeux indépendants a été nommée « indiepocalypse » par le chercheur Anton Savchenko et renvoie à la difficulté croissante d’avoir de la visibilité sur un marché toujours plus saturé de nouvelles sorties. Par exemple, 436 jeux ont été publiés sur la plateforme Steam (l’une des plateformes principales sur ordinateur) en 2013, puis 1 712 en 2014. Le nombre n’a cessé de croître depuis pour atteindre 14 024 jeux en 2023, 18 456 en 2024 et 21 297 en 2025.
Les frontières floues de l’indépendance
L’étiquette « triple i » sert alors, dans ce contexte, à se démarquer encore plus. Elle contribue aussi à rendre la catégorie d’« indépendant » encore plus floue. En effet, les dernières années ont vu à plusieurs reprises émerger des débats sur la dimension « indépendante » ou non de telle ou telle production.
Par exemple, lors des Game Awards 2023, la présence du jeu Dave the Diver parmi les nominés de la catégorie des meilleurs jeux indépendants a suscité de nombreuses réactions. De fait, ce jeu a été réalisé par le studio Mintrocket, une filiale d’une entreprise sud-coréenne majeure du jeu vidéo, Nexon.
Bien que le directeur du jeu ait affirmé que le studio n’est pas un studio indépendant, il n’en reste pas moins vrai que le jeu a été présenté à plusieurs reprises comme indépendant, par exemple dans certains articles de presse.
Plus récemment, des débats ont émergé au sujet du vainqueur de la catégorie « Game of the Year 2025 » des Game Awards, Clair Obscur : Expédition 33, réalisé par le studio montpelliérain Sandfall Interactive. Le soutien d’un éditeur, Kepler Interactive, est le principal élément qui pose question à cet égard, puisque l’un des critères initiaux de l’indépendance dans la culture vidéoludique est de ne pas être sous la tutelle d’un éditeur.
La question des studios « triple i » émerge donc dans un climat où la notion même d’« indépendant » suscite de plus en plus d’interrogations. Quoi qu’il en soit de la définition précise de l’indépendance (qui n’est pas près de cesser de se poser), cette catégorie émergente apparaît donc comme un moyen de se rattacher à deux imaginaires qui ont longtemps semblé opposés.
Le studio montréalais Panache Jeux Numériques est un exemple de studio qui se revendique « triple i », ainsi qu’il est présenté sur sa page LinkedIn. Ce studio offre un exemple intéressant de l’imaginaire hybride entre « triple A » et indépendance. En effet, le cofondateur et directeur créatif du studio est Patrice Désilets, particulièrement connu pour son travail sur la licence Assassin’s Creed (Ubisoft, 2007-2025).
Le savoir-faire et les créations précédentes de Désilets ont souvent été notés dans les articles concernant le premier jeu du studio, Ancestors: The Humankind Odyssey, paru en 2019. Ainsi, les références à son passé dans un « triple A », son envie d’authenticité et son approche plus « artisanale » dans son studio rejoignent l’imaginaire naissant du « triple i ».
L’étiquette de « triple i » participe d’un mouvement d’évolution de la notion même de « jeu » et de « studio indépendant ». Trahison du sens originel de l’indépendance pour les uns, évolution appréciable pour les autres, ces manières de penser l’indépendance dénotent des évolutions aussi bien dans l’imaginaire de l’indépendance que dans les conditions concrètes de production.

Jenguiz Kanaani ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
08.10.2026 à 16:44
Guess who’s back ! Le Royaume-Uni va-t-il revenir au sein de l’Union européenne ?
Alma-Pierre Bonnet, Senior Lecturer in British Studies, Université Jean Moulin Lyon 3
Texte intégral (2063 mots)
L’ESSENTIEL
Le débat sur l’Union européenne revient au premier plan au Royaume-Uni, sous l’impulsion du nouveau premier ministre Andy Burnham, favorable à un rapprochement avec l’UE, voire à un retour en bonne et due forme.
Le contexte semble favorable : popularité en baisse de Reform UK, principal parti anti-UE, évolution démographique de l’électorat et volonté accrue d’une partie des nations constitutives du Royaume-Uni de se lier de nouveau à l’UE.
Un retour dans l’UE reste toutefois très hypothétique : Burnham devra choisir entre plusieurs options, du simple rapprochement à la réadhésion, tout en affrontant d’importants obstacles politiques, constitutionnels et diplomatiques.
Dix ans après le référendum par lequel les Britanniques ont décidé, à une majorité de 51,9 %, que le Royaume-Uni quitterait l’Union européenne, le Brexit demeure un totem pour les conservateurs et une grande réussite aux yeux du parti de droite radicale Reform UK, successeur du UKIP et du Brexit Party.
Les travaillistes, eux, ont longtemps peiné à adopter une position claire sur cette question. Et voilà que, à peine entré au 10, Downing Street, le nouveau premier ministre travailliste, Andy Burnham, a décidé de mettre un coup de pied dans la fourmilière en envisageant ouvertement un retour du pays au sein de l’UE.
Un « dé-Brexitage » est-il possible ?
L’appartenance à l’UE de nouveau au cœur des discussions
Si elle n’a jamais véritablement quitté le débat politique, la question européenne est récemment revenue sur le devant de la scène, avec force. L’imprédictibilité de la présidence états-unienne, et son ingérence dans la composition même du Royaume-Uni (Donald Trump s’étant dit favorable à une réunification de l’Irlande) ont remis en cause la relation (supposément) spéciale entre Londres et Washington.
Au sein de l’UE, le projet « Made in Europe », qui vise à favoriser les producteurs européens au détriment des fournisseurs extérieurs — notamment chinois mais aussi, par la force des choses, britanniques — inquiète Londres, qui redoute que ces nouvelles règles ne limitent l’accès de ses entreprises au marché européen.
Mi-septembre, le sommet des chefs de gouvernements gallois, écossais et nord-irlandais a soulevé un point important : le renforcement des velléités indépendantistes dans chacune de ces trois régions est corrélé à la volonté de retourner dans l’UE.
C’est dans ce contexte délicat que, le 29 septembre, Andy Burnham a prononcé un discours remarqué devant le congrès de son parti à Liverpool. Concernant l’Europe, il a estimé que le Brexit avait fait « plus de mal que de bien » et qu’il fallait envisager un rapprochement avec l’UE, ce qu’il a plus tard confirmé dans une série d’interviews avec les médias britanniques. Le gouvernement serait même en train de tester l’électorat en vue d’un retour au sein de l’UE. Si le projet est ambitieux, sa réalisation soulève de nombreuses interrogations.
Le rapport ambigu du Labour à l’UE
Le rapport entre le Parti travailliste et l’UE est complexe et a été marqué par une multitude de changements de positions. Lors du référendum de 2016, les travaillistes, alors dans l’opposition, ont été critiqués pour ne pas avoir proposé une approche cohérente et une position arrêtée. La majorité de leurs députés, et une grande partie de leurs électeurs jeunes, ont fait campagne pour le « Remain » (le maintien au sein de l’Union) alors que leur chef de l’époque Jeremy Corbyn (2015-2019), classé très à gauche, a toujours fait part de sa méfiance envers une UE jugée anti-sociale et trop libérale sur le plan économique, et n’a appelé à voter en faveur du « Remain » que du bout des lèvres. Deux salles, deux ambiances et au final, un message peu clair.
Après Corbyn, une frange relativement europhile a pris le pouvoir, mais Keir Starmer (chef du parti de 2020 à 2026, et premier ministre durant les deux dernières années, à la suite de la victoire de sa formation aux législatives de 2024) est resté timide sur la question, de peur de s’aliéner certaines circonscriptions pro-Brexit, notamment dans le Nord de l’Angleterre.
Le nouveau chef, Andy Burnham, est un europhile convaincu, même s’il a dû faire preuve de prudence lors de l’élection partielle qui lui a permis de devenir député (condition sine qua non pour être premier ministre), parce que la majorité des électeurs de sa circonscription, Makerfield, avait voté pour le Brexit. Il a toutefois affirmé qu’il voulait voir son pays réintégrer l’UE de son vivant et il n’a eu de cesse, depuis son arrivée au pouvoir, de pousser dans cette direction.
Le contexte international et domestique semble signaler qu’il s’agit du bon moment pour le faire.
Un alignement des planètes ?
Le Royaume-Uni et l’UE doivent organiser un sommet fin novembre pour renforcer leurs liens et aller plus loin que l’approche prudente de « réinitialisation » (reset) de Keir Starmer. Un rapprochement d’autant plus plausible que, actuellement, la popularité de Reform UK, radicalement opposé à toute main tendue vers l’UE, semble faiblir, alors que celle de Burnham est relativement haute.
Le président français himself a salué le possible retour du Royaume-Uni au sein de l’UE, même si cette éventuelle rentrée doit se faire sur les termes et conditions proposés par l’UE. Concernant la politique interne, la perspective d’un retour couperait (pour un temps) l’herbe sous le pied des indépendantistes des nations celtiques qui font d’une adhésion à l’UE un cri de ralliement contre le système centralisateur de Westminster.
Enfin, si le vote pour le Brexit ne se résume pas seulement à une question d’âge, cet aspect ne saurait être négligé. Les cohortes âgées ont eu tendance à voter pour la sortie alors que les plus jeunes sont souvent plus europhiles. Dès lors, certains électeurs de 2016 ne sont plus là et d’autres qui ne pouvaient pas voter, ou qui ne se sont pas déplacés, auront l’opportunité de se faire entendre.
Les diverses options envisagées
Si le programme sur lequel les travaillistes ont été élus en 2024 établit des lignes rouges concernant un retour dans le marché commun, l’union douanière ou la liberté de mouvement, Burnham semble contempler différentes options et affirme qu’aucune solution ne sera négligée d’ici au sommet de novembre, en fonction des sondages d’opinion, de la consultation de certains acteurs économiques et financiers et de l’accueil de Bruxelles.
Il n’écarte donc ni un statu quo ni une demande de réaccession en bonne et due forme, ni toutes les possibilités situées entre ces deux extrêmes : le modèle suisse, qui implique une contribution financière et la liberté de circulation des personnes ; l’adhésion à l’Espace économique européen qui comprend les quatre libertés fondamentales du marché unique (libre circulation des marchandises ; des personnes ; des services ; des capitaux) ; ou encore le statut de « membre associé », comme celui récemment proposé au Canada, dont les contours restent flous.
Ce projet de « dé-Brexitage » (il sera d’ailleurs intéressant de voir les néologismes qui ne manqueront pas de l’accompagner) pose toutefois plusieurs problèmes de taille. D’un point de vue personnel, prendre un tel risque signifie la fin de la lune de miel pour Burnham, ce dont il a parfaitement conscience, comme l’atteste son discours devant le congrès travailliste, le 29 septembre :
« L’espoir naît de l’honnêteté, et nous retrouverons l’espoir. Mais avant tout, l’honnêteté. Elle consiste à dire ce que les hommes politiques évitent généralement de dire. Je vais le dire sans détour. La Grande-Bretagne s’est engagée sur la mauvaise voie depuis longtemps. Désindustrialisation. Déréglementation. Privatisation. Austérité. Brexit. Je suis prêt à prendre des mesures que mes prédécesseurs n’auraient pas prises. Je romprai avec la ligne suivie ces 40 dernières années et mettrai la Grande-Bretagne sur une nouvelle voie. »
Sous l’angle constitutionnel, il doit là aussi faire un choix difficile : proposer un nouveau référendum ou introduire le retour comme promesse électorale dans le programme travailliste de 2029 (date supposée des prochaines élections générales). Chacune de ces deux options risque de rouvrir des plaies qui ne sont pas encore cicatrisées et donner des arguments faciles aux conservateurs et à Reform UK.
Enfin, si l’Europe semble encline à un retour, cela ne se fera pas sous n’importe quelle condition. Il faudra la garantie qu’un nouveau référendum ne sera pas organisé dans un futur proche (ce qui devrait être relativement clair à la lumière des résultats des élections générales de 2029 si les travaillistes y obtiennent une majorité significative).
Le nœud des deux côtés de la Manche sera aussi de savoir si le pays pourra bénéficier des mêmes avantages qu’avant sa sortie, notamment en termes de contribution au budget européen : si oui, il serait difficile de « vendre » ce projet aux 27 ; si non, il serait plus compliqué de convaincre la majorité des Britanniques du bien-fondé d’un retour…
Dès son accession au pouvoir, Burnham a mis l’accent sur sa capacité à proposer de nouvelles idées et des solutions concrètes pour bousculer le statu quo. Cette ambition européenne reflète cette volonté, mais elle préfigure d’importants défis dans un pays où la question identitaire, qui, pour certains, inclut pleinement un rejet de l’UE, reste extrêmement délicate.

Alma-Pierre Bonnet ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
08.10.2026 à 16:44
Le four tahitien, un laboratoire scientifique sous nos pieds
Lovaina Rochette, Docteure en langue, civilisation et littérature océanienne, professeure certifiée en langue tahitienne, Université de la Polynésie Française
Texte intégral (2975 mots)
L’ESSENTIEL
L’ahimā’a, le four tahitien traditionnel, est bien plus qu’une technique culinaire : il constitue une véritable technologie thermique, fondée sur des savoirs empiriques.
Son étude permet de croiser alimentation, environnement, archéologie et linguistique, en interrogeant notamment les ressources utilisées et la transmission des savoirs.
L’ahimā’a peut ainsi devenir un « laboratoire vivant », où savoirs traditionnels et méthodes scientifiques se rencontrent pour mieux comprendre une pratique culturelle polynésienne.
Au petit matin, le feu est déjà allumé. Les pierres chauffent sur le bois. Autour du four, chacun sait ce qu’il doit faire : choisir les bonnes pierres, préparer les feuilles, surveiller le feu, déterminer le moment où les aliments peuvent être déposés. Puis vient le temps de recouvrir le tout. Pendant plusieurs heures, sous cette enveloppe végétale, la chaleur transforme les aliments.
À première vue, rien ici ne ressemble à un laboratoire. Pourtant, sous quelques dizaines de centimètres de feuilles et de terre se déroulent simultanément des phénomènes physiques, chimiques et écologiques. C’est ce changement de regard que je propose : considérer l’ahimā’a non seulement comme un patrimoine à préserver, mais comme un objet à étudier.
Une technologie thermique avant d’être une recette
Le principe paraît simple : chauffer des pierres, puis utiliser l’énergie qu’elles ont accumulée pour cuire les aliments dans un espace fermé. En réalité, plusieurs mécanismes se combinent. La chaleur passe des pierres aux aliments ; l’eau contenue dans les végétaux et les aliments se transforme en vapeur ; la couverture ralentit les échanges avec l’extérieur.
La cuisson dépend donc d’un ensemble de paramètres : température, durée, humidité, nature des pierres, quantité de combustible et organisation des couches du four. Les recherches archéologiques sur les cuissons à pierres chauffées montrent que ces dispositifs peuvent emmagasiner puis restituer progressivement de grandes quantités d’énergie : une véritable technologie thermique, même sans instrument au sens moderne.
Dès lors, les conseils transmis par les praticiens deviennent autant de questions de recherche. Pourquoi telle pierre convient-elle mieux qu’une autre ? Résiste-t-elle davantage aux chocs thermiques ? Certaines essences de bois produisent-elles des braises plus durables ? Quels indices permettent de reconnaître qu’un four est prêt ?
Des mesures permettraient de confronter ces observations empiriques à des données expérimentales. Le geste traditionnel ne serait plus placé face à la science : il deviendrait le point de départ de l’enquête.
Un laboratoire pour l’alimentation et l’environnement
Le terme mā’a tahiti est aujourd’hui très souvent associé aux plats préparés dans le four tahitien. Pourtant, il désigne avant tout l’alimentation de base traditionnelle composée d’une source de protéines, généralement poisson ou viande, d’un féculent et d’un liant comme du lait de coco. Ce mā’a tahiti est volontiers associé à une alimentation locale, naturelle ou saine. Ce rapprochement mérite pourtant d’être étudié plutôt que présupposé.
Plusieurs aliments emblématiques du mā’a tahiti (‘uru, taro, patate douce, banane, poisson) sont aujourd’hui au cœur de programmes de revalorisation des systèmes alimentaires locaux. La Organisation des Nations Unies pour l’alimentation et l’agriculture (FAO) souligne notamment l’intérêt d’une moindre dépendance aux produits importés.
Cela ne signifie cependant ni que tout aliment traditionnel soit automatiquement meilleur pour la santé, ni que toute cuisson traditionnelle préserve mieux les nutriments. Des expériences menées aux Fidji sur le lovo, un autre four de terre océanien, ont montré que la rétention des vitamines dépend à la fois de l’aliment, du nutriment considéré et du mode de cuisson.
Voilà précisément pourquoi l’ahimā’a mérite d’être étudié expérimentalement. Quelles températures atteint-il, et comment évoluent-elles pendant la cuisson ? Que deviennent l’eau et certains nutriments ? Une cuisson enveloppée dans des feuilles produit-elle les mêmes effets qu’une cuisson dans des contenants contemporains ? Quels végétaux ou quelles essences de bois contribuent aux saveurs et aux arômes des aliments cuits dans le ahimā’a ?
La même prudence s’impose lorsque l’on parle d’écologie. Préparer un ahimā’a mobilise du bois, des végétaux, des pierres et des produits alimentaires. Leur provenance, leur disponibilité et leur renouvellement doivent être étudiés.
Qualifier le four de « technologie écologique » ne devrait donc pas lui attribuer d’avance une vertu environnementale. L’enjeu est de comprendre comment cette technologie fonctionne dans un milieu donné : quelles ressources sont choisies, en quelles quantités, selon quels critères et avec quelles conséquences ? La durabilité devient alors une question de recherche, non un label.
Quand les mots transmettent aussi la technique
Un ahimā’a ne s’apprend pas seulement en observant la chaleur. Il faut aussi apprendre des mots. Les noms des pierres, des bois, des feuilles, des aliments, des ustensiles, des parties du four et des étapes de préparation constituent autant de portes d’entrée vers des connaissances spécialisées. Une langue ne sert pas uniquement à nommer le monde : dans une pratique technique, elle permet aussi de classer, distinguer et transmettre ce que l’on observe.
Si un terme différencie deux types de pierres, deux états du feu ou deux moments de cuisson, sa disparition ne représente donc pas seulement la perte d’un mot. Elle peut rendre plus difficile la transmission d’une distinction affinée par plusieurs générations d’expérience.
Cette articulation entre gestes, vocabulaire et connaissances rend l’ahimā’a particulièrement intéressant pour la recherche. En Polynésie française, des opérations récentes recueillent déjà auprès de personnes ressources les pratiques et le lexique associés au four de terre.
L’archéologie rappelle aussi que cette tradition d’origine austronésienne, millénaire, dépasse depuis longtemps la seule fonction culinaire. À ‘Opunohu, à Mo’orea, des fours ont été identifiés dans des espaces résidentiels mais aussi dans des contextes cérémoniels et de festin : le four est aussi une infrastructure sociale.
De la pirogue au four : changer de regard
Un autre objet polynésien a déjà connu ce changement de statut : la pirogue de navigation. Longtemps considérée surtout comme un objet ethnographique, elle est devenue un terrain d’expérimentation scientifique.
Les voyages réalisés à bord de reconstructions de pirogues doubles, notamment Hōkūle’a, ont contribué à renouveler les discussions sur les savoirs de navigation et le peuplement intentionnel du Pacifique.
Il ne s’agit pas de mettre sur le même plan navigation océanique et cuisson des aliments. La comparaison porte sur notre regard : un objet transmis par la pratique peut contenir des problèmes scientifiques d’une remarquable complexité. Pourquoi l’ahimā’a n’aurait-il pas droit, lui aussi, à cette curiosité ?
Faire dialoguer les savoirs
Cette démarche rejoint la notion d’« écologie des savoirs » développée par le sociologue Boaventura de Sousa Santos (2011). Elle invite à ne pas opposer automatiquement savoir scientifique et connaissances dites non académiques, mais à examiner leurs domaines de pertinence, leurs limites et les conditions de leur rencontre. Il ne s’agit ni d’affirmer que tout savoir traditionnel est nécessairement scientifique, ni de considérer que les sciences académiques peuvent, seules, expliquer la totalité d’une pratique culturelle.
La question est plus féconde : que se passe-t-il lorsque les savoirs des praticiens rencontrent les instruments et les méthodes des chercheurs ?
Une personne expérimentée sait qu’une pierre convient au four ; le géologue peut étudier sa composition et son comportement sous l’effet de la chaleur. Le responsable du four reconnaît certains signes indiquant qu’il est prêt ; le physicien peut enregistrer une courbe de température. Un locuteur connaît le terme précis désignant une feuille, un geste ou une étape ; le linguiste peut documenter ce vocabulaire et étudier sa transmission.
Ces connaissances ne disent pas exactement la même chose. C’est précisément ce qui rend leur rencontre féconde.
Faire de l’ahimā’a un laboratoire vivant
Mon intérêt pour cet objet se situe dans cette double proximité : celle d’une pratique culturelle polynésienne familière et celle d’une chercheuse qui souhaite l’interroger avec les outils des sciences humaines tout en ouvrant le dialogue avec les sciences expérimentales. Être une chercheuse « de l’intérieur » n’exempte pas de la méthode scientifique. Cela oblige au contraire à interroger ce que la familiarité peut rendre invisible.
Mesurer la température des pierres, identifier les végétaux, comparer les aliments avant et après cuisson, enregistrer les mots employés, documenter les variantes entre familles et entre îles : autant de pistes pour transformer une pratique familière en programme de recherche interdisciplinaire.
À l’occasion de la Fête de la science 2026 et de son thème « Saveurs savantes », l’ahimā’a invite ainsi à regarder autrement ce qui se trouve déjà sous nos yeux — ou plutôt sous nos pieds. Car sous les feuilles et les pierres chaudes ne cuisent pas seulement des aliments. S’y transmettent aussi des façons d’observer, de nommer et de comprendre un milieu.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Lovaina Rochette ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
08.10.2026 à 16:43
Jeunes ruraux LGBTIQ : en finir avec le mythe de la ville refuge et de la campagne hostile
Arnaud Alessandrin, Sociologue, Université de Bordeaux
Clément Reversé, Sociologie de la jeunesse, sociologie des espaces ruraux, Université de Bordeaux
Texte intégral (1956 mots)
L’ESSENTIEL
À la veille de la journée internationale du coming out, le 11 octobre, focus sur les jeunes ruraux lesbiennes, gays, bisexuels, transgenres, intersexes et queers (LGBTIQ) et leur rapport au territoire.
Contrairement à la représentation qui a longtemps prévalu, il n’y a pas lieu d’opposer une « ville refuge » à une campagne hostile pour cette jeunesse, confirme une enquête inédite.
Cette enquête toute en nuances montre des expériences rurales diverses faites à la fois d’attachement au cadre de vie ou aux solidarités locales, mais aussi de discriminations et de contraintes.
Pendant des décennies, un même récit s’est imposé sans grande contestation : pour vivre son homosexualité ou sa transidentité, il fallait partir. Quitter le village, gagner la grande ville, y trouver l’anonymat protecteur qui rend le coming out possible, les rencontres accessibles et le quotidien plus respirable. En creux de ce récit se dessinait son envers : une campagne figée dans l’hostilité, le silence et parfois la violence.
Cette représentation opposant ville « refuge » et campagne « hostile » mérite aujourd’hui d’être interrogée à la lumière de travaux récents et d’une enquête nationale inédite sur les jeunesses lesbiennes, gays, bisexuels, transgenres, intersexes et queers (LGBTIQ) rurales, détaillée dans notre ouvrage Fiertés d’ici : grandir LGBTIQ à la campagne (2026).
Il ne s’agit pas de substituer à cette opposition ville-campagne une nouvelle carte postale, celle de campagnes devenues soudainement accueillantes pour les LGBTIQ. L’enjeu est plutôt de comprendre ce que cette opposition binaire empêche de voir : des expériences rurales beaucoup plus diverses, faites tout à la fois de contraintes, d’attachements, de départs et de retours.
La fuite salvatrice, un imaginaire tenace
L’imaginaire de la fuite salvatrice imprègne la culture populaire. Dans Smalltown Boy, le clip du groupe britannique Bronski Beat sorti en 1984, un jeune homme rejeté par son père après une agression homophobe prend le train pour Londres sans se retourner.
Chez Renaud, P’tit pédé (2002) raconte la même histoire : le « p’tit bled » hostile abandonné pour Paris et ses backrooms du Marais, seul endroit où le personnage peut enfin s’assumer.
La sociologie de l’homosexualité a longtemps reconduit cet imaginaire. Michael Pollak décrivait ainsi, en 1982, le ghetto urbain comme le lieu où le jeune homosexuel entre progressivement dans un marché des échanges et une sociabilité spécifique, loin des campagnes et des petites villes.
En 2010, le géographe Stéphane Leroy a, de son côté, théorisé un véritable « droit à la ville » acquis par les homosexuels, devenant la condition même de leur visibilité et de leur épanouissement. Ville et émancipation, campagne et relégation : le couple était scellé. Cette association repose cependant sur un glissement. C’est parce que les grandes villes concentrent davantage de lieux de sociabilité, d’association, de partenaires potentiels… qu’elles seraient nécessairement des espaces où les personnes LGBTIQ vivent mieux.
Or, densité des réseaux de pairs et qualité de vie ne se confondent pas nécessairement. Surtout, cette lecture tend à faire du départ la seule forme possible d’émancipation.
Ce que la géographie et la sociologie récentes nuancent
Cette lecture a été fortement nuancée par des travaux plus récents (2016) en géographie et en sociologie. Colin Giraud, en menant une enquête ethnographique auprès de gays vivant dans la Drôme, loin des métropoles, montre par exemple que l’expérience homosexuelle rurale ne se réduit ni au secret ni à la solitude : des ressources minoritaires s’y construisent, sous des formes différentes de celles du modèle urbain, comme des formes de solidarités locales.
Ces analyses qualitatives ont contribué à déplacer le regard et à montrer qu’il existe bien des vies LGBTIQ rurales qui ne se réduisent ni à l’isolement ni au départ. Restait à changer d’échelle, et à évaluer ces expériences sur un échantillon bien plus large.
Fiertés d’ici : que se passe-t-il si l’on change d’échelle ?
C’est tout l’enjeu de l’enquête quantitative et qualitative Fiertés d’ici, menée entre 2024 et 2026 auprès de jeunes LGBTIQ des territoires ruraux à l’échelle de la France hexagonale par le biais d’un questionnaire diffusé notamment par le biais du réseau des centres LGBTIQ et de l’enseignement secondaire et agricole. Sur les réponses collectées, 1 062 se sont révélées exploitables, très au-dessus du seuil de représentativité statistique. Vingt entretiens semi-directifs d’une heure en moyenne sont venus compléter cette photographie quantitative par l’épaisseur des trajectoires individuelles.
Ce volume de réponses dit aussi une envie manifeste, chez les jeunes LGBTIQ ruraux, de prendre la parole sur des sujets trop longtemps pensés comme exclusivement urbains. Cette envie est contemporaine de l’éclosion, un peu partout en France, de prides rurales comme celle de Chenevelles, dans la Vienne, où depuis 2022 l’événement Fiertés rurales ambitionne de rendre les campagnes plus vivables pour les personnes LGBTIQ.
Ce genre de mobilisation donne tout son sens au titre de l’ouvrage. La fierté consiste à revendiquer à la fois son identité LGBTIQ en tant que rurale et son appartenance rurale au sein de la communauté LGBTIQ.
Il faut aussi rappeler la médiatisation croissante de ces questions qui a aidé à cette prise de parole des LGBTIQ des territoires ruraux, comme on peut le voir avec le documentaire Pédale rurale, qui suit un agriculteur de Dordogne dans son cheminement vers une vie queer assumée sur ses propres terres.
Près de 90 % des jeunes LGBTIQ projettent leur avenir en ruralité
Que montre l’enquête Fiertés d’ici ? D’abord que tous les LGBTIQ ruraux ne souhaitent pas quitter la campagne pour se réfugier en ville : 51 % des répondantes et répondants envisagent d’y rester durablement, et 14 % de plus comptent y rester avant de partir un jour – près des deux tiers de l’échantillon est donc enraciné. À l’inverse, seuls 10 % envisagent de quitter la campagne pour toujours, les 25 % restants prévoyant de partir puis d’y revenir.
En clair, ce sont 90 % des jeunes LGBTIQ qui projettent leur avenir en ruralité. Ce rapport au territoire varie surtout avec l’âge : les 15-17 ans sont les plus nombreux à vouloir partir définitivement, quand les plus de 25 ans souhaitent au contraire un ancrage durable.
Il ne faut cependant pas peindre la campagne comme un espace forcément calme, préservé, proche de la nature donc éloigné des phénomènes discriminatoires. Les chiffres tempèrent nettement cette image : 73 % des personnes interrogées déclarent avoir eu le sentiment d’être discriminées. Ce sentiment monte à 82 % chez les personnes trans et à 85 % chez les personnes non binaires.
Parmi ces jeunes discriminés, 88 % rapportent avoir subi des violences verbales (74 %), psychologiques (56 %), du harcèlement (47 %), des menaces (31 %), des violences physiques (27 %) ou sexuelles (25 %). Le sentiment d’insécurité, lui, s’exprime d’abord à l’école (30 % ne s’y sentent pas en sécurité), puis dans la famille (25 %) et dans les espaces de loisir ou de sport (24 %).
Des discriminations légèrement plus prégnantes qu’en ville
Si les parcours de vie sont marqués par des discriminations légèrement plus prégnantes qu’en ville, notamment scolaires, l’enquête donne aussi à voir des solidarités qui se tissent à la campagne, à commencer par la famille elle-même : « J’y suis revenu pour être avec mes parents qui vieillissent », confie un répondant, quand d’autres évoquent le cadre de vie recherché pour leurs propres enfants ou l’attachement à un lieu chargé de souvenirs et d’amitiés.
Le cadre de vie est également un argument avancé par celles et ceux qui veulent rester vivre à la campagne : 71 % associent la campagne au calme – elle est perçue comme un refuge face au stress et à l’insécurité de la ville. Cette image se renforce avec l’âge (66 % chez les 15-17 ans, plus de 75 % chez les plus de 25 ans), tout comme celle d’une campagne constituant une « opportunité » pour l’avenir (26 % chez les plus jeunes, 32 % chez les plus âgés). Aussi, parmi les jeunes qui se sentent intégrés à la vie locale, 53 % souhaitent rester, contre 10 % chez celles et ceux qui ne le sont pas. Le départ est moins un désir de ville que la conséquence d’un isolement.
Notons que ces difficultés ne tiennent pas seulement à une plus grande hostilité supposée idéologique des campagnes, mais aussi au fait que les réseaux familiaux, scolaires, amicaux et professionnels se recoupent davantage et qu’une information ou une rumeur peut circuler rapidement. L’anonymat est souvent plus difficile :« Dans les petits villages, tout le monde se connaît plus ou moins et, enfin, c’est amené à vite se propager », explique Aaron, 18 ans.
Toutefois, cette interconnaissance peut aussi protéger. En effet, être reconnu comme « du coin », appartenir à une famille installée et participer à la vie locale offre une forme de protection. Celle-ci reste toutefois conditionnelle, car elle repose moins sur l’acceptation de la « différence » que sur la place que l’on occupe dans l’interconnaissance locale.
Une fragilité qui persiste
L’inscription des questions LGBTIQ dans la ruralité reste cependant fragile, pour au moins trois raisons. Elle est plus récente qu’en ville et repose sur moins de structures durables (centres LGBTIQ, permanences d’écoute, professionnels formés…).
Elle est aussi moins financée, à un moment où les nouvelles demandes de subvention sont presque toutes refusées, fragilisant les associations qui portent ces sujets sur le terrain.
Enfin, elle se heurte à des inégalités d’accès aux soins. Entre déserts médicaux, éloignement des psychiatres et des psychologues et endocrinologues formés aux parcours de transition… l’écart est net. Dans notre enquête, parmi les jeunes qui se sentent très bien dans leur peau, 27 % ont accès à des soins adaptés de proximité, contre 7 % chez celles et ceux qui vont mal. Les campagnes sont multiples et toutes ne se valent pas sur ce plan.

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
08.10.2026 à 16:42
Pourquoi et comment célèbre-t-on les morts aujourd’hui ?
Martin Julier-Costes, Fins de vie - Rites mortuaire et funéraires - deuil, Université Grenoble Alpes (UGA)
Texte intégral (2766 mots)
Que deviennent nos corps après notre décès ? Dans des sociétés où la mort est de plus en plus invisibilisée, comment ont évolué nos rites ? Demain, à quoi ressembleront les cimetières ? L’enterrement ou la crémation seront-ils remplacés par d’autres méthodes ? Comment le numérique transformera-t-il nos pratiques funéraires ?
Pour répondre à ces questions et à bien d’autres, nous vous proposons une série de six articles sur le thème « Le corps après la mort », rédigés par des experts et illustrés par le dessinateur Vito.
Ce troisième épisode éclaire nos rites funéraires contemporains par les prismes de l’anthropologie et de la sociologie : comment se sont-ils transformés durant les dernières décennies ? Comment célèbre-t-on aujourd’hui nos défunts ? Qu’est-ce que cela révèle de notre rapport à la mort ?
L’ESSENTIEL
Dans nos sociétés contemporaines, les rites funéraires ont subi diverses transformations majeures.
Le secteur funéraire est aujourd’hui incontournable, et ses professionnels assurent des fonctions sociales et symboliques essentielles.
Au-delà des rites funéraires officiels, il existe désormais diverses façons de célébrer les défunts.
Recul de l’influence de la religion, professionnalisation de la prise en charge des décès, changements de pratiques, avec notamment une très forte augmentation du recours à la crémation… Autant de transformations qui font dire à certains que, à notre époque, les rites funéraires n’apporteraient plus autant de sens qu’auparavant, voire tendraient à disparaître.
Pourtant, les travaux des anthropologues et des sociologues battent en brèche cette idée reçue. L’association de ces deux disciplines permet d’identifier comment les rites funéraires se sont transformés et d’affirmer que les défunts sont toujours célébrés et honorés, mais différemment. Explications.
Permettre aux vivants de surmonter la violence du décès
Les êtres humains se définissent par le fait qu’ils se savent mortels et qu’ils souffrent de cette condition : le décès d’un proche perturbe les vivants, aujourd’hui comme hier, ici comme ailleurs. Les études anthropologiques nous apprennent que ce désordre s’accompagne d’une nécessité de rétablir l’ordre, c’est-à-dire de continuer à vivre, malgré tout, en transformant la relation avec la personne désormais absente.
Ces tentatives de remise en ordre se traduisent à travers le rite funéraire, dans la volonté de rassembler les vivants autour du mort et de faire corps face à un événement qui les dépasse. En ce sens, le rite funéraire consiste donc à soutenir le groupe (et ses membres) et à réaffirmer sa survivance, sa continuité. Il s’agit également d’acter la séparation fondamentale entre les vivants et les morts.
C’est le rôle des rites d’oblation,, qui expriment deux tensions indissociables chez les vivants à l’égard de la personne défunte : le besoin de la retenir encore un peu auprès d’eux, tout en l’accompagnant dans un « au-delà ». Il s’agit, par exemple, de prodiguer des soins au corps, de prononcer des paroles et de chanter, d’effectuer une veillée, de partager de la nourriture et des boissons, de déposer des objets auprès du corps et dans le cercueil.
Ces rites permettent aux vivants de s’adapter, d’amortir et de surmonter la violence du décès et ses conséquences, mais ils ne sont pas effectués par tous ni dans les mêmes temporalités suivant les contextes étudiés.
Dans le même espace-temps, les rites de séparation ont pour fonction de remettre le mort et la mort à sa place. Il s’agit non seulement de lui témoigner du respect, mais aussi de s’en protéger : le mort fait peur et peut être contagieux. Il faut, concrètement et symboliquement, s’assurer qu’il ne reviendra pas. Par exemple, le défunt est placé dans un cercueil, qui peut être scellé, qu’on met dans la terre ou dans un caveau.
Sociologie et rites funéraires
Au côté de l’anthropologie, la sociologie nous invite quant à elle à considérer les conditions dans lesquelles surviennent les décès (où, comment et avec qui ?), tout en les reliant aux invariants anthropologiques précités.
La définition des rites funéraires fait l’objet de débats inépuisables au sein des sciences humaines, et il n’est pas question dans cet article de réactualiser cette définition. Précisons, cependant, qu’un rite funéraire au sens où nous l’entendons ici est un ensemble de gestes, de comportements, de discours et de symboles qui forme une constellation autour du mort représentant l’expression collective des honneurs et des obligations à son égard, elles-mêmes négociées avec les contradictions individuelles et collectives de la société étudiée.
Autrement dit, les rites funéraires sont une construction sociale qui paramètre nos émotions par une mise en scène à laquelle les participants et participantes adhèrent, ou n’adhèrent pas.
Les spécialistes de sciences sociales qui ont mené des recherches visant à décrire et à comprendre le contexte actuel des rites funéraires s’accordent sur un point : plusieurs transformations majeures se sont produites dans les sociétés contemporaines.
Des transformations majeures
Grâce aux progrès de l’hygiène et de la médecine, les sociétés occidentales, telles que la société française, ont bénéficié d’une chute importante de la mortalité infantile et d’une hausse de l’espérance de vie. Nous vivons désormais en moyenne plus longtemps et en meilleure santé que nos ancêtres. Conséquence directe : la population vieillit, ce qui a pour corollaire un nombre croissant de décès annuels. En 2025, en France, on a enregistré environ 651 000 décès. Les projections à l’horizon 2070 sont actuellement de 770 000 décès annuels.
Autre constat majeur, les lieux du décès ont changé, allant pour une grande majorité du domicile aux structures médicalisées. La prise en charge des morts s’est progressivement professionnalisée, et il n’est plus possible aujourd’hui de faire sans les professionnels de la fin de vie et du décès (sanitaire, mortuaire, funéraire).
Dans un contexte socio-économique marqué par la sécularisationPhénomène historique par lequel, depuis la seconde moitié du XVIIIᵉ siècle, une séparation s’instaure progressivement entre le domaine religieux et le domaine public, avec l’abandon par les Églises de certaines fonctions qu’elles remplissaient dans la société civile et politique. et la professionnalisation des pompes funèbres, il est également utile de rappeler l’émergence d’un marché de la mort depuis 1993 et la loi de libéralisation des obsèques.
Les cimetières (concessions, espaces verts) sont en revanche gérés par les collectivités locales. Il est aussi de leur ressort de financer les obsèques des « indigents » ou des personnes « sans ressource ». Si elles possèdent un crématorium, elles peuvent, par le biais des conditions établies dans leur délégation de service public, encadrer le prix des prestations ou faire construire une salle de cérémonie. Enfin, elles peuvent autoriser l’utilisation de leur salle communale pour des célébrations d’obsèques (comme pour des mariages ou des naissances).
Autre transformation majeure survenue ces dernières décennies en France : dans un pays où l’inhumation était la norme, le taux de crémation a connu un essor très important. En 1980, il était de 1 %, il est aujourd’hui de 44 %. À côté de l’urbanisation, la crémation a modifié les pratiques funéraires, participant d’un certain détachement vis-à-vis du cimetière comme seul lieu des morts. En effet, l’essor de la crémation a permis aux familles de choisir avec moins de contraintes où disperser les cendres, parfois en dépit de la loi.
Notons aussi l’émergence d’aspirations écologiques quant aux cimetières et aux modes de réduction des corps (qui mène à l’exploration de nouvelles pratiques, telles que l’aquamation et la terramation), ainsi que la récente numérisation de nos vies jusqu’au décès et au-delà, qui s’accompagne d’enjeux éthiques, moraux et économiques. Enfin, parmi les nouvelles pratiques, signalons les usages de la photo, de la caméra et du streaming lors des funérailles.
À lire aussi : Une proposition de loi veut supprimer l’obligation d’utiliser un cercueil et relancer le débat sur la liberté des funérailles
En France, des professionnels au service des familles
En France, la Fédération nationale du funéraire (la première fédération patronale du secteur funéraire) recense 6 000 établissements et plus de 23 000 professionnels, pour un chiffre d’affaires annuel estimé à 3 milliards d’euros.
Le secteur funéraire est aujourd’hui incontournable. En effet, dans notre pays, seules les pompes funèbres sont habilitées à transporter les corps morts et à assurer leur inhumation ou leur crémation. De ce fait, elles sont devenues de véritables « faiseurs de rite », orchestrant les funérailles et promouvant de nouveaux espaces (funérariums, crématoriums).
À leur côté, on note l’émergence, depuis une dizaine d’années, de coopératives funéraires qui cherchent à changer le regard que la société porte sur la mort et les rites, en affichant des valeurs coopératives et de service. Elles plaident contre la marchandisation de la mort et en faveur d’une réappropriation des savoirs et des connaissances sur ces sujets.
Les professionnels du funéraire assurent des fonctions sociales et symboliques essentielles, mais souvent méconnues : elles organisent et planifient la cérémonie avec la famille et les proches, la mettent en œuvre, puis font disparaître les corps ou plus exactement s’assurent de leur réduction, puis de leur devenir, en les plaçant en cimetière, en columbarium, etc.
Ces fonctions vont de pair avec des compétences relationnelles et émotionnelles qui sont, là encore, peu reconnues.
Contrairement aux métiers du sanitaires et du médico-social, les salariés du funéraire ne bénéficient que de peu de temps de formation et sont essentiellement formés sur et par le terrain. Héritant d’un modèle où les familles étaient très présentes (veillées, prises en charge du corps, funérailles, etc.), les autorités françaises ont progressivement choisi de passer à un modèle où ce sont des professionnels, formés et payés pour, qui s’occupent et prennent soin des mourants et des morts.
Comprendre les rites funéraires contemporains
Bien que sécularisée, la France compte beaucoup de croyants et les grandes religions monothéistes restent des références majeures en matière de rites funéraires.
Hormis ces rites funéraires religieux, on observe un accroissement du nombre des cérémonies dites « civiles ». Contrairement aux cérémonies religieuses, elles se préoccupent moins du devenir du mort dans l’« au-delà » (cette question étant reléguée dans la sphère intime) que de personnaliser l’adieu tout en réconfortant les vivants.
L’enjeu est de représenter l’identité de la personne décédée, de mettre en lumière sa singularité en évoquant ses différentes facettes à l’aide de musiques, de diaporamas et de prises de paroles. Dans ce contexte contemporain célébrant l’individu, les pompes funèbres vendent des rites à la carte, personnalisés en fonction des choix du défunt et des familles.
On constate également que plusieurs rites peuvent être réalisés pour un même défunt. En effet, outre le rite funéraire officiel (institué), il n’est pas rare d’observer des rites privés ou semi-publics (instituants), correspondant aux différentes sphères d’appartenance de la personne défunte : son lieu de travail ou d’études, son club de sport ou de loisir, ses groupes d’amis… Pour un même décès, il peut donc exister une pluralité de rites funéraires mobilisant différentes personnes, dans des temporalités et des lieux différents.
La seule observation du rite funéraire officiel ne suffit donc plus, de nos jours, à comprendre comment est célébrée une personne décédée : il est désormais nécessaire d’élargir la focale pour considérer les transformations précitées et leurs conséquences sur la célébration des morts.
En revanche, les réactions humaines face à un décès, décrites par l’anthropologie, ne semblent pas changer : face à un décès, il s’agit de rassembler les vivants, de garder des traces de la personne défunte, de la localiser et de maintenir des liens avec elle.
Remerciements
- Les planches de la bande dessinée ont été réalisées par Victor Locuratolo (@Vito) ;
- Le scénario a été coécrit par Victor Locuratolo et Damien Charabidzé, l’initiateur de cette série d’articles ;
- Cette publication a été rendue possible grâce à un financement de l’Union du Pôle funéraire public (UPFP), structure réunissant les acteurs publics du funéraire afin de défendre et promouvoir leurs services, tout en garantissant un accompagnement digne, éthique et accessible à tous les citoyens. Elle a également bénéficié d’un financement de la Direction culture de l’Université de Lille, dans le cadre de son soutien aux projets de recherche et de diffusion associant arts et sciences.

Julier-Costes Martin a reçu des financements des financements de l'Agence Nationale de la Recherche, du CNRS et du CNAM. Aucun de ces acteurs n'a participé à la rédaction ou à la relecture de cet article et ne tire profit de cet article.
08.10.2026 à 16:41
Pourquoi ça pue ? Ce que les odeurs de nos déchets disent de nous
Nathalie Buchot, Chercheuse en géographie, Le Mans Université
Texte intégral (1524 mots)
L’ESSENTIEL
Pourquoi un doudou qui « sent mauvais » pour un adulte reste-t-il un trésor pour l’enfant qui l’aime ? Pourquoi le camembert ouvre-t-il l’appétit, tandis que l’odeur d’un aliment moisi nous fait reculer ?
L’atelier « Pourquoi ça pue ? » s’inscrit dans la programmation de la Fête de la science 2026 en proposant d’explorer les odeurs des déchets comme autant de traces de nos manières d’habiter, de consommer et de nous souvenir.
Cette rencontre avec le public est proposée au Village des sciences à l’abbaye royale de l’Épau au Mans, dans la Sarthe, les 10 et 11 octobre 2026.
Une odeur qui dérange une personne peut rappeler à une autre un lieu ou quelqu’un, qu’elle aime. Le doudou en est un exemple frappant. Là où un adulte sent un objet textile sale à laver, l’enfant retrouve une présence olfactive réconfortante.
Ce que nous sentons ne se résume donc pas à une matière. Nous l’interprétons à partir de nos souvenirs, de nos habitudes et des idées que nous nous faisons du propre et du sale. Le contexte compte aussi : l’odeur puissante d’un fromage affiné peut être appréciée, tandis qu’une odeur voisine, rencontrée ailleurs, sera jugée suspecte.
Que savons-nous réellement d’une odeur lorsque nous disons simplement « Ça pue » ?
Sentir ce que nous jetons
Nous pensons souvent aux déchets à partir du moment où ils quittent nos mains. Dans quel bac les mettre ? Seront-ils recyclés ? Que deviendront-ils après la collecte ? Ces questions sont nécessaires, mais elles ne racontent qu’une partie de leur histoire. Avant d’être jeté, un objet a été acheté, utilisé, gardé, parfois réparé ou aimé. Un reste de repas parle de cuisine ; un vêtement usé, de nos façons de nous habiller et de conserver les choses.
La rudologie, étude systémique des déchets initiée dans les années 1970 par le géographe manceau Jean Gouhier, portée aujourd’hui par notre équipe dirigée par le géographe Mathieu Durand du laboratoire Espaces et Sociétés au Mans, propose de prendre ces pratiques au sérieux. Elle ne considère pas seulement les déchets comme un problème technique ou sanitaire. Elle y voit aussi des faits sociaux et géographiques, révélateurs de nos pratiques et de nos manières d’habiter. Qu’est-ce que nous acceptons de garder près de nous ? Qu’est-ce qui doit disparaître au plus vite ?
L’odeur rend ces questions concrètes. Elle traverse parfois les frontières que nous traçons entre les espaces : la cuisine et le couloir, la maison et la rue, l’objet conservé et celui que nous voulons éloigner. Elle attire notre attention sur une matière que nous aurions préféré ne pas voir. Mais elle peut également nous inviter à observer ce qui change, se transforme ou demeure.
Sentir un déchet ne signifie pas nier les nuisances qu’il peut produire. Cela permet plutôt de suspendre un instant le réflexe du rejet pour se demander ce que cette réaction raconte. Les déchets deviennent alors des objets à examiner, et non uniquement des restes à faire disparaître.
Une discussion philosophique autour des odeurs : trouver les mots justes
Décrire une odeur est moins facile qu’il n’y paraît. Nous disons qu’elle est « bonne », « mauvaise » ou « forte ». Mais est-elle aussi humide, aigre, terreuse ou sucrée ? Rappelle-t-elle un aliment, une cave, un jardin, un vêtement ? Deux personnes qui emploient le mot « renfermé » parlent-elles de la même chose ? Quels vieux souvenirs s’y cachent ?

Pendant l’atelier, les participantes et participants exploreront des odeurs liées aux déchets alimentaires et textiles. Ils pourront comparer leurs impressions, préciser leurs descriptions et écouter celles des autres. Le test de reconnaissance olfactive réalisé par les étudiantes fera émerger une perception hésitante, un désaccord ou un souvenir inattendu qui seront alors autant de points de départ pour réfléchir.
Les mots proposés contribueront à enrichir un lexique sensible des odeurs détritiques. L’objectif n’est pas d’imposer une définition à chaque senteur. C’est de montrer qu’en cherchant les mots, nous apprenons à distinguer la sensation de l’émotion qu’elle provoque, puis du jugement que nous portons sur elle. Dire « cela me dégoûte » n’est pas tout à fait la même chose que dire « c’est sale ».
Cette exploration olfactive se poursuivra par des échanges sans pour autant décider quelles odeurs il faudrait aimer, mais de comprendre pourquoi nous les jugeons comme nous le faisons : Pourquoi une odeur désagréable nous paraît-elle parfois inquiétante ? Un objet destiné à être jeté a-t-il nécessairement perdu toute valeur ? Pourquoi gardons-nous certains objets abîmés alors que nous nous débarrassons aussitôt d’autres objets encore utilisables ? Ces questions partent d’expériences accessibles à tous. Elles permettent de découvrir que la vie domestique constitue, elle aussi, un terrain de recherche.
Je porte ce projet avec Mathieu Durand, Sandrine Bacconnier, géographes et Camille Dormoy, socio-anthropologue d’ESO Le Mans Université-CNRS. Il est conçu et animé par Mariama Coulibaly, Anouk Hérault Sokhna Mai Mboup, Djaynat Radjabou, Louane Vaoheilala, étudiantes en master MIDEC (Le Mans Université).
Venir sentir et discuter
Labellisé « Coup de cœur 2026 de la Fête de la science », l’atelier « Pourquoi ça pue ? » est gratuit et destiné au grand public à partir de sept ans, dans le cadre du Village des sciences du Mans. L’atelier est conçu spécifiquement à une animation de rue.
Pourquoi venir ? Pour constater qu’une odeur n’est pas toujours aussi évidente qu’on le croit. Pour écouter ce qu’en disent les autres. Et pour découvrir que nos déchets, avant même d’être triés ou recyclés, peuvent nous apprendre quelque chose sur nos gestes, nos attachements et notre façon d’habiter le monde de nos déchets.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Nathalie Buchot a reçu un financement de l'ANR, via le PEPR Recyclage Household Waste (ANR-22-PEPR-0010). Elle est membre du Groupe Philo Sarthe-GPS, association adhérente au réseau des Mille et une maisons de la philo.
08.10.2026 à 16:41
Are insects really ‘poor people’s food’?
Esther Katz, Anthropologue, Institut de recherche pour le développement (IRD)
Texte intégral (3147 mots)
KEY TAKEAWAYS
Eating insects is often perceived only as a last resort in case of famine or extreme poverty.
Yet, in the countries where they are usually eaten, insects are often considered a rare delicacy, even a luxury, because the prized species are difficult to track down.
In some cases, consuming insects also helps to control the proliferation of crop pests.
Do people eat insects when there is nothing else to eat? Are insects really “food for the poor” or famine food?
In the West, insects weren’t considered as food but as vermin, crop pests, vectors of disease or sources of unpleasant bites, while other societies learned to live with them, as ethnobiologist Darrell Posey had already noted in 1978 about Amazonian people.
More than 2,000 edible species are consumed worldwide
When we look at eating attitudes toward insects on an international scale, Europe and North America are actually an exception compared to Latin America, Africa, Asia, and Oceania, where more than 2,000 species are consumed by hundreds of millions of people.
Publications from the first half of the twentieth century that described insect consumption, particularly those by colonial doctor Émile Bergier or entomologist Friedrich Bodenheimer, presented eating insects as an exotic practice, unique to “primitive tribes”. Nevertheless, Bodenheimer already noted insects’ nutritional value at the time.
This reality was confirmed in 2013, in a report by the United Nations Food and Agriculture Organization (FAO) on edible insects. The researchers commissioned by the FAO even developed the interest of these foods in alleviating hunger around the world. Analyses of insects’ nutritional value show that their protein levels are higher than those of other animals, and that they are also rich in vitamins, minerals and unsaturated fatty acids. Are insect consumers necessarily aware of this nutritional contribution? Could this be what leads them to eat insects?
What is an insect?
To answer this question, let’s start by seeing what we mean by insects. Western biologists classify insects, along with arachnids, myriapods and crustaceans, as arthropods, invertebrate animals with segmented bodies and articulated legs. In Latin, insectum refers to what is cut and segmented. Insects are defined as animals whose bodies are split into three parts and who have six legs, a pair of antennae and are usually winged and undergo moulting and metamorphosis. The morphology of the other groups differs: spiders, arachnids sometimes mistaken for insects (while they feed on them), have four pairs of legs, and no wings or antennae.
But this way of categorising insects differs in many societies. Even in France, during the Middle Ages, these creatures were not referred to by the generic term “insects”, but only by their proper names (“cicada” or “grasshoppers"…).
In the Ñuu Savi (Mixtec) language of Mexico, for example, the insect category does not exist. Insects are simply considered to be "small animals”, “which are born alone” (wild, without human intervention), that humans “go searching for” in nature, as they do for plants, mushrooms, or game. Collecting insects is therefore assimilated to either hunting or gathering. For example, in the Brazilian Nordeste region, ant gatherers say they “hunt” them.
Population-specific food choices
Consumers of insects therefore take advantage of what they find in their environment and choose to eat them, as they would any other animal or plant species. But this does not mean that they eat all the available species. Culture guides their dietary choices. Insects eaten by some populations are not necessarily consumed by their neighbours living in a similar environment and, within the same country or region, some social groups may consume insects, while others do not.
This consumption has often been perpetuated in indigenous, marginal, poorer than average populations, which is why it has been perceived as a practice associated with poverty. The fact that insects are gathered in nature, more rarely in urban areas, has reinforced this perception. In societies that have become urbanised and modernised, hunting and gathering can refer to archaic practices.
Prejudices associated with poverty
In Natal, in Brazil’s Nordeste region, the anthropologist Julie Cavignac and myself observed that people were ashamed of eating or having eaten tanajuras (Atta queen ants), as well as of having practised hunting and gathering in the hinterland before the development of the city and its surroundings. All of the Nordeste region, which has suffered several periods of drought throughout history, has long been considered to be the country’s poorest area. These stigmas, which still stand today, contribute to rejecting what appears to be backwards.
Yet tanajuras are not famine food. When people were facing shortages due to drought, they ate cactus pads instead, usually given to livestock, wild tubers or palm fruits rich in starch, or a variety of cassava that must be detoxified for hours. Ants, on the other hand, are actually a delicacy, which appears only once a year, at the time of the ‘nuptial flight’.
Are common crop pests edible?
As Bodenheimer had already noted, insects may have been a famine food in certain circumstances, for example, grasshoppers or locusts, which, by swarming on crops, deprive farmers of their food sources, however, it is not famine that motivates this consumption.
Eating pests partly compensates for agricultural losses and limits their damages. In the tropics, palm weevils (Rhynchophorus spp.), which are considered a real plague in monospecific plantations, are, on the contrary, welcomed by populations that feed on their larvae and thereby control their proliferation.
Insects do not satisfy hunger in cases of starvation
Insects are, in fact, rarely regarded as famine food because they do not satisfy hunger in the same way as starchy foods. Nevertheless, they are a useful source of nutrients for populations suffering from vitamin or mineral deficiencies, or who consume little animal protein.

However, people who have access to game or farmed meat also consume insects, in the Amazon for example. People who eat insects eat them mainly based on their taste, as already noted by Bodenheimer. Palm weevils are appreciated throughout the tropical belt, in America, Africa or Asia. The same is true of grasshoppers and termites in various countries, Atta queen ants in Latin America, and many other species.
Luxury dishes rooted in local knowledge
Some insects, such as the escamoles, eggs and pupae of the Liometopum ants, regarded as “Mexican caviar,” are also deemed so tasty that they are subject to predation and are marketed and even served in upper-class restaurants.
Weevil larvae are sold at least in Cameroon and in the Peruvian, Ecuadorian, Colombian, and Venezuelan Amazonia; the mopane caterpillars are traded in all of southern Africa; grasshoppers are sold in very large quantities in Mexico and in Thailand; insects that only come out once a year, at the time of swarming, arouse even more collector and consumer excitement.
Therefore, collecting insects does not only mean extracting resources from the environment, it also requires specific knowledge of fauna, flora, meteorology and ethology. You need to know insects’ habitats, possibly their host plants, the time of year when they are found, the signs announcing their swarming or arrival, and the climatic conditions that make swarming possible.
Insect-collecting can be dangerous
Insect collecting missions often require physical effort, travelling to isolated places, in uncomfortable conditions, and involve risks (sunstroke, falls in steep places, venomous animal bites). Preparing them demands culinary knowledge, often acquired over decades or centuries of practice.
For such efforts to be made, it must be worthwhile. Insects are actually tasty, and can generate income. The most appreciated ones are fetching ever-higher prices, well above prices for meat. It happens not only in small villages, but also in capital cities, where immigrants of rural origin, nostalgic about these dishes, started selling them. This is how the trade reached Bangkok, Mexico City or Bogota.
Expression of a cultural identity
In Mexico, for example, UNESCO registration of the traditional cuisine as Cultural Intangible Heritage has brought this consumption up to date. Therefore most insects are worth at least 50 euros per kilogram, or even more when they are sold in small portions or served at a restaurant. Selling insects provides additional income to rural families, but also tends to deprive them of nutritious food that they could have eaten.
Some people of rural origin abandon this practice when they emigrate to the city, while others, by perpetuating it, affirm their attachment to the territory, a local identity and a peasant or indigenous history.
Such is the case of the Quitu-Cara, the native inhabitants of the Quito Valley in Ecuador, who consider so-called catzos beetles as a treat, or the inhabitants of the department of Santander, Colombia, for whom the hormigas culonas, Atta queen ants, represent their culinary and cultural heritage. Still other people, especially city dwellers, become new consumers, drawn to a new fashion trend or initiated by friends. And again, their motivation for eating insects is not necessity, but taste.
This article is published as part of the Fête de la science, an annual event in France honouring Science in all its forms (which runs until October 12, 2026) – A The Conversation France partner event. This new edition focuses on the theme “Saveurs Savantes”. Find all the events at Fetedelascience.fr.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Esther Katz ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
08.10.2026 à 16:26
Un prix Nobel pour les neutrinos, ces messagers invisibles qui nous viennent du cosmos
Françoise Combes, Astrophysicienne à l'Observatoire de Paris - PSL, Sorbonne Université; Académie des sciences
Texte intégral (1486 mots)
L’ESSENTIEL
Le prix Nobel de physique 2026 a été décerné au chercheur belge Francis Halzen pour ses travaux sur les neutrinos, les particules les plus énigmatiques et les plus furtives de la physique.
Certains de ces neutrinos ont une énergie folle et, pourtant, ils traversent la planète – et chacun d’entre nous – très discrètement.
Grâce à IceCube, un détecteur monumental caché dans la glace de l’Antarctique et pensé par Francis Halzen, nous commençons à détecter ces neutrinos de très haute énergie, et à comprendre d’où ils viennent. Rendez-vous auprès d’une des entités les plus lumineuses de l’Univers.
Le prix Nobel de physique 2026 a été décerné au physicien belge des particules Francis Halzen, créateur et responsable du projet IceCube, le plus grand télescope à neutrinos de la planète, implanté au cœur des glaces du pôle Sud. Après ses études et son doctorat à l’Université de Louvain, suivis d’un passage de deux ans au Conseil européen pour la recherche nucléaire (Cern), Francis Halzen s’installe dès 1972 à l’Université du Wisconsin à Madison (États-Unis), où il dirige aujourd’hui l’institut de physique des particules.
À 82 ans, le chercheur voit ainsi consacrée son intuition pionnière : avoir conçu cet immense détecteur antarctique capable de capturer les tout premiers neutrinos de très haute énergie, issus des phénomènes les plus violents de l’Univers lointain. La détection de ces particules ouvre une fenêtre inédite sur le cosmos profond, éclairant d’un jour nouveau des mécanismes encore mystérieux comme la fusion d’étoiles à neutrons ou la formation des trous noirs supermassifs.
Le neutrino demeure l’une des entités les plus énigmatiques de la physique. Sa masse est si infime qu’elle n’a encore jamais pu être mesurée directement. On sait en revanche qu’il se décline en trois types ou « saveurs », pour utiliser le terme consacré (électronique, muonique et tauique) capables d’osciller de l’une à l’autre au cours de leur trajet. D’une insaisissable furtivité, ces particules traversent la matière quasi sans interagir : la Terre entière ne constitue pas pour elles un obstacle. Dès les années 1980, Francis Halzen pressent pourtant qu’un immense volume de glace naturelle pourrait servir à tracer leur passage.
Comment détecter l’invisible ?
Bien qu’ils fendent l’espace presque à la vitesse de la lumière dans le vide, les neutrinos ralentissent lorsqu’ils pénètrent un milieu dense comme l’eau ou la glace, dont l’indice de réfraction n est supérieur à 1. La vitesse de la lumière y est alors divisée par n. Lors de la rarissime collision d’un neutrino avec un noyau atomique, ce choc engendre une particule chargée, un électron ou un muon (particule élémentaire qui possède une charge électrique et des propriétés semblables à celles de l’électron, mais avec une masse 207 fois plus grande).
Le muon, plus massif, est plus facile à détecter. Ultrarapide, cette nouvelle particule se déplace alors plus vite que la lumière dans ce milieu, provoquant une onde de choc lumineuse analogue au « bang » d’un avion franchissant le mur du son. Flash bleuâtre caractéristique, cette lumière est enregistrée par des milliers de photomultiplicateurs immergés en grille dans les profondeurs de la glace, permettant de reconstituer avec précision la trajectoire du neutrino original.
L’idée d’écouter ces murmures cosmiques s’inscrit dans une longue filiation. Dans les années 1980, alors que Francis Halzen ébauchait son projet, les chercheurs japonais mettaient en service l’expérience Kamiokande (Kamioka Nucleon Decay Experiment). Initialement conçu pour observer la désintégration, jamais constatée, du proton, l’instrument fut reconverti sous la direction de Masatoshi Koshiba en un télescope à neutrinos hors pair. Cette avancée vaudra à Koshiba le prix Nobel en 2002, avec Raymond Davis et Riccardo Giacconi.
En 1987, l’explosion de la supernova SN1987A dans le Grand Nuage de Magellan en offrit la démonstration éclatante : Kamiokande enregistra la première bouffée de neutrinos extrasolaires de l’histoire, arrivée trois heures avant le signal lumineux.
Plus tard, grâce à l’instrument Super-Kamiokande, Takaaki Kajita et Arthur McDonald démontrèrent en 1998 le phénomène d’oscillation des neutrinos, prouvant de fait que ces particules possèdent une masse non nulle, une découverte couronnée par le Nobel 2015.
Toutefois, la question de l’origine des neutrinos d’énergie extrême demeurait entière. Si les réactions nucléaires au cœur du Soleil ou les explosions de supernovae génèrent des neutrinos, leur énergie reste modeste. En 2017, IceCube repère des neutrinos atteignant des énergies colossales, mesurées en plusieurs centaines de péta-électronvolts (PeV), soit près d’un milliard de milliards d’eV. Par comparaison, l’énergie de masse (mc²) du proton est de 1 GeV, et l’énergie maximale du collisionneur de protons du CERN est de 14 TeV. Quelle forge cosmique peut libérer une telle puissance ?
La réponse est venue des quasars (les entités les plus lumineuses de l’Univers), et plus particulièrement des blazars. Au centre de certaines galaxies lointaines, des trous noirs supermassifs accrètent de la matière. Une partie de cette matière tourbillonnante est expulsée le long de l’axe de rotation sous forme de jets relativistes, où les particules sont lancées à une vitesse proche de celle de la lumière. Une particule qui voyage à de telles vitesses émet de la lumière fortement amplifiée, de plusieurs ordres de grandeur, dans sa direction de propagation.
Lorsque l’un de ces jets se trouve pointé exactement dans l’axe de la Terre, la source prend le nom de blazar. Son rayonnement de photons gamma, protons, et neutrinos, se trouve alors prodigieusement amplifié par effet relativiste.
À lire aussi : Blazars, ces phares cosmiques qui nous guident depuis les tréfonds du cosmos
Lever le voile sur les ultimes secrets du cosmos
L’observatoire IceCube, constitué d’un kilomètre cube de glace zébré de 86 lignes de détecteurs enfouis à plus de 1 000 mètres de profondeur, a pu identifier ces monstres cosmiques en croisant ses détections de neutrinos avec les observations de rayons gamma.
Plus récemment, en 2025, le détecteur sous-marin KM3NeT a confirmé ces mesures exceptionnelles. KM3NeT est constitué d’un kilomètre cube d’eau de mer déployé en Méditerranée. C’est un projet en train de compléter sa construction, par une collaboration internationale de 21 pays, menée par la France et l’Italie,
L’observation conjointe d’un rayonnement gamma et la détection de neutrinos de très haute énergie au même moment et dans la même direction renforcent l’hypothèse des blazars comme sources de ces neutrinos. C’est là tout l’intérêt des observations conjointes.
Cette synergie marque l’avènement de l’astronomie multimessager, qui croise la lumière (photons), les neutrinos et les ondes gravitationnelles pour scruter les événements les plus violents de l’Univers. Aujourd’hui, épaulés par le télescope géant Vera-Rubin au Chili, dont les algorithmes d’intelligence artificielle trient chaque nuit des millions d’alertes cosmiques (astéroïdes, supernovae, quasars, etc.), les astronomes peuvent pointer leurs instruments dans la bonne direction en quelques secondes et lever le voile sur les ultimes secrets du cosmos.

Françoise Combes ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
08.10.2026 à 15:50
De l’autre côté du miroir : le Nobel de chimie 2026 récompense des travaux sur des molécules reflets l’une de l’autre
Matthew Addicoat, Senior Lecturer in Functional Materials, Nottingham Trent University
Texte intégral (1464 mots)
L’ESSENTIEL
Le prix Nobel de chimie 2026 a été décerné au Français Henri Kagan et au Japonais Kensō Soai pour leurs travaux sur les molécules « chirales ». Celles-ci existant en deux versions reflets l’une de l’autre, comme notre main gauche semble être le reflet de notre main droite. On parle aussi d’« image miroir » ou d’« énantiomères ».
De nombreuses molécules biologiques sont chirales, à l'instar des acides aminés qui constituent les éléments de base des protéines chez les êtres vivants. Cette propriété affecte leur capacité à réagir avec d’autres molécules, comme une main droite rentre mal dans un gant gauche.
Pour comprendre le vivant et pour concevoir des médicaments, la maîtrise de la chiralité est très importante… d’où l'attribution du Nobel !
Les lauréats du prix Nobel de chimie 2026 ont été annoncés mercredi 7 octobre à Stockholm (Suède).
Henri Kagan est né à Boulogne-Billancourt, en 1930. Il est professeur émérite à l’Université Paris-Saclay. Kensō Soai est né à Hiroshima, au Japon, en 1950. Il est maître de conférences à l’Université des sciences de Tokyo.
Kagan et Soai ont mis au point des réactions permettant de produire une seule des deux formes de ces molécules chirales. Leurs travaux ont été décisifs pour les chimistes qui fabriquent des médicaments, car parfois, seule une des deux formes (droite ou gauche) de la molécule a l’effet souhaité dans l’organisme.
Les molécules en image miroir sont extrêmement courantes, et leurs formes « droite » et « gauche » peuvent avoir des effets très différents. Par exemple, la forme droite du limonène a une odeur d’orange, tandis que l’autre a plutôt une odeur de citron. De même, l’une des formes de la molécule de carvone est responsable de l’odeur des graines de carvi et sert à empêcher les pommes de terre de pourrir (gauche) tandis que la molécule en image miroir (droite) a une odeur de menthe et est utilisée pour repousser les moustiques.
Nous pouvons facilement distinguer ces différentes molécules en image miroir, car les récepteurs de notre nez sont constitués d’acides aminés qui sont tous « gauchers ».
De la même façon qu’une main gauche rentre mal dans un gant droit, en biologie, une molécule « gauche » se lie différemment à un récepteur constitué d’acides aminés gauches qu’une molécule « droite ».
Deux questions se posent autour des molécules chirales. Premièrement, lors d’une réaction chimique, on obtient souvent un mélange des deux images miroirs, ou énantiomères. Cela peut poser problème lors du développement de médicaments, pour les raisons que nous avons déjà évoquées. Comment produire une seule des deux formes, de façon exclusive ?
Deuxième question, d’importance car elle constitue un des mystères de l’apparition de la vie : les acides aminés n’existent naturellement que sous leur forme gauche (lévogyre) – en d’autres termes, la vie est chirale et cela a d’importantes répercussions en biologie. Mais comment cette préférence pour la forme lévogyre est-elle apparue sur Terre ?
Trouver des solutions
Henri Kagan a fait un grand pas en avant en 1986, lorsqu’il a découvert une nouvelle façon de manipuler les réactions chimiques. Kagan est parti d’un catalyseur qui était lui-même chiral. Un catalyseur est une substance qui accélère une réaction chimique sans être consommée au cours du processus.
Kagan a ensuite montré comment un mélange des versions « gauche » et « droite » du catalyseur pouvait augmenter le pourcentage de la forme « gauche » ou « droite » du produit.
En 2003, Soai s’est penché sur la deuxième question : comment partir d’une situation sans chiralité préférentielle et aboutir exclusivement à la variante « gauche » ou « droite » d’une molécule ?

Pour ce faire, il a utilisé une réaction chimique autocatalytique, c’est-à-dire que le produit de la réaction sert également de catalyseur à celle-ci.
Une fois que le produit chiral se forme, il favorise la formation d’une des deux versions (ou énantiomères). Dans ce cas, si les versions gauche et droite du produit se forment initialement toutes les deux, un tout petit déséquilibre entre les deux s’autorenforce au fur et à mesure de la réaction.
Cela permet à une seule version de la molécule de s’imposer, jusqu’à pouvoir représenter 99,99 % du produit final.
Nous ne connaissons pas les conditions qui régnaient sur Terre il y a 4 milliards d’années et qui ont conduit à la formation naturelle exclusive d’acides aminés lévogyres. Mais Soai a montré qu’il est bel et bien possible de former quasi exclusivement une seule des deux versions d’une molécule chirale.

Matthew Addicoat a reçu des financements du Leverhulme Trust et de ARIA. Il a reçu par le passé des financements de l'EPSRC et de la Royal Society.
08.10.2026 à 12:22
Vaut-il mieux manger de petits poissons ou de grands poissons ?
Gauthier Schaal, Maître de Conférences en biologie marine, Université de Bretagne occidentale
Alice Guillot, Doctorante en sciences de l'environnement marin, Université de Bretagne occidentale
Texte intégral (2166 mots)
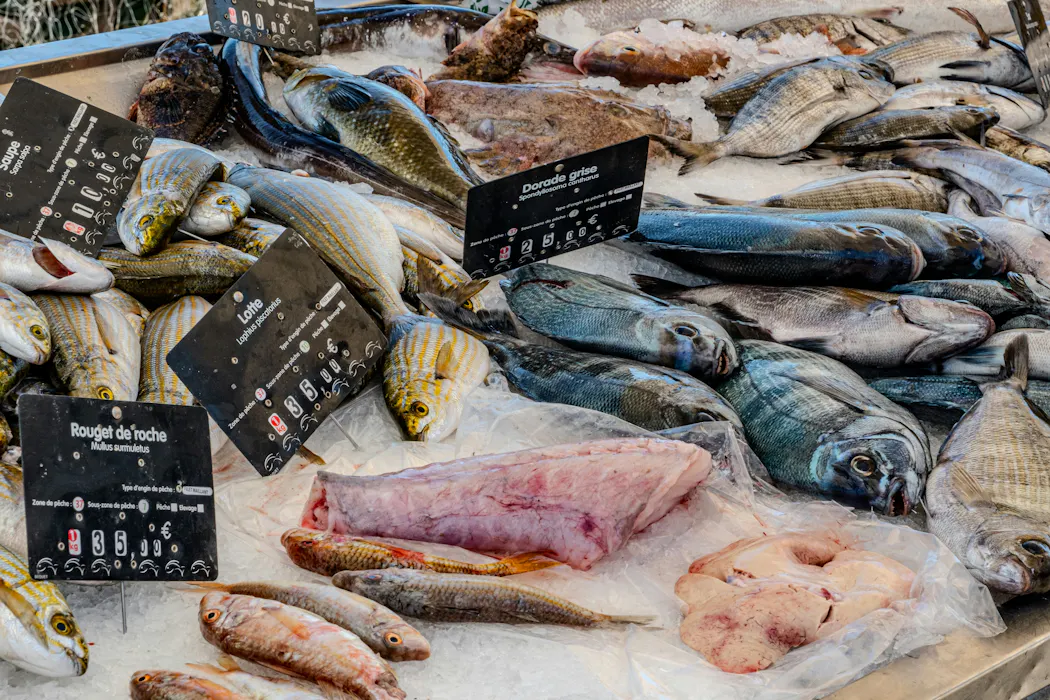
L’ESSENTIEL
On a tendance à manger plus de grands poissons que de petits poissons.
Pourtant privilégier les petits poissons a plus d’un intérêt pour la santé humaine.
La pêche des petits poissons impacte également moins les écosystèmes.
La consommation de poisson bénéficie d’une image très positive auprès des consommateurs européens, surfant notamment sur la vague de ce qu’on appelle la Healthy Food et de la mode de la cuisine japonaise.
Le poisson est perçu comme une nourriture nutritive, peu grasse, riche en micronutriments, et dont l’impact environnemental associé à sa production est relativement faible en comparaison de la viande.
Le succès des gros poissons
Alors que les consommateurs différencient généralement très précisément les espèces à l’origine de la viande qu’ils consomment (poulet, bœuf, porc…), le poisson est généralement considéré dans sa globalité, indépendamment des espèces concernées.
Or, là où moins d’une dizaine d’espèces animales terrestres sont communément consommées pour leur viande, les poissons dits « communs » regroupent plusieurs dizaines d’espèces.
Parmi les poissons les plus consommés en Europe, les grosses espèces, comme le saumon, le cabillaud (nom alimentaire de la morue) ou le thon (il s’agit en réalité de plusieurs espèces regroupées sous cette appellation générique), se taillent la part du lion (de mer), représentant plus d’un quart de la quantité totale consommée.
À l’inverse, les petites espèces, regroupées sous le terme de « petits poissons pélagiques » (sardines, anchois, maquereaux, harengs…) représentent une quantité bien plus faible. Là où les gros poissons bénéficient généralement auprès du consommateur d’une image de nourriture nutritive, saine et naturelle, la perception des petits poissons pélagiques est plutôt celle d’une nourriture certes goûteuse, mais globalement plus traditionnelle, et pour tout dire, un peu vieillotte.
Alors a-t-on raison de privilégier les gros aux petits poissons ?
Plus d’avantages nutritifs chez les petits poissons
De manière générale, tous les poissons sont d’excellentes sources nutritives, et bien que leur composition en nutriments varie d’une espèce à une autre, tous sont de bonnes sources de macro et micronutriments, parmi lesquels le fer, le zinc, le calcium, le sélénium ainsi que les acides gras poly-insaturés oméga-3.
Ces derniers composés sont essentiels au bon fonctionnement de l’organisme (système immunitaire, développement nerveux, échanges cellulaires), et les carences peuvent induire des dysfonctionnements graves au plan nerveux, pouvant aller jusqu’au développement de maladies neurodégénératives ou de cancers. Parmi les oméga-3 les plus intéressants d’un point de vue métabolique, l’acide docosahéxaénoïque (DHA) et l’acide eicosapentaénoïque (EPA) sont quasiment exclusifs aux produits de la mer.
Synthétisés par les microalgues puis transférés le long de la chaîne alimentaire par le biais des organismes aquatiques, les humains dépendent presque exclusivement des produits de la mer pour acquérir ces composés.
Si tous les poissons marins en contiennent en quantités notables, les poissons de l’ordre des Clupéiformes, qui incluent sardines, anchois et harengs, sont connus pour être les plus riches en EPA et en DHA de tous les poissons ainsi qu’en calcium et en zinc.
Ainsi, parmi les centaines d’espèces de poissons consommées à l’échelle mondiale, les petits poissons pélagiques sont certainement ceux qui procurent le plus d’avantages nutritifs. Ils contribuent ainsi pleinement à la sécurité nutritionnelle.
Cette problématique est particulièrement prégnante dans les régions intertropicales, où une part importante de la population demeure exposée à l’insécurité alimentaire. En Afrique de l’Ouest, par exemple, on estime que celle-ci concernait 61,6 % de la population sur la période 2022-2024.
Dans ce contexte, la consommation de poisson, et plus généralement de produits de la mer, représente un potentiel important pour atteindre l’objectif de sécurité alimentaire énoncé par les Nations unies en 2015 comme l’un des 17 grands objectifs de développement durable à l’échelle planétaire.
Quid des polluants ?
En dépit de leur forte valeur nutritive, les poissons sont également soumis aux différentes pollutions qui affectent le milieu marin et qui peuvent s’accumuler dans leur chair, représentant in fine un risque potentiel associé à leur consommation. Deux mécanismes expliquent cette accumulation :
la bioaccumulation, phénomène par lequel les polluants que les organismes ne sont pas capables d’éliminer s’accumulent dans leurs tissus ;
la bioamplification, phénomène par lequel un prédateur accumule les polluants contenus dans la chair de ses proies.
Ainsi, à la fois du fait de la bioamplification et de la bioaccumulation, les gros poissons, qui vivent plus longtemps et sont généralement situés au sommet des chaînes alimentaires, sont théoriquement les plus susceptibles de présenter des niveaux de contamination associés à des risques sanitaires pour les polluants capables de se bioamplifier.
L’exemple le plus marquant est celui du mercure, soumis à ces deux mécanismes. On a ainsi pu observer chez certains grands prédateurs marins des concentrations en mercure dépassant toutes les normes internationales. Dans l’estuaire du Saint-Laurent au Québec (Canada), les carcasses de bélugas échouées sont ainsi traitées comme des déchets toxiques, en dehors des circuits classiques d’équarrissage.
Ce schéma général, qui décrit bien comment certains polluants comme le mercure s’accumulent plus chez les gros poissons que chez les petits, n’est cependant pas valable pour tous les polluants. Les poissons, comme tous les organismes marins, sont en effet soumis à un cocktail de polluants (métaux lourds, polluants organiques persistants, micro et nano-plastiques), qui ont des origines et des voies de contamination diverses, et face auxquels les poissons disposent des capacités de détoxification qui varient en fonction du polluant, et surtout de l’espèce concernée.
L’importance du contexte local
Au-delà de ces mécanismes généraux, il reste néanmoins important de mentionner que l’un des principaux facteurs contrôlant les niveaux de contamination des poissons en divers polluants reste le contexte local. Ainsi, indépendamment de la taille de l’organisme et de la nature du polluant considéré, s’il provient d’un milieu fortement contaminé, il sera plus susceptible de présenter lui-même des niveaux de contamination importants.
Dans une étude comparative des niveaux de contamination en divers polluants parmi plusieurs espèces de poissons marins des trois grandes façades maritimes de France hexagonale, il a ainsi pu être montré que les petites roussettes (Scyliorhinus canuicula) présentaient des niveaux de contamination en arsenic et en mercure entre trois et cinq fois plus élevés en Manche orientale que dans le golfe de Gascogne.
À l’inverse, le merlan (Merluccius merluccius) était huit fois plus contaminé au mercure dans le golfe du Lion, en Méditerranée, que dans le golfe de Gascogne. De même, la pêche des sardines en baie de Seine a été suspendue pendant près de douze ans en raison de leurs niveaux en polluant organique d’origine industrielle (ou PCB) et n’est de nouveau ouverte que depuis 2022, pour les mois d’avril à juin.
Au-delà du choix entre petit et gros poissons, l’origine géographique revêt donc une importance fondamentale en matière de risque sanitaire potentiel.
Quels impacts sur les écosystèmes ?
Enfin, au-delà des bénéfices nutritionnels et des risques potentiels associés à la présence de différents contaminants dans les poissons, un dernier point à considérer concerne les effets associés à leur capture ou à leur production.
La demande mondiale en saumon a conduit à la multiplication des fermes aquacoles intensives, dont les impacts sur l’environnement sont documentés :eutrophisation à proximité des installations, dissémination de pathogènes vers les populations sauvages, échappement d’individus qui viennent s’hybrider avec les populations sauvages.
Par ailleurs, l’alimentation de ces saumons d’élevage est essentiellement basée sur des farines animales produites à partir de petits poissons pélagiques dont la pêche industrielle entre en compétition avec la pêche artisanale de subsistance dans de nombreux pays qui en dépendent pour assurer leur sécurité alimentaire.
Enfin, les densités de poissons dans ces installations aquacoles, qui peuvent atteindre plusieurs dizaines de kilogrammes par mètre cube, posent également des questions fondamentales en matière de bien-être animal.
Les pêcheries thonières en milieu tropical, qui sont à l’origine de l’essentiel des conserves retrouvées en grande surface, ont également des conséquences importantes sur l’environnement, notamment en lien avec les captures accessoires qu’elles engendrent.
Dans le Pacifique oriental, on estime ainsi que, entre 1993 et 2009, en moyenne plus de 45 000 requins, 3 600 raies Manta et plusieurs dizaines de tortues marines sont capturés chaque année. Si les pêcheries thonières n’en sont pas les uniques responsables, elle joue un rôle incontestable dans le déclin de plus de 70 % des populations de requins à l’échelle mondiale de 1970 à 2018.
À l’inverse, du fait de leur durée de vie plus courte, leur maturité précoce et leurs forts taux de reproduction, les petits poissons pélagiques sont relativement moins sensibles à la pression de pêche. Si de nombreuses populations sont néanmoins surexploitées dans le monde, l’atteinte de niveaux d’exploitation cohérents avec un renouvellement naturel des stocks représente un objectif plus réaliste.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Gauthier Schaal a reçu des financements de l'Agence Nationale de la Recherche, de l'Union Européenne (programmes Biodiversa, FEAMPA).
Alice Guillot a reçu des financements de l'Institut de Recherche pour le Développement (IRD), de ISblue (ANR17-EURE-0015), de l'Union Européenne (Biodiversa), et de l'Université de Bretagne Occidentale (UBO).
08.10.2026 à 10:56
De la grossesse à l’accouchement, les pères s’impliquaient déjà dans la naissance des enfants aux XVIIIᵉ et XIXᵉ siècles
Emmanuelle Berthiaud, Maîtresse de conférences en histoire moderne et contemporaine, Université de Picardie Jules Verne (UPJV)
Texte intégral (2688 mots)

L’ESSENTIEL
L’investissement dans la paternité n’est pas une invention contemporaine.
Déjà, aux XVIIIᵉ et au XIXᵉ siècles, des hommes s’engageaient avec leurs épouses dans les préparatifs de naissance.
Cette expérience intime peut s’assortir d’un certain paternalisme et, parfois, suscite des tensions conjugales.
Aujourd’hui, plus de 90 % des pères en France assistent à la naissance de leur bébé, une présence souvent associée à l’émergence, depuis les années 1970, de « nouveaux pères », très tôt investis auprès de leur enfant.
Les périodes antérieures sont volontiers réduites à l’image d’un accouchement exclusivement féminin, dont le père serait absent – à l’exception des naissances royales – et le médecin la seule présence masculine. Cette opposition mérite d’être nuancée. Aux XVIIIᵉ et XIXᵉ siècles, dans un contexte de transformation des modèles familiaux, la mise au monde, le plus souvent réalisée à domicile, n’exclut pas nécessairement les pères ni ne les laisse indifférents.
Variable selon les milieux, les configurations conjugales et les circonstances, leur implication dans la grossesse et l’accouchement est plus ancienne qu’on ne le suppose souvent. À partir d’une recherche publiée dans les Annales de démographie historique, on se concentrera ici sur les pères des élites, pour lesquels la documentation (lettres, sources autobiographiques, images) est la plus abondante et permet de saisir au plus près les formes de cet investissement.
Entre émotions et participation aux préparatifs
Dans une société où la procréation reste une finalité essentielle du mariage, la paternité assure à l’homme une pleine reconnaissance sociale et atteste sa virilité. Dès les premiers signes de grossesse, certains futurs pères s’y investissent : parfois premiers confidents de leur épouse, ils veillent à sa santé et se projettent dans l’arrivée de l’enfant.
Les correspondances du XVIIIᵉ siècle révèlent souvent leur émotion et leurs inquiétudes. Marc de Bombelles, diplomate au service de Louis XVI, se réjouit ainsi en 1778 dans une lettre à son épouse Angélique du « fruit de [leur] amour » qu’elle pourrait porter, tout en redoutant les dangers d’une éventuelle grossesse.
En 1850, Pierre-Joseph Proudhon exprime lui aussi une vive exaltation à l’annonce de sa future paternité :
« Cette nouvelle m’a été bien douce. Le célibataire ne peut imaginer (…) ce qu’est l’amour conjugal et paternel. »

Cette implication ne se réduit pas aux sentiments. Les futurs pères prennent souvent part aux préparatifs de la naissance : choix du prénom, des parrains et marraines, du lieu de naissance, du mode d’allaitement ou du praticien ; ils financent les dépenses et peuvent aider à préparer le trousseau de l’enfant.
Cette participation reste toutefois inégalitaire : l’autorité masculine peut imposer le choix du lieu des couches ou de l’accoucheur, contre les souhaits de l’épouse et au détriment de ses liens familiaux.
Paternalisme et tensions conjugales
La grossesse est aussi un temps de surveillance et de conseils. Dans les élites instruites, notamment au siècle des Lumières, alors que la santé des femmes et des enfants devient un enjeu social majeur, les hommes s’informent et prescrivent parfois la conduite à tenir.
Fort d’une expérience antérieure et de ses lectures, Gabriel-Honoré Riquetti, comte de Mirabeau, prodigue ainsi à Sophie de Monnier, enceinte de ses œuvres en 1777, de nombreux conseils sur son alimentation, son habillement et ses activités. Balzac, Proudhon ou encore Michelet adoptent au XIXᵉ siècle une attitude comparable, à la fois protectrice et directive.
Cette sollicitude témoigne d’un investissement réel, mais aussi d’un paternalisme qui confère à l’homme savoir, autorité et responsabilité envers une compagne jugée vulnérable, surtout si elle est plus jeune. Dans les couples très unis, l’attention portée au corps enceint favorise toutefois une intimité accrue.

Cette proximité cependant est loin d’être générale. La grossesse peut au contraire révéler ou exacerber les tensions conjugales. Certains maris se montrent indifférents aux maux de leur femme, jalousent l’enfant à venir, s’opposent aux dépenses ou à l’influence de la belle-famille. D’autres supportent mal une maternité qui transforme le corps de leur compagne et modifie les rapports conjugaux. Certains personnages de Guy de Maupassant, aux fortes résonances autobiographiques, l’illustrent : dans Une vie (1883) comme dans Mont-Oriol (1887), la reproduction suscite désintérêt, dégoût, voire fuite devant la paternité.
L’investissement masculin n’obéit donc à aucune évolution linéaire : l’arrivée de l’enfant peut renforcer les liens du couple, comme révéler une distance, voire libérer une violence masculine nouvelle.
Les angoisses de l’accouchement
L’accouchement porte cette expérience à son paroxysme. Dans un contexte de forte mortalité maternelle (de 1 à 3 % des accouchements au XVIIIᵉ siècle) et où la douleur est réputée inévitable, la naissance suscite une angoisse considérable, particulièrement lors des premières couches.
Les pères cherchent souvent à rejoindre leur compagne à l’approche du terme ; lorsqu’ils sont éloignés, ils réclament des nouvelles immédiates, d’abord de la mère, puis de l’enfant. Mirabeau veut ainsi savoir au plus vite que Sophie « vit » et « ne souffre plus ». La joie de devenir père ne dissipe donc jamais complètement la peur de perdre la mère ou le nouveau-né.
Contrairement à une idée reçue, les pères des élites assistent assez fréquemment à tout ou partie de l’accouchement à cette époque. Leur exclusion systématique de la salle de naissance est liée au passage à l’accouchement hospitalier dans la première moitié du XXᵉ siècle. À domicile, leur présence peut revêtir plusieurs formes : encourager leur épouse, lui tenir la main ou soutenir son corps pendant les efforts.
Dans la gravure d’Abraham Bosse, l’Accouchement (1633), le mari rassure la parturiente et partage l’espoir que le danger est passé. Dans une Scène de naissance anonyme (v. 1800), il semble maintenir son dos au moment de l’expulsion. Sans faire du père un acteur central de l’accouchement, ces gestes donnent à la naissance une dimension conjugale.

La présence masculine est aussi une expérience de dépossession. Face à la douleur, les pères ne peuvent guère agir ; ils voient leur épouse affronter une épreuve dont ils ne partagent ni les sensations ni les risques. Les normes de genre s’en trouvent souvent inversées : la femme manifeste endurance et courage tandis que l’homme apparaît inquiet, passif, parfois effondré.
Dans l’Amour (1859), Michelet évoque ces pères « défaits, pâles, anéantis », incapables de maîtriser le cours de l’événement. L’intervention d’un accoucheur peut encore accentuer ce sentiment d’impuissance, le mari devant confier la femme aimée aux soins et au regard d’un autre homme.
Reconnaissance et normes de genre
Tous les pères ne réagissent pas de la même manière. Si certains restent pendant tout l’accouchement, d’autres quittent la pièce lors de l’expulsion, parfois à la demande de l’épouse, soucieuse de les épargner. Marie-Thérèse Ollivier écrit ainsi à propos de son mari, ancien ministre de Napoléon III :
« Les douleurs devenant plus fortes, j’allai enfin me coucher, et j’obtins enfin d’Émile qu’il me laissât. Le pauvre ami alla se promener dans le jardin. »
D’autres pères se signalent par leur absence, qui ne signifie pas nécessairement le désintérêt : elle peut tenir aux obligations professionnelles, aux usages familiaux ou à l’incapacité à supporter le spectacle de la souffrance. Elle peut cependant révéler une faible implication dans la grossesse et la vie conjugale, comme chez le poète Paul Verlaine, absent toute la journée de la naissance de son fils en 1871 et déclarant que « les femmes et les enfants, c’était dégoûtant ; qu’on était bien assez bête de se marier ».
Après la naissance, les récits masculins de la découverte de l’enfant oscillent entre fierté, soulagement et fascination. La formule récurrente « ma femme m’a donné un fils » exprime la reconnaissance, souvent admirative, envers l’épouse, qui a surmonté douleurs et danger de mort. Si la préférence pour le garçon demeure forte, l’essor de l’idéal du mariage d’amour favorise une valorisation plus sensible de l’enfant, fille ou garçon, comme prolongement de l’être aimé.
Bien avant l’époque actuelle, des pères ont donc pu s’impliquer dès la grossesse et pendant l’accouchement comme soutien affectif, témoin inquiet et parent en devenir. Cette expérience montre que l’engagement précoce envers l’enfant n’est ni une invention contemporaine ni une spécificité féminine.

Emmanuelle Berthiaud ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
08.10.2026 à 10:56
Quand le régime de Mussolini faisait espionner un opposant par son propre frère
Agnès De Féo, Sociologue, chercheuse associée Iremam, Aix-Marseille Université (AMU)
Texte intégral (3877 mots)
L’ESSENTIEL
En accueillant son frère et son neveu chez lui, Attilio De Feo, antifasciste exilé à Paris, ignorait qu’il abritait deux mouchards à la solde de la police politique fasciste.
De Feo n’a cessé de dénoncer le nationalisme fasciste et l’impérialisme colonial et de contester l’« italianité » mise en avant par le Duce.
Paradoxalement, l’espionnage familial qu’il a subi a permis de préserver sa pensée : les rapports de renseignement documentent ses analyses politiques, notamment sa prédiction de la chute de Mussolini.
Cette histoire est celle de mon grand-père.
L’historiographie du fascisme italien s’est longtemps consacrée aux manifestations visibles du régime de Benito Mussolini. Aujourd’hui, l’étude des trajectoires individuelles des exilés antifascistes (fuorusciti) permet de comprendre comment les régimes totalitaires corrompent les liens sociaux et familiaux pour annihiler toute forme de dissidence, en traquant les opposants où qu’ils se trouvent, jusque dans leur exil.
L’exhumation des archives policières par l’historien italien Giuseppe Galzerano révèle la mécanique de cet espionnage domestique.
L’appareil policier et la trahison fraternelle
La trajectoire d’Attilio De Feo (1894-1982) incarne cette dynamique de la persécution. Né dans le Cilento (province de Salerne), cet artiste peintre et photographe diplômé de l’Académie des beaux-arts de Naples arrive en France en juillet 1932 avec un passeport officiel, justifiant son départ par des impératifs professionnels. Son installation à Paris le plonge dans le monde cosmopolite et intellectuel de l’antifascisme italien.
Rapidement devenu un opposant au régime du Duce, il se livre à une activité militante par voie postale. Il expédie à ses proches en Italie des lettres et des journaux hostiles à la dictature, afin d’éveiller leur conscience politique et de les convaincre de la nocivité du fascisme.
Dès juin 1933, un dossier individuel est ouvert au nom d’Attilio De Feo au sein du Casellario Politico Centrale (CPC) du ministère de l’intérieur fasciste, l’organisme chargé de ficher les éléments subversifs à l’étranger ainsi que les membres de l’opposition restés en Italie. Dans ce dossier sont archivés sa correspondance interceptée, les rapports d’espions et les documents officiels qui décrivent ses moindres faits et gestes.
En 1934, il devient un membre actif du groupe antifasciste Giustizia e Libertà, fondé à Paris par Carlo Rosselli. Quelques années plus tard, son frère aîné, Francesco Paolo De Feo, s’installe chez lui à Paris.
Ce que mon grand-père ignore, c’est que ce frère a été enrôlé comme informateur aux ordres de l’Organisation de la surveillance et de la répression de l’antifascisme (OVRA), la police politique secrète de Mussolini. Francesco Paolo entraîne son propre fils, Domenico, dans cette entreprise de délation.
Pendant des années, profitant de l’hospitalité et de la confiance d’Attilio, le frère et le neveu vont fouiller ses papiers personnels, surveiller ses fréquentations amicales et politiques, et envoyer des rapports réguliers à Rome contre rémunération.
Déconstruire l’« italianité »
Depuis son logement parisien du XVIIᵉ arrondissement, l’artiste élabore une critique radicale de l’appareil idéologique mussolinien. Alors que le régime exalte une « italianité pure, indéfectible, incommensurable », mon grand-père en dénonce le vide dans une lettre cinglante, datée de février 1937, à Catello Tarallo, frère de son épouse, avocat resté au pays :
« Quels grands mots ! Mais qui, pour moi, ne signifient absolument rien. (…) Si tu es fier de tels sentiments, moi, lorsque je pense à l’Italie d’aujourd’hui, à l’Italie de Mussolini, j’ai honte d’être italien. »
Face au repli nationaliste des Chemises noires, l’artiste revendique une identité internationaliste :
« Je suis un internationaliste, c’est-à-dire un homme qui aime son pays autant que les autres pays, qui aime les Italiens autant que les autres peuples (…). Ce n’est pas le bon Dieu, mais des voleurs qui créent les frontières. »
Cet internationalisme se traduit par une condamnation absolue de l’impérialisme colonial. Neuf mois après la victoire italienne sur l’Éthiopie par la prise d’Addis-Abeba en mai 1936, Attilio écrit à Catello pour prendre le contre-pied du discours officiel, qualifiant cette campagne de « plus honteuse victoire de l’histoire d’Italie ».

Il dénonce les milliards engloutis en Afrique qui auraient dû être dépensés en Italie « pour construire des routes, des écoles, des fontaines, installer l’électricité, le gaz ». Pour lui, l’agression d’un peuple souverain relève de « la loi de la jungle ». Il prophétise que, dans l’histoire, la figure du dictateur de Rome sera celle d’un « barbare », tandis que celle du Négus, l’empereur d’Éthiopie défendant sa patrie, « brillera comme celle du défenseur des droits humains les plus élevés et les plus sacrés ».
L’intuition prophétique saisie par l’espionnage
L’analyse des rapports de l’OVRA met au jour la capacité d’Attilio à anticiper l’évolution politique de son pays.
Le 11 mai 1937, l’espion Pietro Francolini transmet à Rome un rapport officiel. Il y indique que Francesco Paolo a rapporté une affirmation de son frère : la chute de Mussolini est inéluctable et imminente, et au régime fasciste succédera une dictature militaire de transition ayant à sa tête le maréchal Badoglio.
Cette intuition se réalisera six ans plus tard, le 25 juillet 1943, lorsque le roi Victor-Emmanuel III destituera le Duce et chargera Pietro Badoglio de diriger le nouveau gouvernement.
Le photographe de la mémoire antifasciste
L’action de mon grand-père dépasse le cadre épistolaire pour s’inscrire dans l’histoire visuelle de la résistance antifasciste. En juin 1937, il devient le photographe officiel des funérailles nationales des frères Carlo et Nello Rosselli, leaders du mouvement Giustizia e Libertà assassinés en France par la Cagoule sur ordre direct de Rome.
Ce rassemblement réunit plus de 100 000 personnes à Paris. Les clichés pris par De Feo, sur lesquelles on reconnaît les figures de proue de l’exil (Emilio Lussu, Francesco Fausto Nitti, Silvio Trentin), capturent le deuil collectif et formalisent la légitimité politique de la résistance.
Cette activité militante représentait un grand risque. Apparaître dans ces cortèges exposait les exilés à une inscription immédiate au fichier des subversifs à Rome et à des représailles de l’OVRA sur le sol français. L’assassinat des Rosselli venait de prouver que le bras armé de Mussolini pouvait frapper en plein cœur de la France. En mobilisant les droits démocratiques de leur pays d’accueil, mon grand-père et ses camarades ont structuré la mémoire de leur combat.
L’épreuve de la guerre et la sentence définitive
Le déclenchement de la Seconde Guerre mondiale accentue la radicalité d’Attilio De Feo. En octobre 1939, dans une lettre à sa belle-sœur Giovanna, épouse de Catello, il conserve une confiance absolue dans l’effondrement des dictatures totalitaires :
« Quoi qu’il en soit, la France et l’Angleterre vaincront certainement, et l’on pourra enfin respirer un peu d’air pur et libre. Une chose est sûre : l’heure a sonné. La fin des brigands est certaine. »
Attilio constate la faillite de ses proches restés en Italie, qu’il attribue directement à leur soumission au fascisme. S’en prenant à son beau-frère Catello, il assimile la parole du fasciste local à celle du dictateur allemand :
« Ton mari est comme une monnaie qui n’a plus cours. Sa parole vaut celle d’Hitler, elle n’a plus aucune valeur. »
C’est dans cette même lettre qu’il livre sa sentence sur ceux qui servent l’idéologie totalitaire :
« Je hais les fascistes parce qu’ils sont malhonnêtes, faux, menteurs et, surtout, lâches. »
Après l’Occupation, Attilio De Feo a poursuivi son engagement militant au sein des réseaux de résistance d’immigrés italiens autour de Toulouse, en Haute-Garonne. À la Libération, il a participé à la prise d’assaut du consulat d’Italie à Toulouse, qui est alors devenu un quartier général pour épurer les réseaux fascistes.
Francesco Paolo et son fils Domenico ont tous deux été démasqués en Italie, voyant leurs noms figurer sur la liste noire des informateurs et des espions de l’OVRA, publiée le 2 juillet 1946.
En déployant une surveillance considérable et en rétribuant le propre frère et le neveu d’Attilio De Feo pour le trahir, la machine totalitaire a involontairement sauvegardé le témoignage d’une pensée humaniste, intègre et visionnaire. C’est là que réside le paradoxe de cette oppression : en documentant minutieusement chacun de ses pas, les archives de la police politique ont échoué à le faire disparaître. Éclairés aujourd’hui par le travail de l’historien Giuseppe Galzerano, ces dossiers secrets nous donnent enfin un accès direct à la vie et à la pensée d’Attilio De Feo.

Agnès De Féo ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
07.10.2026 à 17:33
Quiz – De la grossesse à l’accouchement, les pères s’impliquaient déjà dans la naissance des enfants aux XVIIIᵉ et XIXᵉ siècles
Cécile Vangrevenynge, Chargée de marketing digital et des partenariats, The Conversation
Lire + (251 mots)
Grossesse, naissance, paternité… Aux XVIIIᵉ et XIXᵉ siècles, ces moments de la vie familiale étaient entourés de pratiques et de représentations bien différentes des nôtres.
Mais que savons-nous vraiment de la manière dont on vivait une naissance à cette époque ?
À vous de tester vos connaissances !
Avant de jouer, prenez quelques minutes pour lire l’article « De la grossesse à l’accouchement, les pères s’impliquaient déjà dans la naissance des enfants aux XVIIIᵉ et XIXᵉ siècles ».
3, 2, 1… À vous !
Pour recevoir le quiz chaque semaine dans votre boîte mail, abonnez-vous à notre newsletter hebdomadaire le Débrief.
Chaque samedi, un pas de côté sur l’actu pour mieux comprendre le monde qui nous entoure.

07.10.2026 à 17:11
Why the student protests in France and the government’s response are unprecedented and unpredictable
Robi Morder, Chercheur Associé au Laboratoire Printemps, UVSQ/Paris-Saclay, co-président du Groupe d'études et de recherches sur les mouvements étudiants (Germe), Université de Versailles Saint-Quentin-en-Yvelines (UVSQ) – Université Paris-Saclay
Texte intégral (1889 mots)
KEY TAKEAWAYS
The mass nationwide movement led by high school students, joined by their parents, teachers and trade unions, brought together 450,000 protesters on October 6 (250,000, according to the French government).
French lycée students’ demands for better resources and conditions in schools are recurrent, but what’s new is the global context, the nature of the movement and where it started out: in France’s working suburbs.
The government’s response, which first opted for confrontation before favouring negotiations, has created an explosive situation whose outcome is very uncertain.
The mobilisation behind the high schoolers’ movement that began in the Paris suburbs in September 2026 is in continuity with the back-to-school action in response to situations that are deemed to have worsened (absent teachers, overcrowded classrooms, dilapidated premises, etc.) that secondary education has been experiencing in a cyclical manner since the end of the 1970s, contrasting with the type of “Spring” uprisings that characterised the youth action of the period that was known as the “68 years”.
In 1978 it was already noted that what had previously characterised technical secondary schools and vocational colleges (commonly known in France as “LT and CET”) had become a general problem for all high schools in the country.
“The school year of 1978 turned out to be a calamity, with overcrowded classes and a lack of teachers and staff. In Seine-Saint-Denis in the northern suburbs of Paris, there were doubts over whether school would ever be resumed. From September 15, with the backing of parent associations and many local elected officials, teachers at high schools in Saint-Denis and Noisy-le-Sec went on strike calling for new teaching positions and classes to be opened. For the first time since May-June 1968, establishments in France were occupied day and night, particularly schools in Saint-Denis, Aubervilliers, Montreuil, (Greater Paris’ Seine-Saint-Denis Department).”
An extract from Quand les lycéens prenaient la parole. Les années 68 by Didier Leschi and Robi Morder (Syllepse 2018).
These recurring issues also gave rise to student uprisings in 1990 and 1998, leading then to significant measures that were considered victories. Movements occurring in the autumn have also affected high school students, but on other topics such as pension reform, the focus of a movement in 2010.
What is unprecedented in the autumn 2026 mobilisation is first and foremost the global context, with a war in Eastern Europe accompanied by an increase in military budgets that contrasts with a chronic shortfall in funding for education, a climate crisis that is impacting poorly insulated schools where high school students suffer from extreme heat and the prospect of a far right presidential win in 2027. This last challenge may have been experienced as an ‘existential threat’ by many high school students in working-class suburbs where the movement started out.
How can students make their voices heard?
To assert their demands, the options students have for taking action are limited. High school representation exists in law (students sit on boards of directors and within national institutions with the French Ministry for Education) but with little scope.
Apart from not being a right that high school students are entitled to, going on strike is simply time off and by no means a pressure tactic (a high school strike does not bother anyone and does not stop any production). As a result, for a high school movement to have any clout, deserting the classroom is not enough; students also need to make themselves seen, heard and media-friendly.
It is worth noting the shift in vocabulary over the last few decades. “Picket” has been replaced by “block”, or“blockade”, especially since the high school movement against the Fillon law in 2005. The general assemblies that were held in high schools, deciding on strike pickets (“filtering” pickets or “blockading” pickets) have become more difficult to organise, especially when administrations do not allow them, sometimes simply because of the lack of classrooms. From now on, upper secondary establishments and administrations no longer talk about lycées that are on strike but are counting the number of “blockaded lycées”.
To be visible, students therefore need to resort to spectacular action. Like every social group, high schoolers use what’s available to them: trash cans to blockade or slow down human traffic in front of high schools, holding demonstrations in their neighbourhood or town – with prohibitive measures somewhat getting in the way, this is admittedly more difficult – calling on public figures (elected officials, for example) likely to attract the curiosity of the media, protest signs, etc.
It is within this context that the issue of violence comes into play. While we wait for more specific information about the profiles of the youngsters arrested, we do know that the vast majority of them are minors. But are they high school students or young people who have left, or been excluded, from the education system? The circumstances, the alleged facts, may differ from one individual to another.
In the meantime, it’s worth recalling that in the early days of May 68 in Paris’ Latin Quarter, there were a significant number of young workers who stood alongside students to seek revenge on the police for humiliating them on their council housing estates and in their neighbourhoods, according to French sociologist Gérard Mauger.
The current crisis blends the characteristics of high school student uprisings with those associated with the “proto-political unrest” in France’s suburbs – notably in 2005. Let us note that the term “suburban youth” extends to high school students and other students, sometimes unemployed or living precariously. Their actions and reactions target their places of study, work, and where they live. High school demonstrations are also places where people come together at a local level.
An unprecedented police response towards teenagers
What is also singular is the way in which the public authorities have ignored the situation, while shortages of resources and staff are regularly reported, and once again this autumn, by teachers’ unions.
If governments in France since 2017 have experienced unprecedented conflicts, such as the Yellow Vest movement, the Sainte-Soline environmental protest rally (against a huge water reserve), urban unrest, high school or student uprisings are recurrent and are likely to be resolved through negotiation. However, since the loi travail legislation in 2016, the reaction of “firmness” by the powers that has seemingly become the norm, at the risk of violent clashes, making it dangerous to be present at protests – even though they are legal. When applied to teenagers, it clearly appears disproportionate and dangerous.
It seems that, after ignoring the scale of the problems at hand, the choice of repression has prevailed. It was the French Interior Ministry that came to the fore, favouring mass closures of establishments nationwide. France had experienced some exceptional closures following past student movements, but never on such a scale.
After releasing a statement claiming ‘political hijacking’ of the movement by France’s far-left party LFI due to the party’s show of strong support and the presence of its elected representatives outside institutions (while other parties did the same), the government’s rhetoric finally admitted that students’ demands were legitimate. Undoubtedly, the public opinion in France, approving the legitimacy of the demands being made by high school students will have strengthened the movement but also the scale – as well as their good behaviour – of the October 6 demonstrations. The unions announced 450,000 protesters, whereas the Ministry estimated 250,000 demonstrators nationwide.
But, when there’s negotiation, power dynamics come into play. What was possible before the student movement to try and “calm the situation” is proving insufficient today, especially as the mobilisation has been maintained and extended, and since the threat of an extension to students and a junction with other forms of discontent weigh heavily on the government. On social media, which is widely used by young people, many references are not only being made to protests with other unions but to October 17 – a movement marking the return of the Yellow Vests. Somehow the bids are rising.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Robi Morder is a member of the French Higher Education trade union SNESup, and the non-profit Association autogestion, RESU.
07.10.2026 à 16:54
De la lettre à Internet : communiquons-nous désormais en temps réel ?
Jérôme Bourdon, Hstorien des médias, chercheur associé au CARISM, Université Paris-Panthéon-Assas; Tel Aviv University
Texte intégral (3192 mots)
L’ESSENTIEL
Dans la Présence à distance. Des lettres de l’Antiquité aux réseaux sociaux, paru en septembre 2026 aux éditions Flammarion, Jérôme Bourdon explore notre rêve très ancien de communication (quasi) immédiate.
On pourrait croire que le numérique a mis fin à l'attente du message tant espéré.
Pour l’auteur, ce n’est pas le cas : l’attente n’a pas disparu, elle s’est métamorphosée. Extrait.
WhatsApp, téléphone, SMS, notes vocales : nous voici présents les un·es aux autres à distance, en « temps réel ». On pourrait croire que le numérique est venu récemment satisfaire un vœu typique de la modernité, âge de la vitesse : mettre fin à l’attente si longue parfois du message de l’être aimé, du parent, de l’ami, de l’enfant.
En historien, nous voulons ici réfuter cette perspective. Tout d’abord, le désir de communication (quasi) immédiate est un rêve très ancien. De surcroît, malgré toutes les performances de la technologie, il n’est pas près d’être satisfait. Loin d’avoir disparu, l’attente s’est profondément métamorphosée.
Par-delà les gouffres épistolaires : un très vieux rêve de vitesse
Au temps du Nouvel Empire égyptien (1552-1070 av. notre ère), un amant et poète s’adresse à sa propre lettre :
« Oh si tu pouvais venir en hâte vers la bien-aimée
Comme le courrier royal
Dont la monture attend le messager avec impatience
Son cœur aspirant à l’entendre
Des écuries entières sont harnachées pour lui
Les chevaux l’attendent aux étapes
Le char attelé est à sa place
Le courrier n’a pas de répit en route
Son cœur s’abandonne à sa joie ».
Ce texte est un exemple des nombreux poèmes anciens, épistolaires ou non, qui se réfèrent à la communication à distance, par la poste, par le messager. Il fait écho à un désir récurrent partout où existait un service épistolaire impérial, dont les montures déboulaient sur les meilleures routes en terrifiant les passants : avoir accès à cette poste express.
Les premiers systèmes postaux des empires de l’Antiquité envoyaient des messagers à pied, puis très vite à dos de cheval, dès l’Égypte ancienne, il y a quelque quatre mille ans, plus tard en Chine ou à dos de mule dans l’empire néo-assyrien de Sargon, au IXᵉ siècle av. notre ère.
Quatre siècles plus tard Hérodote (Histoires, VIII, 98) et Xénophon (Cyropédie, VIII, ch. 6.17-18) font de Cyrus, souverain perse admiré, l’inventeur de la poste à relais, fondée sur des trajets d’une journée par cheval et cavalier régulièrement remplacés. Cette innovation décisive a conditionné la présence à distance jusqu’au XIXᵉ siècle quand le train, la voiture, le vélo, puis l’avion font disparaître d’immenses écuries.
Ces postes n’étaient pas destinées à la communication interpersonnelle, mais à l’administration de très vastes territoires, notamment à la surveillance aux frontières. Cependant, leur souci d’efficacité et leur obsession de la mesure (pour nous très imprécise) nous sont familiers.
À défaut de système postal, les privilégiés et les moins privilégiés recourent massivement au messager, à l’esclave ou à l’affranchi dévoués, à l’ami ou au parent aussi ou, dans les empires maritimes, de la Grèce ancienne ou de l’Angleterre de la première modernité, le capitaine du vaisseau qui prend avec lui bien souvent un sac de courrier. Ils dictent aussi leur missive à l’ami, à l’écrivain public. Et parfois ce n’est pas à la poste mais au port que l’on court, le cœur gonflé d’espoir (comme Pénélope imaginée par Ovide).
Dans la Rome impériale, ce messager porte-lettre est le tabellarius, celui qui porte le tabellum, la tablette enduite de cire que l’on efface et réutilise. Pour la longue distance, les lettres plus importantes, on utilise le papyrus (pensons au contraste entre nos messageries et l’email). Les puissants de ce monde, les grandes villes, les monastères, auront leurs messagers.
Au XVᵉ siècle, un accès élargi à la correspondance
L’accès à la correspondance s’élargit quand, au XVᵉ siècle, les princes de Milan inaugurent les postes ouvertes au public, qui seront imitées à travers l’Europe. Leurs bordereaux énumèrent les heures d’arrivée et de départ des malles-poste, parfois augmentés d’une formule (en latin) :
« Que les porteurs se déplacent de jour et de nuit non pas rapidement, mais comme la foudre, qu’ils courent vite, vite, vite. »
La foudre nourrira l'imaginaire de la vitesse jusqu’au télégraphe. La poste est aussi intimement liée au progrès de la mesure du temps et de l’espace : elle est parmi les premiers usagers de la carte qui épouse mieux l’espace réel, de l’horloge (voire la montre, à gousset, pas encore bracelet), du calendrier. Pour dire « au plus vite », on invente les expressions posthaste en anglais, « en poste » en français.
Ouverture au public et régularité du service, d’abord hebdomadaire puis plus fréquent, créent un nouveau service dont les usagers règlent leurs envois sur l’heure des départs, leurs espérances sur celles des arrivées et sur la carte on peut suivre les lettres, et les proches aussi.
Madame de Sévigné à sa fille, le 9 février 1671, après une séparation qui la ronge :
« J’ai une carte devant les yeux ; je sais tous les lieux où vous couchez : vous êtes ce soir à Nevers, et vous serez dimanche à Lyon, où vous recevrez cette lettre. Je n’ai pu vous écrire qu’à Moulins par Mme de Guénégaud. »
[…] Lorsque nous suivons sur l’écran nos paquets, nous appartenons plus au monde de Sévigné qu’à celui d’Ovide en exil aux bords de la mer Noire, dont le correspondant romain mettait sa lettre dans les mains d’un voyageur plus ou moins fiable, pour un très long parcours, mesuré plus en légendes et dangers qu’en unités de temps et d’espace, vers la frontière de l’œkoumène, ce monde connu au-delà duquel on pouvait tout imaginer.
Au XIXᵉ siècle, l’essor postal, une révolution
En 1839, la réforme britannique de Rowland Hill, vite imitée, inaugure la poste bon marché : c’est la « poste à un sou », non moins importante que la « presse à un sou » dans l’histoire des communications. « Révolution bureaucratique », discrète, elle est vite routinisée. Pourtant, quel changement ! De 1874 à 2006, le nombre total de lettres qui circulent sur la planète passe de 6,2 milliards à 4 235 milliards par an.
Le plus vieux média du monde vient de s’effacer sous nos yeux, à bas bruit. Si le XXᵉ siècle a été l’âge du téléphone, de la radio, de la télévision, la poste de masse n’a pas joué un rôle moins important. La carte postale (autre innovation bureaucratique alors remarquée, à la fin du XIXᵉ siècle) semble résister.
Les contemporains de l’essor postal sont plus sensibles aux « nouvelles technologies ». Le télégraphe électrique de Morse, inauguré en 1844, est perçu comme un changement radical. Rendez-vous compte : ceci se passe loin de vous, en ce moment même, et vous le savez sans attendre. Ce qui nous est banal était alors quasiment inconcevable. L’instantanéité était relative, car il fallait, entre la composition et la transmission du message, plusieurs minutes parfois, et lorsque le télégraphe se répand, il faudra aller à la poste jusqu’au télégraphe téléphoné qui ne concernera qu’une minorité de la planète. Mais peu importe : le télégraphe fait parler, pour la première, de la « mort de la distance », ce mythe moderne que redécouvriront les commentateurs de l’Internet.
Avec le mail, la distance est-elle caduque ?
N’y sommes-nous pas encore ? Certes, nos emails, et plus encore nos SMS et WhatsApp, ressemblent à un télégraphe universel, instantané, portable. Mais il faut distinguer les réalités de la communication des promesses du « temps réel ». Cette expression, née après guerre à propos des capacités de calcul de l'ordinateur, est devenue un outil de marketing, accroché à un rêve millénaire : pour vendre, pour contacter un proche, pour appeler un service de sécurité en cas de danger, des publicités nous le martèlent, l’autre est à portée de pression d’un bouton, ce geste magique de la modernité.
Plusieurs facteurs compliquent l’avènement du temps réel. D’abord, les machines nous déçoivent et nous font courir après ce temps réel trop promis. Le lag (le léger décalage) perturbe bien des échanges ; plus grave, le buffering, la mise en mémoire tampon, nous surprend dans une vidéoconversation dont notre partenaire soudain s’est figé comme frappé par un rayon paralysant, avant de réapparaître avec d’étranges convulsions.
L’Internet est aussi pris dans sa propre course à la vitesse : les capacités courent après la croissance considérable des usages, d’où un décalage permanent entre la prétendue perfection technique et une énorme machine faite de milliers de câbles, de serveurs, d’émetteurs, de data centers (et non de « nuages » ou de « flots »), qui défaille parfois et dépend d’une autre révolution technologique très vite acclimatée, celle de la fée électricité. Mais la fée parfois s’endort, et nos réseaux avec.
Surtout, pour être en temps réel avec autrui, pleinement, il faut un désir mutuel. Ce « temps réel social » est encore plus fragile, plus loin de nous, que le temps réel technique. Nos expériences ne sont pas les mêmes, nos volontés de partage se fracassent sur les contrariétés, les activités différentes, à l’autre bout de la ligne (Almodovar, dans son dernier film Amarga Navidad (Autofiction, 2026), se régale de ces mécommunications).
Au buffering, il faut ajouter le ghosting, que les épistolier·es connaissaient bien. Et demeure la géographie : l’irrécusable décalage horaire, qui oblige à des prises de rendez-vous (comme dans le monde physique) pour être, enfin, ensemble en même temps. Ceux qui jouent en ligne dans des univers virtuels savent parfaitement qu’il faut attendre que le maître de jeu, c’est-à-dire du fuseau horaire dominant, décide de l’heure adéquate, c’est toujours la Californie sur Second Life, le premier monde virtuel en ligne.
Troisième facteur : la dispersion d’une attention hypersollicitée par un système commercial d’une agressivité sans précédent. À distance, la multiplicité des contacts, la navigation complexe qu’il faut mener pour faire attendre l’un, pour répondre à l’autre, entraîne une multiplication des microattentes. Nos correspondants de toutes sortes se réclament à nous de façon nouvelle, exigeante, chorale, mêlant les liens faibles et intimes, les messages désirés et les intrusions irritantes. L’ancêtre de l’Internet, c’est ici la grande ville, vecteur de publicité, de rencontres, puissante captatrice d’attention comme le perçut, dès 1902, Simmel.
Et, d’ailleurs, désirons-nous tellement être en temps réel avec autrui ? Il y faudrait la télépathie, autre mot forgé au XIXᵉ siècle. Des savants en explorent la possibilité, entre espoir et frayeur de l’emprise qu’exercerait cet autre envahissant notre esprit, dans l’immédiateté de son désir.
Jérôme Bourdon est l’auteur de la Présence à distance. Des lettres de l’Antiquité aux réseaux sociaux, paru en septembre 2026 aux éditions Flammarion.

Jérôme Bourdon ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
07.10.2026 à 16:54
Des variétés résistantes pour sauver la vigne : les consommateurs sont-ils prêts à changer de goûts et les vignerons à les adopter ?
Olivier Geffroy, Enseignant-Chercheur en viticulture, oenologie et analyse sensorielle, École d'Ingénieurs de Purpan
Caroline Paire, Doctorante en Sciences de gestion, Montpellier SupAgro
Christian Chervin, Professeur Viticulture et Oenologie, Toulouse INP
Foued Cheriet, Professeur en stratégie internationale et en marketing alimentaire/vin, Montpellier SupAgro
Valérie Olivier, Enseignant-Chercheur en économie des filières agricoles et biosourcées, Toulouse INP
Texte intégral (2060 mots)
L’ESSENTIEL
De nouvelles variétés de vigne résistantes aux principales maladies fongiques sont aujourd’hui disponibles à la plantation.
Malgré leur intérêt pour réduire jusqu’à 80 % de traitements phytosanitaires, leur adoption progresse lentement et l’offre commerciale reste limitée.
Des travaux menés en Occitanie dans le cadre du projet Ressenti et du Défi Clé Vinid’Occ permettent d’envisager leur avenir avec un certain optimisme.
Ces travaux Ressenti et Vinid’Occ visent à identifier les leviers et les freins à l’adoption de ces nouvelles variétés, notamment celles récemment inscrites au catalogue français et accessibles aux viticulteurs, afin de mieux comprendre les conditions nécessaires à leur développement.
Depuis 2023, ce projet pluridisciplinaire associe un consortium de chercheurs toulousains et montpelliérains autour de deux thèses de doctorat. Il combine des enquêtes et des évaluations sensorielles auprès des acteurs de la filière et des consommateurs, ainsi que des approches de neuromarketing pour analyser les réactions face à ces nouveaux vins.
Stratégie d’hybridation
La vigne d’origine européenne cultivée dans nos vignobles appartient à l’espèce Vitis vinifera, du latin vinifera « qui donne le vin ». Au cours du XIXᵉ siècle, elle est mise en péril par l’introduction depuis le continent nord-américain de plusieurs pathogènes – phylloxera, mildiou ou oïdium – auxquels elle n’avait jamais été confrontée.
En plus de Vitis vinifera, d’autres espèces de vigne américaines, comme Vitis labrusca ou Vitis rupestris, ont en revanche développé, en co-évoluant avec ces pathogènes sur de longues périodes, des mécanismes adaptatifs de résistance. Ces espèces peuvent être croisées avec Vitis vinifera ; elles donnent des descendants viables, fructifères, ayant hérité d’une partie du génome de chacun des parents, incluant parfois des traits de résistance aux maladies.
Cette stratégie d’hybridation interspécifique a été utilisée de manière non dirigée au cours de l’histoire pour développer des espèces hybrides. Ces dernières possèdent une résistance aux maladies variable et donnent des vins de qualité œnologique généralement inférieure. Depuis 1935, six de ces hybrides – Clinton, Herbemont, Isabelle, Jacquez, Noah et Othello – ont été interdits en France pour produire du vin, du fait d’une aptitude supposée supérieure à produire des vins riches en méthanol et potentiellement dangereux pour la santé. Grâce à la persévérance d’un collectif cévenol, ces six hybrides sont en passe d’être de nouveau autorisés.
L’une des stratégies pour atténuer ces traits négatifs est de procéder à des rétrocroisements successifs avec Vitis vinifera pour ne conserver de l’espèce américaine que les gènes de résistance. Ces étapes très chronophages nécessitent de mesurer les caractéristiques des plants, de sélectionner ceux d’intérêt avant de procéder à un nouveau croisement.
Création variétale française
Les progrès de la génétique ont permis de gagner du temps, en repérant la présence des gènes d’intérêt à l’aide de marqueurs. La France, comme l’Allemagne, la Suisse et l’Italie, fait partie des leaders mondiaux en matière de création de ces variétés.
La stratégie nationale est prudente puisqu’elle vise à combiner plusieurs gènes, afin d’améliorer la résistance et d’éviter des contournements, c’est-à-dire la possibilité que certaines souches de pathogènes plus virulentes se développent sur ces variétés.
Depuis 2017, les premiers fruits de la création variétale française – les cépages floréal, voltis, artaban et vidoc – peuvent être plantés par les vignerons. Depuis ces premières inscriptions au catalogue national, plusieurs inscriptions ont suivi notamment les variétés dites Inrae-Bouquet, du nom d’Alain Bouquet, chercheur pionnier de l’Inrae.
Adoption de ces nouvelles variétés
En 2021, ces variétés représentaient 1 208 hectares de vignoble, soit seulement 0,15 % du vignoble français, avec une lente progression des plantations majoritairement localisées en Occitanie. La Champagne est une autre région pionnière qui expérimente ces variétés depuis plusieurs années.
Une analyse médiatique a montré que ces variétés étaient très peu présentes dans la presse généraliste, illustrant leur manque de visibilité. Au contraire, dans la presse viticole spécialisée, un consensus émerge en leur faveur, notamment au fil des évolutions réglementaires. Depuis 2018, leur culture expérimentale est autorisée dans certaines appellations d’origine protégées (AOP) grâce à la directive dite variété d’intérêt à fin d’adaptation (Vifa).
Même si les choses évoluent rapidement, l’offre est encore restreinte avec seulement 108 références commerciales identifiées en 2024.
Des signaux encourageants
D’un point de vue sensoriel, les travaux de Caroline Paire, doctorante sur le projet, ont montré qu’il existait une diversité de profils comparable aux vins conventionnels. Ils ont également mis en évidence qu’il n’y avait aucun obstacle sensoriel à l’acceptation des vins issus de ces variétés par les consommateurs, en blanc comme en rouge, en assemblage ou en cuvée monovariétale :
« Les professionnels restaient sceptiques vis-à-vis de ces nouvelles variétés, notamment pour les rouges dont ils jugeaient les vins rustiques, acides et de moindre qualité. L’utilisation de vidoc ou d’artaban, en assemblage avec du merlot, ne pénalise pas l’appréciation lors de nos essais. Nous avons identifié un seul groupe de consommateurs composé d’hommes âgés de plus de 65 ans et consommant du vin quotidiennement, préférant systématiquement les vins de Merlot pur. »
La question du nom à adosser à ces variétés est un sujet qui cristallise des tensions au sein de la profession. Certains acteurs souhaitent les désigner en référence à leurs géniteurs, une approche non cautionnée par les instances en charge de leur agrément. D’autres travaux en cours de publication montrent que la dégustation reste le juge de paix comme le souligne Caroline Paire :
« Le nom importe finalement peu au consommateur, dont les connaissances en la matière sont limitées. Lors de nos expérimentations, le cabernet blanc, une variété résistante blanche développée en Allemagne, a été fréquemment confondue avec le cabernet-sauvignon, le cépage rouge roi du Bordelais et la variété de cuve la plus plantée au monde. »
« Eye-tracking »
Des groupes de discussion couplés à des expériences d’eye-tracking, un dispositif utilisé en neuromarketing suivant les mouvements oculaires et analysant les signaux captant l’attention des consommateurs, ont été menés. La conclusion ? La propension à réduire de 80 % le nombre de traitements chimiques de ces variétés devait être utilisée pour communiquer autour de la résistance, de préférence sous la forme d’un logo ou d’une pastille.
À lire aussi : Les enfants voient l’art différemment : ce que nous apprennent les dernières recherches d’« eye-tracking »
Trois profils de producteurs
Le producteur, quant à lui, est tout aussi incapable que le consommateur de distinguer à la dégustation les deux types de vin. Le travail de l’équipe Ressenti a permis d’identifier trois profils :
les « sceptiques », professionnels plus âgés issus de caves particulières ;
les « réceptifs », coopérateurs manifestant un soutien mesuré à l’innovation ;
les « observateurs », jeunes professionnels sans pouvoir de décision.
Les 96 producteurs interrogés par Marc-Antoine Dolet, autre doctorant sur le projet, estiment que ces variétés pourraient couvrir jusqu’à 25 % du vignoble occitan d’ici trente ans.
Du consommateur au producteur, les signaux sont globalement au vert et laissent envisager un bel avenir pour ces nouvelles variétés. L’inconnue qui demeure est de savoir si la crise structurelle et profonde qui secoue le vignoble français et mondial agira comme accélérateur ou comme frein.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Le projet Ressenti a reçu une subvention de la part de la région Occitanie, et un co-financement des Vignobles Foncalieu et des Grands Chais de France.
Caroline Paire a reçu des financements de la Région Occitanie.
Christian Chervin a reçu des financements de la région Occitanie.
Foued Cheriet a reçu des financements de la Région Occitanie.
Valérie Olivier ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
07.10.2026 à 16:53
Conserver les aliments périssables sans emballages plastiques : où en est-on ?
Élodie Choque, Maitre de conférence en microbiologie, Université de Picardie Jules Verne (UPJV)
Texte intégral (3011 mots)
L’ESSENTIEL
Les emballages plastiques représentent plus de 40 % de nos déchets plastiques au niveau mondial. Pour mettre un terme à la pollution plastique et décarboner l’économie, il va falloir apprendre à s’en passer.
Leur remplacement par des alternatives biosourcées et biodégradables se heurte toutefois à plusieurs freins d’ordre scientifique et technique. Les alternatives ne présentant pas, pour l’heure, toutes les propriétés requises.
Mais les attentes, parfois contradictoires, du consommateur sont également en cause : celui-ci s’agacera facilement d’un emballage alternatif qui ne serait dégradable qu’en composteur industriel, mais refusera d’acheter un aliment dont l’emballage serait opaque – plutôt que transparent – et ne permettrait pas de s’assurer de l’état de fraîcheur avant achat.
Chaque jour, des millions de barquettes, de films transparents et de sachets souples sont jetés après quelques heures ou quelques jours d’utilisation à peine. Le plastique pétrochimique s’est imposé au siècle dernier comme le maître incontesté de nos rayons alimentaires, mais son règne doit désormais toucher à sa fin, impératifs de décarbonation et de lutte contre la pollution plastique obligent.
Mais remplacer ce matériau polyvalent et bon marché sans sacrifier la fraîcheur de nos aliments relève d’un véritable défi scientifique et industriel. État des lieux.
Le contexte réglementaire et environnemental
Le constat environnemental est alarmant : le secteur de l’emballage représente près de 40 % des déchets plastiques générés dans le monde. La majeure partie de ces conditionnements est à usage unique et finit dans les incinérateurs, dans les décharges ou, plus grave encore, dans les écosystèmes marins et terrestres.
Ces plastiques ne disparaissent jamais vraiment. Ils se fragmentent en micro et nanoplastiques qui contaminent la chaîne alimentaire, les sols et les ressources en eau. De plus, la fabrication de ces polymères synthétiques repose sur l’extraction d’énergies fossiles, contribuant directement aux émissions de gaz à effet de serre.
À lire aussi : Comment le plastique est devenu incontournable dans l’industrie agroalimentaire
Face à cette crise, la puissance publique a pris le relais des alertes scientifiques.
En France, la loi Anti-gaspillage pour une économie circulaire (Agec) impose une sortie progressive du plastique jetable à l’horizon 2040, avec des jalons stricts concernant la réduction des emballages, le réemploi et l’interdiction de certains formats, comme le suremballage de nombreux fruits et légumes.
Au niveau européen, la révision du règlement relatif aux emballages et aux déchets d’emballages (PPWR, pour Packaging and Packaging Waste Regulation) fixe des objectifs contraignants pour l’ensemble des États membres : réduction nette du volume global des déchets d’emballages, obligation d’intégrer des taux minimaux de matière recyclée dans les nouveaux conditionnements, interdiction ciblée de certains emballages plastiques à usage unique dans la restauration et le commerce de détail ou encore harmonisation des critères de recyclabilité d’ici à 2030.
Cette tenaille réglementaire et environnementale force les industriels de l’agroalimentaire et la recherche en science des matériaux à réinventer d’urgence la protection de nos aliments.
À lire aussi : Plastiques : pour une meilleure gestion de l’emballage, du recyclage et de la consommation
Qu’est-ce qu’une denrée périssable ?
En science des aliments, une denrée périssable désigne tout produit biologique sujet à une détérioration rapide et inévitable si des conditions de conservation strictes ne sont pas appliquées.
Contrairement aux produits dits « stables » (comme le riz sec ou les conserves) ou « semi-périssables » (comme les pommes de terre ou le miel), les denrées périssables possèdent une durée de vie limitée, souvent mesurée en jours ou en semaines. Sur le plan réglementaire, elles sont identifiées par une date limite de consommation (DLC), indiquée par la mention « À consommer jusqu’au… ». Dépasser cette date présente un risque direct potentiel pour la santé humaine.


La vulnérabilité des denrées périssables s’explique par trois types d’altérations : biologiques, chimiques et/ou physiques.
Il y a d’abord la dégradation microbiologique qui correspond à la multiplication des bactéries pathogènes (Salmonella, Listeria monocytogenes, Escherichia coli) ou des microorganismes d’altération (moisissures, levures).
Les aliments peuvent aussi être soumis à des réactions chimiques et enzymatiques, tels que la rancification des lipides (particulièrement marquée dans les viandes et les poissons gras) ou le brunissement des fruits et légumes coupés.
Enfin, il peut y avoir des altérations physiques qui dégradent l’aspect et la texture de l’aliment, comme un flétrissement ou un ramollissement.
Pour neutraliser ces facteurs de dégradation, l’emballage ne peut pas être un simple contenant. Il doit agir comme un bouclier fonctionnel qui va protéger l’aliment de la contamination par des microorganismes extérieurs ainsi que d’une exposition aux conditions extérieures (dessèchement, humidité, oxygène).
Les alternatives aux plastiques
Si l’on souhaite remplacer le plastique pour la conservation de ces aliments, les nouveaux matériaux devront impérativement remplir plusieurs propriétés fondamentales : un contrôle des transferts gazeux et hydriques ainsi que des exigences mécaniques, thermiques et sanitaires, comme le montre le tableau ci-dessous.
Pour répondre à ce cahier des charges exigeant, la recherche s’oriente vers différentes familles de matériaux biosourcés, recyclables ou biodégradables. Cependant, les options sont peu nombreuses et les limites techniques sont trop importantes pour en faire des solutions industrielles viables à l’heure actuelle.
Il y a la possibilité d’utiliser des matériaux inorganiques, tels que le verre, l’acier ou encore l’aluminium. Cette solution existe déjà, avec l’avantage de présenter les propriétés requises pour l’industrie alimentaire et d’être recyclable à l’infini (tout du moins en théorie), mais ces matériaux un poids notable et par conséquent une forte empreinte carbone, notamment liée au transport.
Puis viennent les options biosourcées, telles que la cellulose. Il s’agit du polymère le plus présent dans la nature, il est le composant principal de la paroi des végétaux. La cellulose a déjà été étudiée pour des solutions d’emballage comme des cartons enduits ou du cellophane.
Elle a l’avantage de constituer une matière recyclable, d’origine naturelle et qui montre une bonne rigidité. La cellulose a toutefois des inconvénients : elle ne peut former que des emballages opaques, les solutions proposées sont très sensibles à l’humidité et ce matériau nécessite une fonctionnalisation chimique (utilisation de solvants) pour pouvoir être utilisé.
La nanocellulose, en particulier, composée de nanostructures de cellulose, représente une solution de micro-enrobage fonctionnelle pour enduire le papier ou le carton qui, purs, ne résistent ni à l’eau ni aux graisses. D’autres solutions de revêtements biosourcés sont aussi étudiées, telles que les protéines ou les cires végétales, afin d’améliorer leur étanchéité.
D’autres polymères issus de la production biotechnologique ou de la transformation d’agro-ressources, tels que l’acide polylactique (PLA), issu de la fermentation de l’amidon, ou les polyhydroxyalkanoates (PHA), produit naturellement par certaines bactéries, peuvent aussi présenter une solution intéressante pour les emballages des aliments périssables.
Ils sont considérés comme des alternatives biosourcées, car produites par des microorganismes, bien qu’ils doivent être modifiés chimiquement pour pouvoir être utilisés. Ils forment des alternatives transparentes, thermoformables (on peut en faire des barquettes ou des verres) et présentent une bonne barrière aux gaz. Cependant, ils sont souvent fragiles et nécessitent un traitement industriel pour être dégradés (compostabilité industrielle uniquement).
À lire aussi : Vers des plastiques biodégradables et recyclables ? La piste des « PHA » progresse
Enfin, des biopolymères naturels, tels que l’amidon (issu de la pomme de terre), l’alginate (issu des algues) ou la chitine (issus de la carapace des crustacés), ont été étudiés. Ces biopolymères ont l’avantage d’être très abondants et facilement biodégradables, mais ils présentent une barrière trop faible à l’humidité.

Nous travaillons actuellement, au laboratoire, sur une solution innovante à base de racines d’endive, dont le polymère principal est le fructane. Nous obtenons des résultats prometteurs en ce qui concerne la résistance, mais le matériau n’est pas encore suffisamment inerte pour pouvoir être utilisé dans la conservation des denrées périssables. La migration, c’est-à-dire le transfert de molécules de l’emballage vers l’aliment, est encore trop importante.
Il convient cependant de distinguer deux notions souvent confondues, alors qu’elles ne sont pas équivalentes : le caractère biosourcé du matériau et sa biodégradabilité.
En effet, certains bioplastiques sont des plastiques biosourcés, dont le matériau est issu de la biomasse (maïs, canne à sucre, huiles végétales) et non du pétrole, mais ne sont pas nécessairement biodégradables. À l’inverse, d’autres bioplastiques sont biodégradables, c’est-à-dire que leur matériau peut se décomposer sous l’action de microorganismes. Les matériaux les plus vertueux sont ceux qui sont à la fois biosourcés et biodégradables.
À lire aussi : Les bioplastiques, une solution bio pas si écolo
Et le consommateur dans tout ça ?
L’industriel est prêt à adopter des solutions plus respectueuses de l’environnement, à partir du moment où les options proposées sont viables techniquement et économiquement. Toutefois, l’adoption de ces innovations ne dépend pas seulement de leurs performances scientifiques, mais aussi de leur acceptabilité par le grand public.
Or, les consommateurs expriment aujourd’hui des attentes complexes et parfois paradoxales. En effet, les citoyens sont devenus très méfiants face aux allégations environnementales floues. Ils demandent des garanties sur la fin de vie des emballages : un matériau étiqueté « compostable », mais qui nécessite une usine de compostage industriel à 60 °C provoque la frustration s’il finit dans la poubelle ménagère.
Dans le même temps, une majorité de consommateurs souhaite encore voir l’état de fraîcheur des viandes ou des poissons avant l’achat, ce qui favorise les solutions hybrides ou les bioplastiques transparents, au détriment du papier opaque. Et c’est l’un des plus grands challenges des solutions biosourcées développées à l’heure actuelle.
L’intention d’achat écoresponsable est très présente, mais se heurte à deux réalités économiques et pratiques : la sensibilité au prix et le refus du gaspillage alimentaire.
Ainsi, dans un contexte d’inflation, le surcoût lié aux emballages biosourcés ne doit pas être répercuté brutalement sur le prix final de l’aliment. De plus, le consommateur n’est pas disposé à accepter une réduction de la durée de conservation de ses produits sous prétexte que l’emballage est plus vertueux. En effet, le gaspillage d’une pièce de viande a un impact environnemental bien supérieur à celui de son emballage.
Réussir une transition vers des alternatives sans plastique repose donc sur une adéquation parfaite entre la performance technique du matériau, le respect de la législation et la réponse aux habitudes quotidiennes des consommateurs. C’est dans cet esprit que les recherches prometteuses actuellement en cours doivent se poursuivre.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Élodie Choque a reçu des financements de la Région Hauts-de-France (dynamique Economie Circulaire et Nouveaux Modèles de Développement).
07.10.2026 à 16:52
Le droit, levier de l’Europe face à Pékin
Isabelle Feng, Chercheuse au Centre Perelman de Philosophie du Droit, Université Libre de Bruxelles (ULB)
Texte intégral (1946 mots)
L’ESSENTIEL
Des salariés chinois utilisent le droit européen pour défendre leurs conditions de travail : après leur licenciement par l’équipementier Xingyu, 107 jeunes diplômés ont alerté Mercedes-Benz et Volkswagen, ses clients européens.
L’Union européenne étend son pouvoir juridique au-delà de ses frontières : avec le règlement sur les subventions étrangères (FSR), Bruxelles peut enquêter sur les entreprises chinoises bénéficiant de soutiens publics lorsqu’elles opèrent sur le marché européen.
Pékin et Bruxelles entrent dans un bras de fer juridique : la Chine cherche à empêcher ses entreprises de coopérer aux enquêtes européennes tandis que l’UE utilise l’accès à son vaste marché comme levier réglementaire.
Quand la rivalité sino-européenne se déplace sur le terrain juridique, le droit devient, pour l’Union européenne, une arme de puissance inattendue. Face au géant asiatique, Bruxelles déploie un arsenal réglementaire dont la portée extraterritoriale bouscule les stratégies chinoises.
Deux événements récents illustrent de manière saisissante ce nouveau rapport de force : d’un côté, l’entrée en vigueur, le 1er septembre, de la nouvelle loi chinoise sur les avocats, qui place désormais le travail des avocats sous la direction du Parti communiste chinois (PCC) ; de l’autre, au même moment, les constructeurs allemands Mercedes-Benz et Volkswagen ont été saisis d’une plainte visant leur fournisseur chinois Xingyu, déposée par des salariés de cette entreprise : Mercedes-Benz a enregistré le signalement et annoncé un examen approfondi tandis que Volkswagen a ouvert une enquête.
Quand des salariés chinois utilisent le droit européen comme levier
L’affaire Xingyu, numéro un chinois de la fabrication de phares automobiles, est la démonstration par le bas du poids que peut avoir le droit européen pour les salariés chinois.
Début juillet, l’usine Xingyu, à Changzhou, une ville située à 200 kilomètres de Shanghai, avait embauché 440 nouveaux diplômés ; un mois plus tard, 107 d’entre eux étaient licenciés. Selon la déclaration officielle, cette décision était due au fait que « la conjoncture du secteur est morose ». Peu convaincus, ces jeunes ont décidé d’agir. Au lieu d’engager une procédure classique, ils ont rassemblé des éléments – contrats, enregistrements d’entretiens, annonces de recrutement, documents internes, etc. – qu’ils ont eux-mêmes traduits en anglais, avant de transmettre le dossier… directement aux clients européens de Xingyu, à savoir Mercedes-Benz et Volkswagen, ainsi qu’à l’autorité de la Bourse de Hongkong, auprès de laquelle l’entreprise avait déposé, fin juillet, une demande d’introduction en Bourse.
L’épisode est révélateur d’une mutation profonde. En contournant les mécanismes juridiques nationaux, ces jeunes Chinois ont implicitement reconnu la légitimité des exigences juridiques auxquelles sont soumis les clients européens de leur employeur – en l’occurrence, celles du droit de l’Union des 27.
C’est là toute l’ambivalence de la puissance juridique de l’UE. Bruxelles ne dispose pas d’un pouvoir de contrôle sur les entreprises chinoises, mais peut agir sur leurs activités et partenaires liés au marché européen. En remontant les chaînes de valeur, le droit européen peut ainsi produire des effets au-delà des frontières de l’Union.
Nuctech : quand Bruxelles impose ses règles à Pékin
L’affaire Nuctech en est la démonstration par le haut. Cette entreprise chinoise, leader mondial des scanners de sécurité, fait l’objet d’une enquête menée par Bruxelles au titre du règlement sur les subventions étrangères, le FSR. Adopté en 2022 et applicable depuis 2023, ce règlement permet à la Commission européenne d’examiner les subventions accordées par des États tiers à des entreprises actives sur le marché européen lorsqu’elles sont susceptibles de fausser la concurrence.
En avril 2024, la Commission a engagé une procédure ex officio au titre du FSR à l’encontre de Nuctech et procédé à des inspections « surprise » (dawn raids) dans ses locaux en Pologne et aux Pays-Bas. Au cours de ces opérations, la Commission a notamment demandé l’accès à des courriels d’employés dont les données étaient stockées sur les serveurs en Chine. Nuctech a contesté ces mesures devant le Tribunal de l’Union européenne et demandé leur suspension.
En août 2024, le Tribunal a rejeté cette demande de mesures provisoires. En mars 2025, la Cour de justice, saisie en appel dans cette procédure de référé, a confirmé ce rejet. Autrement dit, les juges européens n’ont pas encore statué sur le fond du litige, mais leurs décisions sur les mesures provisoires montrent déjà la difficulté, pour une entreprise étrangère opérant dans l’Union, de faire obstacle aux enquêteurs de la Commission en invoquant les contraintes de son droit national.
Le véritable bras de fer est intervenu en 2026. Le 7 avril, soit quelques jours avant l’audience consacrée à l’affaire Nuctech devant le Tribunal à Luxembourg, Pékin a adopté des « mesures de lutte contre l’application extraterritoriale inappropriée des lois et mesures étrangères ». Le 15 mai, le ministère chinois de la justice a ordonné à « toute organisation et tout individu » de ne pas coopérer à l’enquête visant Nuctech, dénonçant une action européenne « abusive » et « erronée ».
Le conflit n’oppose donc plus seulement une entreprise à un régulateur. Il met ainsi directement aux prises deux ordres juridiques : Pékin entend empêcher ses entreprises de transmettre des données aux autorités européennes ; Bruxelles considère, de son côté, que son droit peut atteindre les activités d’entreprises chinoises dès lors qu’elles se déploient au sein de l’UE.
Désormais, la question est de savoir quel droit peut s’imposer lorsque deux juridictions revendiquent leur compétence sur une même entité chinoise.
Le marché européen comme instrument de puissance
C’est précisément là que réside la force du FSR. L’Union européenne ne dispose ni de la taille démographique de la Chine ni de ses capacités industrielles. Mais elle possède une autre ressource : un marché de 450 millions de consommateurs, parmi les plus solvables au monde.
Le FSR produit déjà des effets concrets. Des groupes chinois ont ainsi été conduits à renoncer à participer à des marchés publics européens, comme le constructeur ferroviaire chinois CRRC dans le projet de métro de Lisbonne ou Shanghai Electric dans un appel d’offres pour un parc photovoltaïque en Roumanie.
Début février, la Commission européenne a ouvert une enquête approfondie sur Goldwind, le mastodonte éolien basé au Xinjiang ; fin mai, elle en a ouvert une autre contre le géant du commerce en ligne JD.com, candidat au rachat du distributeur allemand Ceconomy. Pékin a riposté en dictant, le 19 août, une deuxième mesure de blocage, interdisant toute collaboration avec l’enquête bruxelloise sur JD.com, là encore, au nom de la « défense de la souveraineté nationale ».
Pékin verrouille la sortie de ses données ; Bruxelles contrôle l’accès à son marché. Le droit devient ainsi un terrain de confrontation géopolitique à part entière où se jaugent les deux puissances.
Se pose alors cette question pour les multinationales chinoises : peut-on se permettre de perdre l’accès à un marché qui importe des centaines de milliards d’euros de marchandises chinoises par an ? À cette question, l’équipementier Xingyu a déjà apporté une réponse négative sans ambiguïté, par une volte-face spectaculaire : l’entreprise a présenté ses excuses et proposé à ses salariés une nouvelle offre de départ, beaucoup plus généreuse.
De la subvention au travail forcé : jusqu’où ira le pouvoir extraterritorial du droit européen ?
Si le FSR devient une véritable épée de Damoclès suspendue au-dessus des sociétés chinoises opérant en Europe, le règlement européen sur le travail forcé (RTF) pourrait, demain, viser les produits fabriqués hors de l’UE, notamment en Chine, dès lors qu’ils sont destinés au marché européen.
Adopté en 2024, le RTF interdira, à partir du 14 décembre 2027, la mise sur le marché européen de produits issus du travail forcé, quelle que soit leur origine. La Commission pourra ainsi examiner les chaînes d’approvisionnement, de l’importateur jusqu’au fournisseur, voire jusqu’aux sous-traitants situés à l’autre bout de la planète. D’où le cauchemar des firmes exportatrices chinoises : l’un des talons d’Achille potentiels du Made in China réside dans les conditions de travail dans lesquelles certains produits sont fabriqués.
La véritable revanche de l’Europe ne serait peut-être pas de « battre » le régime communiste dans la production ou dans les exportations. Elle serait de parvenir à faire de ses propres règles une référence à laquelle les entreprises chinoises – comme les autres entreprises extracommunautaires –– doivent se soumettre.
Dans cette nouvelle bataille, le gagnant n’est pas nécessairement celui qui produit ou exporte le plus. C’est celui dont le droit finit par s’imposer aux autres.

Isabelle Feng ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
07.10.2026 à 16:51
Silver économie : le « bien vieillir », un marché comme les autres ?
Dominique Argoud, Professeur des Universités en sociologie, Université Paris-Est Créteil Val de Marne (UPEC)
Clotilde Kpogba, Enseignante-chercheure contractuelle en sciences de l'éducation et de la formation, Université Paris-Est Créteil Val de Marne (UPEC)
Texte intégral (1613 mots)
L’ESSENTIEL
Le vieillissement de la population crée des besoins en matière de technologies de santé et d’aménagement des espaces.
Initialement focalisée sur la lutte contre la perte d’autonomie, la « silver économie » élargit son champ.
Mais les jeunes retraités se laisseront-ils convaincre par ces offres autour du lien social ou de l’habitat ?
Avec un chiffre d’affaires estimé à 130 milliards d’euros à l’horizon 2030, la silver économie suscite des convoitises. Le vieillissement démographique de la population ouvre en effet d’importantes perspectives pour les acteurs économiques proposant des produits adaptés aux seniors.
La silver économie est aujourd’hui considérée comme un levier de développement pour les territoires et un créneau pour les stratégies marketing. Elle est perçue comme une opportunité économique en matière d’emplois nouveaux. Mais elle donne également à voir une recomposition du jeu des acteurs sur la scène gérontologique.
Une reconnaissance par l’État en 2013
La silver économie s’est constituée sur la base d’un rapprochement entre des ingénieurs et des gériatres autour de ce qui s’appelait les gérontotechnologies. Il s’agissait d’inventer des technologies et des systèmes techniques pour préserver la santé, la sécurité et l’autonomie des personnes âgées.
L’État a très vite encouragé le développement d’une recherche appliquée visant à trouver des solutions pour compenser le handicap et la perte d’autonomie. Ce soutien de l’État a abouti, en 2013, à la signature d’un « contrat de filière pour la silver économie » associant Michèle Delaunay, ministre déléguée aux personnes âgées et à l’autonomie, et Arnaud Montebourg, ministre du redressement productif.
Les gérontotechnologies ont ainsi servi de tremplin à une alliance plus large entre le secteur économique et le secteur du vieillissement, compte tenu des perspectives attendues avec l’arrivée des baby-boomers dans la catégorie des seniors.
Ce faisant, tout semble se passer comme si les gérontotechnologies, nées dans le champ médico-social, se diluaient progressivement dans le giron de la silver économie. Désormais, la sémantique évolue au profit des « technologies de la santé et de l’autonomie » et du design for all. L’objectif est de prendre le contrepied de l’image peu vendeuse du médico-social et des personnes âgées.
Le Festival SilverEco, qui se déroule chaque année en septembre au Palais des festivals de Cannes (Alpes-Maritimes), en est une illustration. Loin des congrès gérontologiques traditionnels, il adopte tous les codes de l’événementiel pour promouvoir une image qui se veut positive et innovante.
Le secteur de la vieillesse lui-même devient celui du « bien-vieillir ». Les marchands et les communicants se substituent désormais aux gériatres.
Des innovations conçues par des ingénieurs et des experts
Mais la silver économie rencontre un problème de taille. Elle ne peut se développer que si le marché potentiel (lié au vieillissement de la population) se transforme en une demande effective. Or les seniors et leurs aidants résistent : ils ne voient pas forcément l’utilité de ce qu’on cherche à leur vendre. L’accompagnement humain reste fortement plébiscité pour faire face à l’avancée en âge, car il est une composante importante de l’identité professionnelle au sein du secteur médico-social.
Et si la silver économie surfe sur le caractère nouveau des produits et des services proposés, elle n’en reste pas moins une innovation pensée par le haut. Les besoins des personnes âgées et des aidants sont en grande partie définis à partir de la solution envisagée.
Contrairement aux processus d’innovation dans l’action sociale, ils ne sont pas le résultat d’un mouvement de revendications émanant d’associations visant à combler des besoins non ou mal satisfaits. C’est d’ailleurs ce qui a conduit ces dernières années au développement des living labs et des hackathons pour tenter d’impliquer les usagers dans la conception des produits.
La silver économie à la recherche d’un second souffle
Un second problème réside dans le coût des innovations. Si l’État et les collectivités territoriales se sont plutôt montrés favorables à la silver économie, ils se sont relativement peu engagés dans sa solvabilisation. À défaut, ses promoteurs sont contraints de développer des stratégies alternatives de « changement d’échelle » et de « massification » pour que leurs produits et services deviennent incontournables.
Dans cette perspective, et sous l’égide de Luc Broussy, homme politique et lobbyiste, une filière nationale s’est structurée sous le nom de France Silver Éco. Plus récemment, un contrat de filière (2024-2027) a été signé pour fédérer l’ensemble des acteurs souhaitant contribuer à la structuration de ce secteur économique.
Un déplacement du centre de gravité est ainsi perceptible. Les nouvelles technologies de sécurisation et la perte d’autonomie ne sont plus au cœur de la silver économie, qui cherche désormais à capter les jeunes retraités inquiets pour leur vieillissement ainsi que leurs aidants. En cela, elle ne fait que suivre l’évolution de la politique publique en faveur de l’adaptation de la société au vieillissement.
Un élargissement du périmètre vers le « bien vieillir »
Il en résulte une approche très œcuménique de la silver économie. Cet œcuménisme se vérifie au niveau des acteurs se réclamant de cette filière ou la soutenant. Ils vont des grandes entreprises privées (Orange, Legrand-Care…) et start-up (Merci Prosper, La maison de Blandine…), jusqu’aux groupes publics ou parapublics (Caisse des dépôts et consignations, Caisse nationale d’assurance vieillesse, La Poste…), en passant par le secteur associatif (Gérontopôle, Association française des aidants, Groupe SOS seniors…).
C’est le résultat d’un élargissement considérable des frontières de la silver économie. Aujourd’hui, les innovations technologiques ont plutôt tendance à s’inscrire dans le champ de la santé où l’acceptabilité sociale et financière est plus forte. La silver économie s’est surtout emparée du champ de la prévention, de l’habitat et du lien social. En s’inscrivant délibérément dans la politique du « bien vieillir » voulue par l’État et les collectivités territoriales, elle cherche à se départir de l’image dépréciée de la perte d’autonomie.
Dans cette zone moins normée que ne l’est le secteur médico-social, il en résulte une plus grande porosité public-privé faisant se côtoyer entreprises, collectivités publiques et associations. Le secteur commercial voit là un nouveau créneau pour s’implanter et se développer, parfois avec l’aide de financements publics. Les groupes de protection sociale, en particulier, se montrent friands d’investir dans le « bien vieillir ».
Mais si la marchandisation du grand âge est d’ores et déjà une réalité avec les multiples groupes privés gestionnaires d’Ehpad, toute la question pour l’avenir est de savoir si les seniors seront prêts à s’inscrire dans ce vaste marché.

Dominique Argoud a reçu des financements du Programme Prioritaire de Recherche autonomie dans le cadre du projet INNOVCARE.
Clotilde Kpogba ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
07.10.2026 à 16:51
Quand la nicotine est promue comme produit bien-être sur les réseaux, alors qu’elle reste une substance addictive
Hasmeena Kathuria, Professor of Medicine, University of Wisconsin-Madison
Texte intégral (2224 mots)
L’ESSENTIEL
La nicotine est parfois présentée comme un moyen d’améliorer la concentration et de réduire le stress, mais les preuves manquent.
Les études chez l’être humain ne montrent pas qu’elle prévient le déclin cognitif ou favorise la longévité.
Les substituts nicotiniques aident à arrêter de fumer ; consommer de la nicotine hors de ce cadre expose à la dépendance.
Aux États-Unis, une évolution paradoxale accompagne l’essor du mouvement Make America Healthy Again (mouvement politique porté par Robert F. Kennedy Jr, ministre de la santé de Donald Trump qui promet de lutter contre les maladies chroniques, notamment en s’attaquant à l’alimentation ultratransformée et aux substances chimiques présentes dans l’environnement, NdT) : la nicotine est présentée comme un produit bénéfique pour la santé et pour les performances. Sur les réseaux sociaux, dans les podcasts, les communautés consacrées au bien-être et le discours de certaines start-up, des personnalités influentes dépeignent la nicotine comme une substance mal comprise, dont les bienfaits potentiels auraient été occultés par son association au tabagisme et à ses effets nocifs.
La nicotine n’est ainsi plus présentée comme une substance addictive liée au tabac, mais comme un produit naturel qui pourrait servir à tout, de l’amélioration de la concentration à la prévention du déclin cognitif. Cette tendance concerne la nicotine consommée seule, sous des formes sans combustion, comme les sachets de nicotine, ou associée à la caféine et à des substances commercialisées pour leurs effets supposés sur les capacités cognitives, appelées « nootropiques ».
En tant que médecin pneumologue et chercheuse, j’étudie la dépendance à la nicotine et les effets du tabac et des produits contenant de la nicotine sur la santé. Les affirmations selon lesquelles la nicotine améliorerait le bien-être, la productivité et les capacités cognitives m’inquiètent.
Distinguer la nicotine du tabac
Certains de ces arguments s’appuient sur le fait que la nicotine est une substance naturellement présente dans les plantes : principalement dans le tabac, mais aussi, à l’état de traces, dans des légumes de la même famille, comme la tomate, la pomme de terre et l’aubergine. Les défenseurs de la consommation de nicotine citent également des études suggérant qu’elle peut agir sur certains aspects des capacités cognitives et du fonctionnement du cerveau.
Mais en déduire que la nicotine améliore la productivité, la santé cérébrale, la longévité ou le bien-être va bien au-delà de ce que les études menées chez l’être humain ont démontré.
La nicotine est le principal moteur de la dépendance aux cigarettes, aux cigarettes électroniques et à la plupart des autres produits du tabac commercialisés.
Les risques les plus graves pour la santé surviennent lorsque le tabac brûle : sa combustion produit des milliers de substances toxiques, dont des substances cancérogènes, du monoxyde de carbone et des particules fines. Une exposition répétée à ces produits de combustion peut provoquer des cancers, une bronchopneumopathie chronique obstructive (BPCO), des maladies cardiovasculaires et de nombreuses autres maladies liées au tabagisme.
Si de nombreuses maladies liées au tabagisme résultent de l’exposition aux produits de combustion, la nicotine elle-même a des effets néfastes bien connus sur le cerveau et l’organisme. Elle active le système nerveux sympathique, responsable de la réaction de « lutte ou de fuite » face au danger. Cela accélère le rythme cardiaque, augmente la pression artérielle et perturbe le sommeil. La stimulation répétée de ce système peut accroître la charge de travail du cœur.
L’exposition à la nicotine est particulièrement préoccupante pendant les périodes clés du développement. Avant la naissance, elle est associée à des effets néfastes sur la croissance et le développement du fœtus. À l’adolescence, elle peut modifier les circuits cérébraux qui interviennent dans l’attention, l’apprentissage et la perception de la récompense, ce qui accroît le risque de dépendance.
Comment la nicotine modifie le cerveau
La nicotine entraîne également une dépendance en activant les circuits cérébraux de la récompense.
L’acétylcholine est un neurotransmetteur, c’est-à-dire un messager chimique du cerveau, qui intervient notamment dans l’attention, l’apprentissage, la mémoire et le traitement de l’information. La nicotine agit sur les mêmes récepteurs, dits « nicotiniques », que l’acétylcholine. Elle augmente temporairement la vigilance et l’attention. L’activation de ces récepteurs influe aussi sur la libération d’autres neurotransmetteurs, dont la dopamine, qui joue un rôle important dans la sensation de récompense et le renforcement des comportements.
Cependant, la nicotine n’agit pas comme l’acétylcholine. Ses effets durent beaucoup plus longtemps et modifient l’activité de nombreuses régions du cerveau. Lorsque l’exposition se répète, le cerveau s’adapte à sa présence : les récepteurs deviennent moins sensibles et, en compensation, leur nombre augmente. Ce mécanisme contribue à la dépendance.
Concentration et productivité
Certains influenceurs spécialisés dans le bien-être du bien-être affirment que la nicotine améliorerait les capacités cognitives, notamment la concentration et la productivité. Plusieurs études suggèrent qu’elle pourrait améliorer temporairement l’attention, la vigilance, le temps de réaction et certains aspects de la mémoire de travail, mais les résultats sont contrastés. Selon les recherches, la nicotine pourrait avoir un effet bénéfique chez les personnes présentant un léger déclin cognitif. En revanche, elle ne semble pas améliorer les capacités cognitives des personnes en bonne santé et pourrait même réduire les performances de celles qui obtiennent habituellement les meilleurs résultats aux tests cognitifs.
En outre, nombre de ces études portent sur des consommateurs réguliers devenus dépendants à la nicotine. Lorsqu’ils cessent d’en consommer, ils éprouvent souvent des difficultés à se concentrer, de l’irritabilité, de l’anxiété, de l’agitation et une baisse de l’attention. La reprise de la nicotine atténue généralement ces symptômes. Il est donc difficile de savoir si les améliorations observées correspondent à un véritable gain de capacités cognitives ou simplement à la disparition des symptômes de manque.
Autrement dit, la nicotine peut améliorer brièvement l’attention et la vigilance chez certaines personnes, mais peu d’éléments montrent qu’elle favorise réellement la réussite scolaire, l’intelligence, la créativité, les capacités de planification et de prise de décision ou la productivité au travail.
Sur le stress et l’humeur
Certains influenceurs spécialisés dans le bien-être présentent aussi la nicotine comme un moyen de réduire le stress et d’améliorer l’humeur.
La nicotine active les circuits de la récompense dans le cerveau, ce qui peut procurer une sensation passagère de plaisir et de bien-être. Mais, à long terme, sa consommation peut perturber la façon dont l’organisme réagit au stress et rendre l’anxiété plus difficile à maîtriser.
Les études montrent de manière concordante que les personnes qui arrêtent de fumer voient leur anxiété, leurs symptômes dépressifs et leur stress diminuer. Avec le temps, leur humeur et leur qualité de vie s’améliorent également. L’arrêt durable de la nicotine est ainsi associé à une meilleure santé mentale et à un plus grand bien-être.
Si la nicotine peut donner momentanément l’impression de soulager le stress, les données actuelles ne justifient pas son utilisation pour réduire le stress, améliorer l’humeur ou traiter l’anxiété et la dépression.
Vieillir en bonne santé et vivre plus longtemps
Certains des arguments les plus ambitieux avancés par les défenseurs de la nicotine affirment qu’elle protégerait contre la démence, la maladie d’Alzheimer, la maladie de Parkinson et le déclin des capacités cognitives lié à l’âge.
Ces affirmations reposent sur des travaux suggérant que la nicotine peut agir sur les circuits cérébraux impliqués dans la mémoire et l’attention, ainsi que sur des études menées sur des animaux ou en laboratoire qui examinent si elle pourrait modifier les mécanismes associés au déclin cognitif.
Cependant, les études menées chez l’être humain n’ont pas démontré que la nicotine pouvait prévenir la démence, ralentir la progression de la maladie d’Alzheimer, préserver durablement les capacités cognitives ou améliorer l’évolution de la maladie de Parkinson.
Certains influenceurs affirment pourtant que la nicotine préserverait les capacités cognitives, ralentirait le vieillissement biologique ou prolongerait la vie. Ces affirmations reposent surtout sur des études en laboratoire montrant que la nicotine peut agir sur des mécanismes cellulaires liés au stress oxydatif, ainsi que sur des études animales suggérant des effets sur l’inflammation et d’autres mécanismes associés au vieillissement et aux maladies. Mais ces résultats n’ont pas permis de démontrer que, chez l’être humain, la nicotine favorise un vieillissement en bonne santé, prolonge la vie ou prévient les maladies liées à l’âge.
Traiter la dépendance à la nicotine
Les substituts nicotiniques autorisés par l’Agence états-unienne des produits alimentaires et médicamenteux (FDA), notamment les patchs, les gommes à mâcher et les pastilles, aident les personnes dépendantes à atténuer les symptômes de manque et les envies de fumer. Utilisés conformément aux recommandations, ils peuvent ainsi faciliter l’arrêt du tabac.
Il ne faut toutefois pas confondre cet usage thérapeutique avec les affirmations selon lesquelles la nicotine améliorerait les capacités cognitives, favoriserait le bien-être ou aiderait à bien vieillir. En dehors d’un traitement de l’addiction au tabac fondé sur des données scientifiques, l’usage de produits contenant de la nicotine comporte un risque de dépendance.

Hasmeena Kathuria reçoit des financements d’UpToDate (une ressource d’aide à la décision clinique fondée sur les données scientifiques), des Instituts nationaux de la santé américains (NIH) et du Patient-Centered Outcomes Research Institute (PCORI).
07.10.2026 à 16:50
Sur les friches industrielles, des bactéries ont appris à se nourrir de la pollution
Catherine Armbruster, Assistant Professor of Biological Sciences, Carnegie Mellon University
Texte intégral (2885 mots)
L’ESSENTIEL
Les sols sous nos pieds sont vivants : un seul gramme de sol peut contenir des milliards de bactéries.
Dans les friches industrielles dont les sols sont pollués, certaines bactéries sont capables de se nourrir des polluants et prolifèrent.
L’analyse de leur ADN et des tests en laboratoire permettent de comprendre comment elles dégradent ces substances, ce qui pourrait nous aider à améliorer la dépollution des sols.
Dans les Appalaches et la Rust Belt, cette région des États-Unis marquée par le déclin industriel, notamment à Pittsburgh, d’anciens sites industriels sont reconvertis en nouveaux quartiers, en centres de recherche et en pôles technologiques. Mais, sous ces sites, une autre transformation est à l’œuvre depuis des décennies.
Ces friches sont d’anciens sites industriels ou commerciaux. Les projets de reconversion peuvent être rendus compliqués par la pollution, et sont souvent définis autour des vestiges de leur activité passée — des usines abandonnées, des terrains vacants et des sols contaminés par des substances cancérogènes. Mais, sous la surface, ces friches sont des écosystèmes vivants : des milliards de microbes peuplent leurs sols. À Pittsburgh, certains réagissent et s’adaptent depuis des décennies à la pollution héritée du passé industriel de la ville.
Microbiologiste, je me suis intéressé à ce sujet à cause d’une friche toute proche de moi. Mon laboratoire, à l’université Carnegie Mellon, se trouve à seulement trois kilomètres de Hazelwood Green, un ancien site industriel de 72 hectares qui borde la rivière Monongahela, à Pittsburgh.
Pendant plus d’un siècle, ce site a accueilli des activités sidérurgiques, notamment celles de la Jones & Laughlin Steel Co. À son apogée, cette entreprise industrielle employait des milliers d’ouvriers. Elle a contribué à faire de Pittsburgh la « ville de l’acier ».
L’histoire de Pittsburgh a aussi laissé un héritage chimique. Comme sur beaucoup d’anciens sites industriels, les sols de Hazelwood Green étaient contaminés par des hydrocarbures pétroliers, des métaux lourds et d’autres polluants, ce qui lui a valu d’être classée comme friche industrielle polluée. Parmi ces contaminants figurent le benzène, le toluène, l’éthylbenzène et les xylènes, un ensemble de composés dérivés du pétrole regroupés sous l’acronyme BTEX. Ces substances peuvent être toxiques pour les humains et d’autres organismes, et certaines sont reconnues comme cancérogènes.
Au cours des dernières décennies, la reconversion de Hazelwood Green a demandé de dépolluer les sols. Le site est devenu un nouveau pôle de recherche, de technologie et d’initiatives locales. Ces travaux soulèvent une question biologique intéressante : que sont devenus les micro-organismes qui vivaient dans ces sols lorsqu’ils étaient contaminés ? Et leur manière de faire face à cette pollution peut-elle nous aider à mieux dépolluer d’autres friches à l’avenir ?
La pollution comme expérience évolutive
Les sols abritent une extraordinaire diversité de microorganismes. Un seul gramme peut contenir des milliards de bactéries appartenant à des milliers d’espèces différentes.
Lorsque des polluants comme les BTEX pénètrent dans cet environnement, les microbes font face à un nouveau défi écologique. Pour de nombreux organismes, ces substances peuvent être toxiques. Mais certains microbes possèdent déjà des mécanismes métaboliques qui leur permettent de les tolérer, voire de s’en nourrir. Ils disposent ainsi d’un avantage sur les autres bactéries présentes sur le site.
Au fil du temps, la pollution exerce une pression de sélection sur ces microbes. Les bactéries capables d’y survivre, voire de dégrader les polluants, deviennent plus nombreuses. Et elles peuvent transmettre cette capacité à d’autres bactéries, au-delà de leur propre descendance, en échangeant directement des gènes.
À Hazelwood Green, des décennies de pollution industrielle ont ainsi constitué, sans que personne l’ait voulu, une gigantesque expérience sur l’évolution. Mon laboratoire, au sein du département de biologie de l’université Carnegie Mellon, cherche à en comprendre les résultats. Nous prélevons des échantillons de sol dans différentes zones de Hazelwood Green, dont les niveaux de contamination passés varient.
Les carottes de sol – des échantillons cylindriques prélevés verticalement depuis la surface, qui préservent les différentes couches du sol – nous permettent d’examiner les communautés microbiennes en profondeur. Nous en extrayons l’ADN, puis procédons à un séquençage métagénomique. Cette technique permet d’identifier tous les micro-organismes présents dans un échantillon environnemental directement à partir de leur ADN, plutôt que de les cultiver et de les étudier un par un.

Au-delà de l’identification des microbes présents, nous cherchons à comprendre ce dont ils sont capables. L’un de nos objectifs est de repérer les gènes bactériens associés à la dégradation des BTEX et d’autres hydrocarbures.
Nous avons reporté sur une carte du site actuel des données de contamination couvrant plusieurs décennies, puis comparé l’abondance des microbes selon les lieux et les profondeurs. Nous cherchons ainsi à savoir si la pollution passée a laissé une empreinte durable sur les communautés microbiennes de Hazelwood Green.
À la recherche de microbes qui se nourrissent de polluants
Le séquençage de l’ADN nous aide à comprendre ce dont les microbes pourraient être capables. Mais nous vérifions aussi directement ces prédictions. Nous isolons des bactéries provenant de Hazelwood Green et d’autres sites de Pittsburgh, puis nous testons leur capacité à se nourrir de différents polluants, pris un à un.
Le principe de l’expérience, qui vise à repérer les bactéries capables de dégrader les BTEX, est simple. Habituellement, les bactéries sont cultivées en laboratoire dans des milieux riches en nutriments, contenant des sucres, des acides aminés et d’autres composés qu’elles peuvent facilement consommer. Nous les cultivons, au contraire, dans un milieu minimal dépourvu de toute source de carbone. Or, pour se développer, la plupart des bactéries ont besoin d’une source de carbone organique, qui constitue en quelque sorte leur « nourriture ».
Nous ajoutons alors un polluant — benzène, toluène, éthylbenzène ou xylène — comme unique source de carbone dans le milieu de culture. Si les bactéries se développent, cela suggère qu’elles peuvent s’en nourrir. Ce faisant, elles éliminent le polluant de leur environnement et contribuent à dépolluer le sol.

Identifier ces organismes un par un prend du temps. Nous avons donc noué un partenariat avec l’AI Science Foundry de l’université Carnegie Mellon, un laboratoire robotisé et automatisé installé à Bakery Square, une autre friche de Pittsburgh désormais dépolluée.
Ses systèmes robotisés nous permettent de tester simultanément des milliers d’espèces de bactéries et de mesurer la capacité de chacune à dégrader des polluants comme les BTEX. En parallèle, les outils en accès libre que nous développons, comme BTEXgenie, recherchent dans les génomes bactériens les gènes susceptibles de contribuer à la dégradation des polluants.
Cette approche inverse l’ordre habituel des recherches. Plutôt que d’étudier un organisme à la fois en espérant qu’il soit utile, nous pouvons d’abord analyser des milliers de génomes pour repérer les candidats prometteurs, puis vérifier en laboratoire lesquels sont effectivement capables de dégrader les polluants. Chaque série de tests améliore aussi notre capacité à prédire les fonctions d’un microbe à partir de son seul ADN. Plus nous apprenons, plus le processus s’accélère.
Les microbes peuvent-ils dépolluer nos sols ?
Dépolluer les sols est difficile et coûteux. Les méthodes courantes – excaver les terres contaminées ou les recouvrir de matériaux propres – peuvent rendre un terrain suffisamment sûr pour permettre sa reconversion, sans pour autant éliminer les polluants. Une surveillance à long terme peut donc rester nécessaire.
L’utilisation de microorganismes pour éliminer les polluants de l’environnement n’est pas une idée nouvelle. La bioremédiation est déjà employée pour traiter les marées noires et les eaux usées. Dans de nombreux cas, les microbes dégradent naturellement ces contaminants au cours de leur croissance, les transformant en composés moins nocifs.
Toutefois, l’efficacité de la bioremédiation varie selon les polluants et les sites contaminés. L’une des principales difficultés consiste à identifier des microbes capables de dégrader un contaminant donné tout en se développant dans les conditions du milieu où il se trouve. C’est là que l’étude des microbes vivant déjà dans des environnements pollués nous donne un avantage.

En identifiant ces microbes naturellement adaptés à la pollution et en comprenant comment ils métabolisent les polluants, nous pourrions améliorer les méthodes actuelles de bioremédiation.
Alors que les anciens sites industriels de Pittsburgh et de la Rust Belt se transforment en pôles scientifiques et technologiques, certaines des innovations biologiques dont nous avons besoin se développent peut-être depuis longtemps sous nos pieds. Nous commençons tout juste à découvrir ce que ces microbes ont appris.

Catherine Armbruster bénéficie d’un financement de la Richard King Mellon Foundation pour étudier la dépollution des friches industrielles par les micro-organismes.
07.10.2026 à 14:53
Manifestations lycéennes, réponse du gouvernement : pourquoi la situation est inédite – et imprévisible
Robi Morder, Chercheur Associé au Laboratoire Printemps, UVSQ/Paris-Saclay, co-président du Groupe d'études et de recherches sur les mouvements étudiants (Germe), Université de Versailles Saint-Quentin-en-Yvelines (UVSQ) – Université Paris-Saclay
Texte intégral (1628 mots)
L’ESSENTIEL
Le mouvement lycéen, rejoint par des parents, des enseignants et des syndicats, a réuni 450 000 manifestants, le 6 octobre dans toute la France (250 000 manifestants, selon le gouvernement).
Si les revendications sur les moyens sont récurrentes, le contexte global et la forme du mouvement – né dans les banlieues populaires – sont nouveaux.
La réponse du gouvernement, qui a choisi la « fermeté » policière face à des adolescents avant d’ouvrir les négociations, est également inédite.
La mobilisation lycéenne qui a débuté dans la banlieue parisienne en ce mois de septembre 2026 s’inscrit dans une continuité de mobilisations de rentrée que l’enseignement secondaire a connu en réponse à des situations jugées dégradées (manque de professeurs, classes surchargées, locaux vétustes, etc.), de manière cyclique depuis la fin des années 1970, tranchant avec le type de mobilisations « printanières » qui avaient caractérisé les « années 68 ».
Déjà, en 1978, on a pu noter que ce qui jusque-là avait caractérisé les lycées techniques et les collèges d’enseignement technique (LT et CET) était devenu le problème général des lycées.
« La rentrée scolaire 1978 s’avère calamiteuse, classes surchargées, manque de professeurs, de personnel. En Seine-Saint-Denis, on peut même douter que la rentrée a eu lieu. Dès le 15 septembre, les professeurs du lycée de Saint-Denis et celui de Noisy-le-Sec ont entamé une grève, avec le soutien actif des associations de parents d’élèves et de nombre d’élus locaux pour réclamer des créations de postes et des ouvertures de classes. (…) Pour la première fois depuis mai-juin 1968 des établissements sont occupés de jour et de nuit, c’est notamment le cas dans le 93 à Saint-Denis, à Aubervilliers, à Montreuil. »
in Didier Leschi et Robi Morder, Quand les lycéens prenaient la parole. Les années 68, Syllepse, 2018.
Ces questions récurrentes ont également donné lieu à de fortes mobilisations lycéennes en 1990 et en 1998, débouchant alors sur des mesures significatives considérées comme des victoires. Des mouvements d’automne ont également touché les lycéens, mais sur d’autres sujets, par exemple celui contre la réforme des retraites en 2010.
Ce qui est inédit en cette mobilisation de l’automne 2026 est d’abord le contexte global du mouvement, avec une guerre à l’est de l’Europe accompagnée d’une hausse des budgets militaires qui contraste avec une insuffisance chronique des crédits pour l’éducation, une crise climatique qui impacte des établissements mal isolés où les lycéens souffrent de la chaleur et un risque d’accès de l’extrême droite à la présidence de la République en 2027. Ce dernier enjeu a pu être ressenti par nombre de lycéens des banlieues populaires – où le mouvement a démarré – comme une menace existentielle.
Comment se faire entendre ?
Pour faire valoir leurs revendications, les actions possibles sont limitées. La représentation lycéenne existe en droit (des élèves siègent dans les conseils d’administration et dans des institutions nationales auprès du ministère), mais avec peu de portée.
Outre qu’elle n’est pas un droit pour les lycéens, la grève, en tant que simple arrêt de travail, n’est aucunement un moyen de pression (une grève lycéenne ne gêne personne, elle n’arrête aucune production). En conséquence, pour qu’un mouvement lycéen soit efficace, il ne suffit pas de déserter les cours, encore faut-il être visibles, audibles, médiatiques.
Il convient de noter le changement de vocabulaire intervenu au cours des dernières décennies. « Piquet de grève » a été remplacé par « blocage », ou « blocus », notamment depuis le mouvement lycéen contre la loi Fillon en 2005. Les assemblées générales qui se tenaient dans les lycées, décidant de piquets de grève (piquets « filtrants » ou piquets « bloquants ») sont devenues plus difficiles à organiser, surtout quand les administrations ne les autorisent pas, parfois en raison simplement du manque de salles. Désormais, les organisations lycéennes comme les administrations ne parlent plus de lycées en grève, mais comptabilisent des lycées bloqués.
Pour être visibles, il leur faut donc avoir des actions spectaculaires. Comme chaque groupe social, les lycéens utilisent ce qu’ils ont sous la main : poubelles pour bloquer, ou ralentir, l’entrée du lycée, manifestation dans le quartier ou la ville – avec les mesures d’interdiction, cela est plus difficile – appel à des personnalités (des élus, par exemple) susceptibles d’attirer la curiosité des médias, pancartes, etc.
C’est dans ce contexte qu’intervient la question de la violence. Il faut attendre les éléments plus précis sur les profils des jeunes arrêtés. On sait que, pour la grande majorité, il s’agit de mineurs. Mais s’agit-il de lycéens ou de jeunes sortis, ou exclus, du système scolaire ? Les circonstances, les faits reprochés peuvent différer d’un individu à l’autre.
En attendant, rappelons que, dans les premiers jours de Mai-68 au Quartier latin, on trouvait un nombre important de jeunes travailleurs qui se joignaient aux étudiants pour, en quelque sorte, se venger des humiliations subies dans leurs cités et leurs quartiers par la police, comme l’a rappelé le sociologue Gérard Mauger.
La crise actuelle mêle les caractéristiques des mobilisations lycéennes avec celles des « émeutes protopolitiques » survenues dans les banlieues – notamment en 2005. Notons que les « jeunes de banlieue » ne sont pas uniquement des jeunes de banlieue, ils sont aussi lycéens, étudiants, parfois chômeurs ou précaires. Ils agissent et réagissent autant sur leurs lieux d’études, de travail, d’habitation. Les manifestations lycéennes sont également des lieux de convergence à l’échelle locale.
Une réponse policière inédite face à des adolescents
Ce qui est également singulier, c’est la façon dont les pouvoirs publics ont ignoré la situation alors que les manques de moyens, de personnels sont signalés régulièrement et, encore en cette rentrée, par les syndicats enseignants.
Si les gouvernements depuis 2017 ont connu des conflits inédits, tels les gilets jaunes, Sainte-Soline, des émeutes urbaines, les mouvements lycéens ou étudiants sont récurrents, et sont susceptibles d’être résolus par la négociation. Or, depuis 2016 (loi Travail), la réaction de « fermeté » semble être devenue une norme, au risque d’affrontements violents, rendant la présence aux manifestations, pourtant légales, périlleuse. Appliquée à des adolescents, elle apparaît manifestement disproportionnée et dangereuse.
Il semble qu’après avoir ignoré l’ampleur des problèmes le choix de la répression ait prévalu. C’est le ministère de l’intérieur qui a été mis en avant, privilégiant les fermetures en masse des établissements. On avait connu dans les mouvements passés quelques fermetures exceptionnelles, mais jamais à une telle échelle.
Après avoir communiqué sur une « instrumentalisation » du mouvement par La France insoumise (LFI) du fait du soutien affirmé de cette dernière et de la présence de ses élus devant les établissements (alors que d’autres partis ont fait de même), le discours gouvernemental a finalement admis que les revendications étaient légitimes. Sans doute, l’opinion des Français, qui approuvent la légitimité des revendications des lycéens, aura renforcé le mouvement, mais aussi l’ampleur, comme la bonne tenue, des manifestations du 6 octobre. Les syndicats annoncent 450 000 manifestants, quand le ministère en dénombre 250 000, dans toute la France.
Or, qui dit négociation, dit rapport de force. Ce qui était possible avant le mouvement pour tenter de « calmer le jeu », s’avère insuffisant aujourd’hui alors que la mobilisation s’est maintenue et que la menace d’une extension aux étudiants et d’une jonction avec d’autres mécontentements pèse sur le gouvernement. Sur les réseaux sociaux utilisés par les jeunes, beaucoup font référence non seulement aux manifestations avec d’autres syndicats, mais aussi à l’appel à la mobilisation contre la vie chère, le 17 octobre prochain, comme un retour des « gilets jaunes. En quelque sorte les enchères montent.

Robi Morder est membre de: SNESup, Association autogestion, RESU.
07.10.2026 à 12:19
Des scientifiques avaient prédit la fin du monde pour le vendredi 13 novembre 2026. Faut-il s’inquiéter ?
Alan MacEachern, Professor, History, Western University
Texte intégral (2069 mots)
L’ESSENTIEL
En 1960, des chercheurs prédisaient une croissance démographique infinie et la fin du monde pour le 13 novembre 2026.
Leurs projections sont restées étonnamment précises jusqu’aux années 1990, avant que la baisse de la natalité ne les démente.
Derrière cette prédiction spectaculaire, une démarche scientifique solide illustre comment l’absurde peut attirer l’attention sur un sujet sérieux.
En 1960, Science, l’une des plus prestigieuses revues scientifiques au monde, publiait un article au titre sans équivoque : « La fin du monde : vendredi 13 novembre 2026 ». Il prédisait qu’à cette date – dans un peu plus d’un mois – la population humaine tendrait vers l’infini, entraînant de fait sa propre annihilation.
Cette prédiction extravagante a valu à l’article un large écho auprès du public. Plus surprenant encore, les recherches et les calculs sur lesquels elle reposait paraissant solides, elle a aussi fait l’objet d’un examen scientifique attentif et prolongé.
Les auteurs – Heinz von Foerster, professeur et spécialiste de la cybernétique austro-américain, et deux de ses étudiants, Patricia M. Mora et Lawrence W. Amiot – soutenaient que les populations humaines constituent un cas à part : leur croissance pourrait dépasser le rythme exponentiel et accélérer sans cesse.
« Nos arrière-arrière-petits-enfants ne mourront pas de faim, affirmaient-ils. Ils mourront écrasés par la foule. » L’article était régulièrement cité et ses prédictions semblaient remarquablement exactes – jusqu’aux alentours de 1993, à mi-chemin de la « fin du monde » annoncée, lorsque la population mondiale a commencé à croître moins vite que prévu.
Aujourd’hui, le taux de natalité mondial est un peu inférieur à la moitié de ce qu’il était en 1960. Espérons que le 13 novembre sera pour nous tous une journée ordinaire. Cet article reste néanmoins un exemple magistral de l’alliance entre rigueur scientifique et art de la mise en scène.
Des capacités propres à l’humanité
Au milieu du XXe siècle, la croissance de la population mondiale suscitait des inquiétudes grandissantes : elle risquait d’entraîner une pénurie de ressources et des conflits géopolitiques. Ces craintes reposaient en grande partie sur une adhésion, implicite ou explicite, à l’idée malthusienne selon laquelle la population peut croître de façon exponentielle, mais reste constamment limitée par sa capacité à se nourrir.

Dans leur article, von Foerster et ses coauteurs soutenaient toutefois que la population humaine pourrait constituer un cas à part. Grâce à notre capacité à communiquer et à former des « coalitions » pour résoudre les problèmes, une densité de population accrue pourrait simplement multiplier les possibilités de collaboration. Notre population pourrait ainsi croître plus vite que selon un rythme exponentiel, avec une accélération constante.
Ils s’appuyaient ensuite sur 24 estimations de la population mondiale couvrant les 2 000 dernières années pour montrer que celle-ci avait, de fait, continuellement dépassé les prévisions. Le tout était exposé dans une prose scientifique sobre, étayée par des équations mathématiques complexes.
« Écrasés par la foule »
Von Foerster et ses coauteurs ont ensuite extrapolé ces données historiques, calculant qu’avec une croissance toujours plus rapide, notre population tendrait vers l’infini en 2026.
Heureusement, cette même capacité à collaborer, qui avait contribué au développement de notre espèce tout au long de l’histoire, pouvait désormais éviter la catastrophe. Puisque nous ne souhaiterions probablement pas raccourcir notre espérance de vie, concluaient-ils, nous devrions unir nos efforts pour réduire de moitié le taux de natalité mondial.
La publication a immédiatement fait sensation. Time et le New York Times lui ont consacré des articles. Elle a inspiré la série de bandes dessinées Pogo, et de nombreux commentateurs n’y ont vu qu’une manière ironique de tourner en dérision les craintes liées à la croissance démographique.
Une explosion démographique
Mais l’affaire, loin de retomber, a pris une tournure inattendue. Lorsque Science a publié des lettres de mathématiciens et de démographes critiquant les travaux de von Foerster et de ses collègues – les qualifiant de « ridicules » et de « manifestement absurdes » –, les auteurs ont riposté avec vigueur, réaffirmant la validité de leurs calculs et des conclusions qu’ils en tiraient.
Des années 1960 aux années 1980, l’équation de la « fin du monde » a été régulièrement citée – généralement prise au pied de la lettre – dans des manuels de génétique, d’écologie et de démographie.
Elle est aussi apparue dans des contextes plus inattendus. En 1963, devant une commission parlementaire canadienne, un représentant de l’industrie chimique l’a ainsi mise en avant pour justifier le recours aux pesticides chimiques : il fallait pouvoir nourrir une population sur le point d’exploser. En 1971, dans une affaire concernant l’avortement portée devant la Cour suprême des États-Unis, qui a précédé l’arrêt Roe v. Wade, elle a été invoquée pour soutenir qu’aucune raison impérieuse ne justifiait que le gouvernement encourage la croissance démographique.
L’idée d’une fin du monde démographique a perduré en partie parce que ses prévisions se sont révélées très exactes – du moins pendant un temps. L’équation centrale de l’article donnait des projections plus fiables que celles de la plupart des démographes tout au long des années 1970 et 1980.
Ce n’est que vers 1993 que cette précision a commencé à s’émousser et que la population mondiale s’est mise à croître moins vite que prévu : le monde commençait à faire ce que von Foerster et ses collègues avaient préconisé. Aujourd’hui, le taux de natalité mondial est un peu inférieur à la moitié de celui de 1960.
Science et art de la mise en scène
Nous ne nous réveillerons probablement pas tous le vendredi 13 novembre « écrasés par la foule ». Mais avant de passer à autre chose – et de nous préparer au prochain scénario de fin du monde –, demandons-nous ce que celui-ci peut nous apprendre.
À mes yeux, la leçon tient à la manière dont nous présentons nos convictions au monde. Heinz von Foerster a été, à une période de sa vie, prestidigitateur. Selon les principes classiques de la mise en scène, une illusion réussie repose sur trois étapes : la mise en place, le coup de théâtre et la révélation finale qui ramène la situation à la normale.
L’article de von Foerster et de ses coauteurs a fait sensation en associant un contenu scientifique classique à un titre et à une conclusion spectaculaires. S’il a durablement marqué les esprits, c’est parce qu’il s’appuyait sur des recherches et un raisonnement solides.
Passer par l’absurde pour attirer l’attention du monde sur une question sérieuse : voilà un beau tour de magie.

Alan MacEachern ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
07.10.2026 à 11:42
La peste a-t-elle tué une chercheuse russe ? Ce que l’on peut dire à ce stade
Thomas Jeffries, Senior Lecturer in Microbiology, Western Sydney University
Texte intégral (1512 mots)
L’ESSENTIEL
Une employée d’un laboratoire russe est morte en Sibérie : la peste est suspectée, mais n’a pas été confirmée.
La peste pulmonaire peut se transmettre entre humains et se soigne par antibiotiques si elle est traitée rapidement.
Le risque pour la population semble faible, mais des informations transparentes restent nécessaires pour l’évaluer.
Les informations contradictoires sur la mort d’une employée de laboratoire dans un institut russe de recherche sur la peste ont alimenté les craintes d’une possible propagation de la peste pulmonaire.
Près de 200 personnes sont en quarantaine en Sibérie après que Darya Shipilova, 28 ans, est tombée malade sur son lieu de travail, avant de mourir le 2 octobre.
Les circonstances exactes de sa mort restent inconnues. La semaine dernière, un haut responsable russe a écrit sur les réseaux sociaux que Shipilova était « morte de la peste », avant de modifier sa publication pour ajouter « peut-être ». L’autorité sanitaire russe a depuis déclaré qu’elle était décédée d’une « pneumonie d’origine inconnue ».
Des médias locaux ont évoqué une contamination à la suite d’un accident dans le laboratoire où elle travaillait, l’Institut de recherche sur la peste de Sibérie et d’Extrême-Orient, à Irkoutsk. Ces informations n’ont toutefois pas été confirmées.
Qu’est-ce donc que la peste et comment se transmet-elle ? Faut-il s’inquiéter ?
Qu’est-ce que la peste ? Existe-t-il différentes formes ?
La peste est causée par la bactérie Yersinia pestis. Celle-ci se trouve généralement chez des rongeurs vivant au sol, comme les rats et les chiens de prairie, mais elle peut aussi infecter les humains.
(La peste est une maladie qui sévit toujours de nos jours, en particulier en Afrique, Asie et Amérique. Elle fait même partie des maladies ré-émergentes dans le monde, précise l’Institut Pasteur qui fait le point sur cette pathologie dans ses pages, ndlr).
Cette même bactérie peut provoquer trois formes différentes de peste.
La peste bubonique se transmet des animaux aux humains par l’intermédiaire des puces et provoque un gonflement des ganglions lymphatiques, appelés « bubons ». Les autres symptômes comprennent de la fièvre, des maux de tête, des frissons et une sensation de faiblesse. La peste bubonique peut tuer en quelques jours si elle n’est pas traitée par des antibiotiques. Sans traitement, 30 à 60 % des personnes qui contractent cette forme de peste en meurent.
La peste septicémique peut se développer lorsqu’une peste bubonique n’est pas traitée, ou survenir directement si la bactérie pénètre dans la circulation sanguine. Elle provoque des hémorragies dans les organes. Son nom renvoie à la septicémie, une grave infection du sang que cette forme de la maladie peut entraîner.
La peste pulmonaire – soupçonnée, sans confirmation à ce stade, d’avoir causé la mort de Shipilova en Sibérie – peut survenir lorsque la peste bubonique se propage aux poumons. Mais elle peut aussi se transmettre d’une personne à l’autre par de minuscules gouttelettes respiratoires. C’est la forme la plus rare, mais aussi la plus grave. Sans traitement, son taux de mortalité peut atteindre 100 %.
Aux autres symptômes s’ajoute une pneumonie sévère, c’est-à-dire une infection des poumons, ici causée par une bactérie.
La peste, une maladie du Moyen Âge ?
La peste bubonique a causé la mort de dizaines de millions de personnes dans l’ouest du bassin méditerranéen entre 541 et 750 de notre ère : c’est la peste de Justinien. Au Moyen Âge, elle a tué jusqu’à la moitié de la population européenne lors de la peste noire.
Mais des épidémies ont également eu lieu depuis le Moyen Âge.
À lire aussi : La découverte d’une liste de survivants de la peste noire éclaire la façon dont on guérissait de la maladie au Moyen Âge
Une troisième pandémie, survenue à la fin du XIXe siècle et au début du XXe, a fait jusqu’à 12 millions de morts. La peste reste endémique en Asie centrale, en Afrique, dans les Amériques et en Sibérie, où l’employée du laboratoire russe est morte la semaine dernière. Cela signifie que la maladie persiste dans ces régions à un niveau relativement stable.
La peste touche surtout les zones rurales et agricoles. Une éventuelle fuite de laboratoire en pleine ville constituerait donc un cas inhabituel.
Peut-on la soigner ?
Oui. Un traitement antibiotique de 10 à 14 jours, par voie orale ou intraveineuse, permet de soigner la peste, à condition de commencer rapidement après l’infection. Toutefois, depuis 1995, plusieurs souches résistantes aux antibiotiques ont été détectées dans la nature.
Dans les années 1980, des scientifiques soviétiques ont également mis au point des souches résistantes. Ces travaux ont depuis nourri des scénarios hypothétiques de guerre biologique.
Toutefois, rien ne prouve que la souche soupçonnée d’avoir causé la mort de Shipilova soit résistante aux antibiotiques, ni que le laboratoire mène des recherches sur les armes biologiques.
Faut-il s’inquiéter ?
Une seule épidémie majeure de peste pulmonaire a été documentée : elle a eu lieu en Chine dans les années 1910. Nous savons encore peu de choses sur le cas survenu en Sibérie. Mais à ce stade, peu d’éléments laissent craindre une épidémie, qui resterait localisée, ou une pandémie, qui toucherait plusieurs pays.
Dans un communiqué, l’Organisation mondiale de la santé (OMS) a indiqué avoir connaissance d’informations selon lesquelles le décès d’une employée de laboratoire dans la région d’Irkoutsk, en Sibérie, fait l’objet d’analyses pour déterminer s’il pourrait être lié à la peste pulmonaire ».
Et les services de l’OMS d’ajouter que : « sur la base des informations actuellement disponibles […] le risque est modéré à faible pour Irkoutsk, faible pour la Fédération de Russie dans son ensemble et très faible pour la région européenne ». Ils concluent que « cette évaluation pourra être révisée en fonction des nouvelles informations disponibles. »
Pour évaluer ce risque, il sera essentiel de disposer d’informations transparentes sur les circonstances dans lesquelles Shipilova est tombée malade puis est décédée.

Thomas Jeffries ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 16:19
What Europe’s EU Inc. framework for boosting competitiveness can and should learn from startup fraud in the US
Nevena Radoynovska, Associate Professor of Strategy, Organizations and Social Innovation, EM Lyon Business School
Tim Weiss, Assistant Professor, Department of Management and Entrepreneurship, Imperial College London
Texte intégral (2163 mots)
The European Parliament and the Council of the European Union are currently debating EU Inc, draft legislation seeking to establish a single set of rules for starting, operating, and growing a business across EU member states. The proposed framework is designed to make business registration and operation within the EU faster, easier, and more harmonised.
The proposed “28th regime” promises company registration within 48 hours for under €100 via fully digitalised procedures – including for raising capital and accessing the stock market, and simplified liquidation proceedings to make dissolving and relaunching a business more seamless. The proposal is part of the broader EU Startup and Scaleup Strategy, whose ambition is to narrow the innovation gap between the EU and its global competitors, notably the United States.
The European Union arguably has a significantly smaller venture capital market, fewer unicorns, and lower valuations for comparable companies relative to the US. Yet in its desire to catch up with its North American partner, we suggest the EU treads carefully to avoid reproducing some of the very features that have made the Silicon Valley startup model vulnerable to fraud.
At this moment, the Silicon Valley star-turned-villain, Elizabeth Holmes, is the protagonist of a new documentary You Can See Everything. The documentary chronicles the 34 days in 2023 before the founder of the former biotech startup, Theranos, entered federal prison to serve a 135-month sentence for defrauding investors. As scholars who have studied criminal deception and investor fraud in Silicon Valley, it’s clear that Elizabeth Holmes and Theranos are just one of many startup fraud cases. The problem is deeper than we usually acknowledge.
The startup fraud problem in Silicon Valley
Startups are important drivers of technological innovation, progress, and hope for the future. But systemic features of the startup ecosystem also make them particularly vulnerable to misconduct and fraud. Together, a culture of “creative destruction”, highly liquid private capital markets, little formal oversight, and technological hype cycles create conditions for fraud to prosper.
These features are on display in high-growth startup contexts like Silicon Valley, where the immense pressure to churn out unicorns (i.e. achieve $1 billion in valuation in less than seven years) can push founders to blur the line between reality and fiction.
In our recent study of startup fraud in Silicon Valley, we argue that investor pressure to demonstrate product-market fit, technological readiness and an exponential growth trajectory can incentivise entrepreneurs to engage in fraud, especially when a gap between investors’ expectations and startup reality forms and widens.
What we’re seeing is not the typical Ponzi scheme or a shell company. For the most part, the entrepreneurs we studied started real businesses with genuine ambitions. Along the way, they began justifying fraud as the only way to keep investors and other stakeholders committed to their company when technology, customer contracts, or regulatory approvals didn’t materialise as expected.
Startup fraud involves varying degrees of sophistication with one key commonality. Entrepreneurs create a façade – a shiny startup image of an exponentially growing company to mask a lack of performance. Less sophisticated forms of fraud can involve reporting revenue from expired and non-renewed client contracts or faking bank statements to falsely substantiate early revenue growth.
Entrepreneurs create more sophisticated façades during a startup’s growth stage, when founders need to raise large rounds and investors expect to see rapid scaling. In the case of Theranos, Elizabeth Holmes and Ramesh Balwani staged fake product demos before investors. They showed investors around research and development labs, took a drop of investors’ blood, and reported the results of the blood tests as if they had come from Theranos’ “transformative” technology. In reality, the tests were conducted behind closed doors using conventional methods on third-party machines. The forensic analyses reported during Elizabeth Holmes’s trial even mention the use of code names to refer to the third-party machines internally so that Theranos’ own employees wouldn’t suspect the deception.
In even more sophisticated schemes, startup founders enlisted their employees to impersonate high-profile customers or venture capital investors during investors’ due diligence calls. They registered false phone numbers, made introductions, and had the fake client (a real company employee) present glorious endorsements of the startup. In the most severe cases, entrepreneurs fully faked official audit reports from auditors such as KPMG and falsely affirmed that their company complied with current regulations.
The fact that investors’ due diligence processes – designed to fact-check startups and their aspirational claims – can themselves be hijacked underscores the severity of the problem. Investors want to see exponential growth fast, and entrepreneurs find creative ways to give them what they want, even if it means crossing the line into criminal offences. Full verification of every founder claim is far beyond the scope of common due diligence processes. Yet it is ever more necessary given extreme growth pressures. As a result, the regulatory body in charge of overseeing public firms, the Securities and Exchange Commission (SEC), is increasingly stepping in to fact-check private startups.
Unfortunately, the SEC tends to intervene once fraud has already occurred and somebody has blown the whistle.
What makes startup fraud all the more concerning is that it is highly likely to become more widespread. Startups are staying private for longer, delaying going public (if at all), and flying under the radar of public and regulatory scrutiny all while raising ever higher amounts of capital.
There is also growing concern that we’re in the midst of an AI hype cycle. AI startups and companies are fuelling impressive expectations for returns on investment, with valuations reaching $965 billion for Anthropic and growing concerns that the bubble might soon burst. Studies have shown that risk-capital-backed startups founded during hype cycles are more likely to commit fraud. Moreover, with new AI capabilities, producing deepfakes can make it even easier to fabricate financial data, impersonate customers and investors, and construct shiny façades of high growth. EU Inc.’s ambition to fully digitalise procedures across a company’s lifecycle could introduce key vulnerabilities in this respect.
An opportunity for EU Inc. to curb startup fraud
As debates over EU Inc. unfold, it’s important to acknowledge that the EU is not without its own high-profile startup fraud cases, including Germany’s Wirecard, the payment-processing unicorn Unzer, and the Swiss-German crypto startup Envion AG, which are collectively deemed responsible for €2.3 billion in investor losses. With Europe seemingly eager to learn from the US startup model, it would do well to avoid replicating those very systemic features of Silicon Valley: limited oversight, highly liquid private capital markets, and ambition for fast growth at all costs that can blind investors, customers, and even regulators with stardust.
Curbing startup fraud requires action at multiple levels that target punishment, detection, and prevention. EU Inc. presents a unique regulatory moment to build in corrective measures from the start.
In terms of punishment, the involvement of judiciary bodies in criminally prosecuting startups is an important signal that regulators are serious and that fraud carries consequences beyond monetary fines. Not all prosecutions are as headline-worthy as that of Elizabeth Holmes. Yet increasing criminal investigations into startup fraud underscore the fact that the problem is more common than we think and far from the responsibility of a few bad apples.
In terms of detection, creating a mandate for regulatory agencies to oversee and investigate startups could help surface more fraud cases earlier in the process rather than after fraud has prospered for years. At this stage, EU Inc. simply invites member countries to consider establishing specialised judicial bodies to oversee disputes over company law. In the meantime, the European Securities and Markets Authority could expand its role in investigating fraud and bringing cases to the attention of the courts.
Safeguarding and bolstering protections for internal whistleblowers are also important measures for alerting EU regulators of fraud. In our study, many instances of fraud were detected by employees or board members, reinforcing the need to protect insiders with vital knowledge of company operations. Encouragingly, whistleblower protection laws are already more comprehensive in the EU than those that exist in the US.
Strengthening board independence to ensure close oversight of founder-CEO activities can additionally help curb fraud. A recent study found that startups with founder-controlled boards were 88% more likely to commit fraud compared with those where board control is shared or controlled by VCs.
Finally, the verifiability of company records (past and current performance data and developmental milestones) is also key. Third-party certifiers beyond traditional auditors have a place in the startup ecosystem to support existing due diligence processes that appear to be fallible. Developing a denser ecosystem of actors charged with verifying startups’ financial claims can support efforts by regulatory bodies and public prosecutors, who are currently under-resourced to address the scale of startup façading.
Perhaps the hardest task is to weaken the incentives for entrepreneurs to commit fraud in the first place. This implies rethinking sticky values like “growth at all costs”, “fake it ‘til you make it” and “move fast and break things”. EU Inc.’s focus is on harmonising complex regulations and easing the cost of starting a business. We think it’s at least as important that the legislation enshrine a set of values for entrepreneurs, investors, customers, board members, and other ecosystem actors to build businesses for the long run, rather than to prop up startups artificially for quick, spectacular returns.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
06.10.2026 à 15:58
Surveiller, se reproduire, récupérer : comment les chimpanzés organisent leurs nuits
Clara Hozer, Docteure en chronobiologie, écophysiologie, comportement, Muséum national d’histoire naturelle (MNHN)
Texte intégral (3104 mots)
L’ESSENTIEL
En Ouganda, une étude récente chez les chimpanzés dans leur milieu naturel est parvenue pour la première fois à les filmer endormis.
Les mâles dominants réduisent leur temps de sommeil en présence d’autres mâles, probablement pour surveiller de potentiels rivaux, mais également en présence de femelles en activité sexuelle.
Cette étude illustre les compromis nécessaires entre sommeil et activités sociales que les animaux doivent adopter dans la nature.
Dormir est essentiel : système immunitaire, mémoire, apprentissage, et tant d’autres fonctions biologiques tirent profit des heures passées dans cet état d’inconscience réversible. Mais qui dit sommeil, dit impossibilité de chercher de la nourriture, de se protéger des prédateurs, de se reproduire ou d’entretenir des relations sociales. Comment les individus parviennent-ils à gérer ce compromis entre activités et sommeil ?
Au sein d’espèces grégaires, comme de nombreux primates (dont les humains), les facteurs sociaux, tels que le rang, la taille ou la composition du groupe, pourraient plus particulièrement influencer la durée, la phase et la fragmentation du sommeil.
Pour mieux comprendre cette balance entre sommeil et vie sociale, nous avons mené une étude chez l’un de nos plus proches cousins, le chimpanzé. Ce primate vit en communautés de plusieurs dizaines voire centaines d’individus, selon un modèle de fission-fusion : au cours de la journée, les individus peuvent être seuls, se regrouper ou se séparer de manière dynamique en sous-groupes de taille variable. Afin d’étudier ces interactions dans toute leur complexité, nous avons suivi les chimpanzés dans leur milieu naturel, au sein de la communauté de Sonso dans la forêt de Budongo, en Ouganda.
Cette communauté, occupant un territoire d’environ 6 kilomètres carrés, est composée d’environ 70 individus, dont 10 mâles adultes. Elle est suivie quotidiennement depuis plus de trente ans ; les chimpanzés sont donc très habitués à la présence humaine.
Filmer le sommeil de chimpanzés dans leur milieu naturel
Pas facile du tout de mesurer le sommeil de chimpanzés sauvages. Il faut savoir que ces grands singes construisent des nids individuels à 12 mètres de hauteur en moyenne ! Et comme si cela ne suffisait pas, ils construisent un nouveau nid chaque soir, rendant impossible la pose de caméras fixes. Le premier défi de cette étude a donc été de trouver un moyen de filmer l’intérieur de ces nids.

Pour ce faire, nous suivions un chimpanzé dans la forêt de l’aube jusqu’au soir, où l’individu construisait son nid pour la nuit. Il fallait alors être très rapide et efficace : en quelques minutes, nous devions noter l’heure à laquelle l’individu s’était couché, mesurer la hauteur du nid, décider l’endroit idéal pour poser notre caméra, le dégager grossièrement, et patienter en silence pour ne pas déranger les chimpanzés en train de se coucher. Nous relevions également l’identité de tous les individus présents dans des nids dans un rayon de 25 mètres.
Une fois la nuit tombée, il était temps de déployer dans la plus grande discrétion une perche télescopique pouvant atteindre 16,5 m de haut. Au sommet de cette perche, un piège-caméra (caméra très robuste utilisée pour suivre la faune sauvage) filmant en infrarouge était positionné à la hauteur du nid. Le tour était joué ! Il ne restait plus qu’à revenir le lendemain matin récupérer la perche et les vidéos enregistrées pendant la nuit.

Nous avons ainsi filmé 116 nuits chez 35 individus de sexe et d’âge différents. Chaque nuit, nous avons mesuré la durée totale du sommeil, sa fragmentation (nombre de réveils nocturnes par heure) ainsi que l’heure de réveil.
Ce travail a permis d’obtenir les toutes premières données sur le sommeil des chimpanzés en milieu naturel. Ils dorment en moyenne neuf heures et trente minutes par nuit, une valeur supérieure de deux heures à celle de l’humain, mais avec de grandes disparités, tant interindividuelles que d’une nuit à l’autre, la durée de sommeil pouvant varier de sept heures à onze heures et demie par nuit.
Comme les humains, ils dorment principalement sur le côté et sur le dos, mais ont la particularité de dormir assis quand il pleut ! Ils se réveillent en moyenne trois fois par nuit pour faire leurs besoins (jamais à l’intérieur du nid, par propreté), pour échanger des vocalisations avec leurs congénères et même parfois pour se délecter de quelques feuilles aux alentours. Nous avons ensuite étudié l’impact des facteurs sociaux sur le sommeil plus en détail.

Les mâles dominants dorment moins longtemps que les autres mâles
La communauté de Sonso étant suivie depuis des années, des données sur chaque chimpanzé sont disponibles, notamment concernant l’évolution de leur rang social. Ainsi, les mâles et les femelles peuvent être classés, de l’individu le plus dominant au plus subordonné.
En comparant la durée de sommeil entre les individus dominants et subordonnés, il résulte que les mâles dominants sont ceux qui dorment le moins et ont le sommeil le plus fragmenté. Ils dorment en moyenne huit heures et demie par nuit contre neuf heures et demie chez les autres mâles. Une heure de sommeil peut sembler anecdotique, mais il s’agit ici d’une moyenne. Cette heure, cumulée sur de longues périodes, représente en réalité une grande différence et un manque de sommeil non négligeable !
Les mâles dominants étant responsables du groupe, il leur incombe un rôle de protection, ce qui expliquerait les réveils plus fréquents. Cependant, une interprétation alternative est possible : ces réveils pourraient plutôt refléter une vigilance accrue à l’égard de la concurrence, c’est-à-dire des autres mâles.
Pour étayer cette seconde hypothèse, nous avons observé que la durée de sommeil chez les dominants était fortement modulée par le nombre de mâles présents dans le groupe de sommeil : plus ce nombre était élevé, plus la durée de sommeil était réduite chez les mâles dominants (en moyenne douze minutes de moins par mâle supplémentaire présent), alors que l’effet inverse était observé chez les individus subordonnés, qui, eux, pourraient bénéficier d’un sentiment de sécurité accru en groupe.
En étudiant les comportements adoptés par les chimpanzés lors des réveils nocturnes, une autre observation tend également à confirmer cette hypothèse : les mâles dominants étaient davantage susceptibles d’avoir un comportement de vigilance (regards répétés aux alentours) lorsque le nombre de mâles dans le groupe augmentait !
Entre se reproduire et dormir, il faut choisir !
Autre observation intéressante, bien que plus prévisible : la présence d’une femelle en œstrus (c’est-à-dire en activité sexuelle) dans le groupe de sommeil chamboule le sommeil des mâles : construction de nid tardive, sommeil réduit (en moyenne de vingt-trois minutes par nuit), fragmentation accrue et réveil avancé. En somme, le sommeil est sacrifié pour optimiser ses chances d’accéder aux femelles pendant ou après la nuit, mais peut-être au prix d’une santé altérée ?
Un coût à payer pour le sommeil réduit ?
Les heures de sommeil en moins se répercutent-elles sur d’autres fonctions, notamment cérébrales ? En effet, il est connu chez les humains et chez les rongeurs qu’un sommeil court et fragmenté altère les fonctions cognitives et émotionnelles. Alors, comment les mâles dominants maintiennent-ils un niveau d’attention élevé le jour malgré un sommeil réduit, alors qu’ils sont précisément les individus dont le statut exige des performances cognitives plus élevées pour surveiller le groupe, gérer les interactions sociales et maintenir leur position hiérarchique ?
Pour répondre à cette question, il faudrait mesurer les performances cognitives des chimpanzés dans leur milieu naturel, mais ce protocole est très difficile à mettre en place en raison de la nécessité d’isoler l’individu du groupe le temps de lui faire passer le test. En attendant, on peut seulement émettre des hypothèses.
Il est possible, tout d’abord, que les individus dormant moins la nuit compensent grâce à des siestes le jour, mais aucune de nos données n’étaye cette hypothèse pour l’instant. Il est également possible que certains individus possèdent des adaptations génétiques leur permettant de performer aussi bien que les autres, même avec très peu de sommeil. Enfin, le manque de sommeil généré n’est peut-être pas suffisant pour engranger des déficits cognitifs. De manière intéressante, plusieurs études menées au sein d’autres espèces non primates ont démontré qu’un déficit de sommeil n’entraînait pas de désagréments immédiats et pouvait même favoriser la reproduction !
Et chez les autres primates ?
Observe-t-on les mêmes phénomènes chez les autres espèces grégaires de primates ? Il est un peu tôt pour répondre à cette question tant les études sur le sommeil en milieu naturel sont rares. Cependant, des études chez les babouins (Papio ursinus) en milieu naturel et chez les géladas (Theropithecus gelada), cette fois-ci en captivité, corroborent nos observations : les individus dominants sont ceux qui dorment le moins.
Par ailleurs, d’autres études chez les orangs-outans et les babouins montrent que plus la taille du groupe augmente, plus le sommeil est réduit et fragmenté : dormir en groupe pourrait favoriser les interactions sociales, les opportunités d’accouplement ou la protection contre les prédateurs, mais au prix d’un sommeil moins long et de moindre qualité.
Et chez l’humain, quel parallèle pouvons-nous tirer de ces résultats ? Il semblerait que nos ancêtres aient été confrontés au même genre de dilemme que leurs cousins. En effet, de tous les primates, l’humain est celui qui dort le moins ! Une hypothèse est que la maîtrise du feu aurait allongé artificiellement les journées et, ainsi, les interactions sociales, en échange d’un sommeil plus réduit, faisant écho à ce qu’il se passe chez les autres singes. Pour compenser, il aurait développé un sommeil plus profond, lui permettant de maintenir des performances sociales et cognitives élevées. Est-ce que les chimpanzés sont capables de telles adaptations ? Mystère…

Clara Hozer ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 15:57
Poivres et piments : un nouvel engouement pour les plus vieilles des épices
Hirac Gurden, Directeur de Recherches en Neurosciences au CNRS, Université Paris Cité
Texte intégral (2235 mots)
L’ESSENTIEL
La popularité du poivre (originaire d’Asie) et du piment (originaire d’Amérique) s’est installée en Europe depuis des siècles.
Nous disposons de récepteurs spécifiques pour détecter leur piquant et leur chaleur, mais c’est un apprentissage socioculturel qui nous les fait apprécier.
Expositions, concours télévisés, monographies… la diversité des espèces de poivres et de piments se donne à voir tous azimuts.
« Tu peux me passer le poivre, s’il te plaît ? » C’est la plus banale des phrases au monde. Mais quand on tourne son moulin à poivre, on ignore qu’on tient plusieurs milliers d’années de l’histoire de l’humanité dans ses mains.
Le poivre, puis le piment qui débarquera plus tard sur les tables européennes, témoignent aussi des chocs passés entre Empires pour contrôler le commerce international.
Actuellement, la production mondiale d’épices n’a jamais été aussi forte de toute l’histoire. Plus de 5 millions de tonnes de piments séchés, près d’un million de tonnes de poivre et cinq millions de tonnes de gingembre sont produits. En comparaison, même si le safran et la vanille sont de loin les plus chères des épices (prix de vente maximal au détail jusqu’à 45 000 euros le kilogramme pour le safran, 1 000 euros le kilogramme pour la vanille), ils restent très faibles en tonnage, d’après les chiffres de l’Organisation des Nations unies pour l’alimentation et l’agriculture (FAO).
Des plantes tropicales au cœur d’enjeux stratégiques pour l’Europe
Le poivre n’est disponible à volonté que depuis peu de temps. Au Moyen Âge par exemple, sa quantité en Europe, en provenance de son pays d’origine, l’Inde, était faible et son prix équivalait à celui de l’or. On l’appelait d’ailleurs l’« or noir » et, quand on payait en espèces, on payait en grains de poivre noir.
En Europe, à l’époque, la consommation des baies du poivrier, une liane dont le nom botanique est Piper nigrum, est emblématique de la fascination exercée par les épices orientales et de la forte demande dont elles ont fait l’objet. Rappelons que la distance entre la France et l’Inde, directement à vol d’oiseau, est de 7 300 km qu’il fallait parcourir par des routes caravanières et surtout maritimes pendant des mois, voire des années.
Et bien plus tard, après les voyages de Christophe Colomb à la fin du XVᵉ siècle, le piment (de son nom botanique Capsicum) deviendra la plus consommée des épices venant des Amériques et prendra progressivement la place de première épice mondiale à la fin du XXe siècle, selon le tonnage indiqué par la FAO.
À chaque épice, ses siècles de domination, mais aussi ses enjeux géostratégiques pour s’en fournir, puisqu’à l’origine ces plantes tropicales poussent très loin d’Europe, sur des territoires que les Européens voudront conquérir.
Au fil des siècles, des épices prisées par les puissants
Commençons par le poivre, espèces et épices. En latin tardif, species a pu prendre le sens de denrées, de marchandises, et particulièrement, parmi ces dernières, de drogues et d’épices.
Jusqu’à la Renaissance, les Européens n’avaient pas d’accès direct aux cultures du poivre en Inde. Ce sont des marchands arabes préislamiques puis islamiques, les Indiens et les Perses qui faisaient le lien est-ouest et alimentaient les ports d’Alexandrie en Égypte et de Byzance en épices et en légendes. Pour la chrétienté, à l’Est étaient situés le jardin d’Éden, la fontaine de jouvence et le paradis ; alors, ces baies provenant de cette direction magique étaient divines et, par la logique commerciale, leur prix était colossal.
Sur cette base, et dans le sillage du poivre long et à grains (Inde), la cannelle (Sri Lanka) et le gingembre (Chine), puis le macis, la noix de muscade et le clou de girofle (Indonésie) régnèrent pendant des siècles sur le commerce à longue distance pour approvisionner toutes les cours européennes afin que les élites du pouvoir fassent étalage de leur puissance. Ces plantes exotiques hors du commun servirent de moteur à une quête de puissance mondiale jamais égalée.
Autour de la période des croisades, la République de Venise domina progressivement la redistribution des épices en Méditerranée et en Europe.
Pour accéder directement aux régions productrices d’épices orientales et contourner les intermédiaires mamelouks en Égypte, la République de Venise ainsi que, plus tard, l’Empire ottoman, les Portugais ouvrirent une route maritime vers l’Inde en contournant l’Afrique après presque un siècle d’efforts. Ainsi, Vasco de Gama arriva à Calicut en 1498.
Quant aux rois catholiques d’Espagne, ils financèrent les quatre voyages de Christophe Colomb vers l’Ouest pour créer, pensaient-ils, leur propre route d’approvisionnement des épices indiennes. Toute sa vie, Colomb resta persuadé d’avoir découvert les Indes occidentales et non pas les Amériques.
C’est en compensation de l’absence de poivres de ces nouvelles terres que Christophe Colomb ramena… le piment. La famille des piments provient probablement de l’Amazonie bolivienne. Le piment aurait été essaimé par les oiseaux vers le Mexique et les Caraïbes.
Grâce aux progrès de la navigation, les Ibériques portèrent le commerce des épices à un niveau mondial et les deux Empires portugais et espagnols se partagèrent le monde. En créant les Compagnies des Indes dès 1600, Anglais et Hollandais conquirent les comptoirs dans l’océan Indien et en Asie du Sud-Est. La course à la mondialisation qui se servira largement de l’esclavage était lancée.
Pourquoi l’humain apprécie-t-il des molécules irritantes ?
La pipérine des Piper et la capsaïcine des Capsicum sont des molécules synthétisées par la plante et utilisées pour se défendre contre des micro-organismes par des effets bactéricides, mais aussi contre les prédateurs phytophages de leurs fruits pour empêcher qu’ils ne soient tous mangés avant le développement de nouvelles plantes. Pourquoi ces sensations de piquant et de chaleur nous plaisent-elles tant alors qu’aucun autre primate n’aime ce genre d’irritations ?
La première explication est médicale et elle tient dans la théorie des quatre humeurs (sang, phlegme, bile jaune, bile noire) développée par le médecin de l’Antiquité grecque Hippocrate et qui a marqué tout le Moyen Âge. Cette théorie est proche de la médecine traditionnelle ayurvédique indienne. Dans la Charaka Samhita, le premier écrit, mais à la datation incertaine, où il est fait mention des trois doshas (les énergies vitales en médecine ayurvédique, nlr), le poivre, considéré comme « chaud et sec », était employé pour corriger des excès « de froid et d’humidité » (phlegme).
La deuxième raison est à la fois biologique et culturelle, l’une influençant l’autre. Notre visage est rempli de capteurs sensoriels pour les cinq sens classiques : olfaction, goût, toucher sur notre peau, audition et vision, mais aussi un sens peu connu qui est très important pour apprécier les épices : le système trigéminal.
Le nerf trigéminal est un nerf crânien qui permet une sensibilité dans les yeux, le nez et la bouche par rapport à la présence de molécules irritantes dans l’air ou sur la langue. Exemple : je coupe des oignons ; je libère des molécules soufrées dans l’air qui se dissolvent dans mes yeux, je pleure pour protéger mes yeux d’une acidification excessive. Merci, le système trigéminal !
Des récepteurs aux épices au niveau du visage
Les fibres sensitives de ce nerf disposent de récepteurs spécifiques capables de fixer la pipérine des poivres et, plus fortement encore, avec plus d’affinité, la capsaïcine des piments. Une fois le duo formé, s’enclenche la sensation de piquant ou de chaleur créée par le cerveau.
Ces stimulations intenses qui existent très peu avec les herbes aromatiques européennes comme le thym viennent ajouter à la richesse sensorielle de l’une de nos activités les plus intenses et complexes qui fait que nous pouvons nous définir en tant qu’Homo sapiens (du latin sapere, au double sens de savoir et goûter) : la cuisine.
De l’Empire romain… à des concours télévisés
Les poivres possèdent de multiples arômes, mais aussi cinq couleurs, signes de leur goût différent : leurs baies peuvent être vertes immatures, rouges matures, noires issues du traitement des baies vertes, blanches issues du traitement des baies rouges mais aussi grises, issues de baies noires moulues, oxydées et sans goût, qui passent des mois dans les poivriers.
Une demi-douzaine d’espèces, incluant le poivre long, égaye nos plats depuis plus de 2 000 ans après l’Empire romain. Côté piment, cinq espèces de piments ont été domestiquées par l’humain depuis 1492, mais il est actuellement impossible de dénombrer leurs variétés horticoles, développées localement, tellement elles sont nombreuses.
Au Mexique, par exemple, il est dit que chaque village s’enorgueillit de son propre piment ! Leurs couleurs varient du vert immature, au rouge très vif à pleine maturité, en passant par le jaune et l’orange.
Avec le piment, ça explose actuellement sur l’échelle de Scoville avec les Hot Ones, les concours et émissions de dégustation de piments à force croissante ! Mais c’est en… 1912 que ce pharmacologue introduisit cette échelle afin de distinguer les différentes forces de chaleur des piments.
Le poivron vert doux a une valeur de 0 Scoville Heat Units (SHU ou unité de chaleur selon l’échelle de Scoville). Le piment d’Espelette atteint jusqu’à 4 000 SHU, le piment jalapeño jusqu’à 8 000 SHU, et, au maximum de l’échelle, le Pepper X atteint 2,7 millions de SHU.
Enfin, un conseil utile : en cas de brûlure en bouche, évitez absolument l’eau et mangez un yaourt. La capsaïcine est lipophile et hydrophobe, donc elle se mélange bien au gras.
Hirac Gurden est cocréateur de l’exposition itinérante grand public « le Goût des épices » présentée à l’Espace des sciences « les Champs libres », à Rennes (Ille-et-Vilaine), à partir du 5 octobre 2026. L’exposition aborde de manière ludique l’histoire et la géographie des épices, leur botanique, ainsi que les mécanismes cérébraux qui sous-tendent la perception de leur goût.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Hirac Gurden ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 15:56
Les amendes forfaitaires pour consommation de stupéfiants se multiplient : quels effets, et quel bilan ?
Ivana Obradovic, Directrice adjointe de l’Observatoire français des drogues et des tendances addictives (OFDT), chercheuse associée au CESDIP, Université de Versailles Saint-Quentin-en-Yvelines (UVSQ) – Université Paris-Saclay; Université Paris 1 Panthéon-Sorbonne
Texte intégral (2423 mots)
L’ESSENTIEL
Depuis 2020, les forces de l’ordre ont la possibilité de sanctionner les consommateurs de stupéfiants d’une amende forfaitaire délictuelle.
Cette procédure a entraîné une forte hausse des délits enregistrés. Elle est critiquée pour les irrégularités et les inégalités sociales dans son application.
Elle illustre une tendance à la standardisation des sanctions et à la pénalisation financière au détriment de l’individualisation des sanctions.
En 2025, près de 367 000 personnes ont été mises en cause pour une infraction liée aux stupéfiants, dont plus de 80 % pour simple consommation, le plus souvent de cannabis. Ce contentieux de masse ne cesse de croître depuis les années 2000 : rien qu’entre 2016 et 2025, le nombre de consommateurs interpellés a bondi de 70 %, contre seulement 40 % pour le trafic. Cette progression s’est encore accentuée depuis 2020, quand les forces de l’ordre ont obtenu la possibilité de verbaliser les consommateurs sans procédure pénale, du fait de l’extension de l’amende forfaitaire délictuelle (AFD) à la consommation de stupéfiants.
Quels ont été les effets de cette réforme sur le traitement pénal de ce contentieux de masse ?
Dans un contexte budgétaire contraint et marqué par un engorgement des services judiciaires, ces amendes peuvent certes apparaître comme un moyen d’assurer une réponse pénale simplifiée, rapide et systématique. Mais le bilan de leur mise en œuvre s’avère contrasté.
Vers une pénalisation standardisée ?
Sanction pénale prononcée par un agent de police sans l’intervention d’un magistrat, l’amende forfaitaire a été créée en 1926 en matière contraventionnelle, pour désengorger les tribunaux d’une masse d’infractions routières jugées de faible gravité.
Près d’un siècle plus tard (2016), elle a été étendue au domaine délictuel afin de favoriser un traitement rapide et simplifié des nombreux délits routiers jusqu’alors passibles d’emprisonnement (conduite sans permis ou sans assurance).
Depuis dix ans, le périmètre d’application de l’amende forfaitaire délictuelle n’a cessé d’être élargi, jusqu’à concerner une centaine de délits dépassant largement le domaine routier, incluant par exemple :
la consommation de stupéfiants (depuis 2019/2020) ;
la vente à la sauvette, les tags et les graffitis, l’introduction de boissons alcoolisées dans un stade lors d’un événement sportif (depuis 2023) ;
l’inhalation de protoxyde d’azote hors cadre médical ou la participation à une rave-party non déclarée (depuis 2026).
Entre 2019 et 2024, 1,6 million d’amendes forfaitaires délictuelles ont été délivrées par la police et la gendarmerie, suivant une courbe de croissance de 14 % par an en moyenne. Plus de 40 % de ces amendes ciblent la consommation de stupéfiants (en général de cannabis).
Une forte poussée des amendes forfaitaires délictuelles depuis 2020 : quels effets ?
En quelques années, le traitement pénal de la consommation de stupéfiants a été profondément modifié. Aujourd’hui, la plupart des interpellations pour usage de stupéfiants sont traitées sans procédure pénale, par une AFD (76 % en 2024 versus 26 % en 2020).
Ce changement procédural est allé de pair avec un changement du profil des personnes interpellées pour usage de stupéfiants : dès lors que l’AFD ne peut théoriquement être appliquée à un mineur, l’effet logique a été une très forte baisse de la part de mineurs parmi les personnes mises en cause, passée de 17 % entre 2016 et 2018 à seulement 4 % en 2024.
En outre, la mise en place de l’amende forfaitaire délictuelle a entraîné une augmentation du nombre des délits « constatés ». Ainsi, dans les départements où le taux de recours à l’AFD est le plus important lorsqu’un « usage illicite de stupéfiants » est constaté (dans plus de 75 % des cas), le nombre global d’infractions d’usage de stupéfiants enregistrées a lui aussi augmenté (+ 161 % entre 2019 et 2024). Cette inflation du contentieux d’usage concerne tous les départements, mais elle est plus marquée dans ceux qui ont systématisé le recours à l’AFD, par exemple les Bouches-du-Rhône, l’Hérault, le Rhône ou encore Paris et la Seine-Saint-Denis.
Les chiffres du ministère de l’intérieur montrent donc que le recours à l’AFD « gonfle » le volume des délits, mais aussi qu’il aggrave les variations territoriales d’application de la loi.
Infraction par nature « révélée par l’activité des services » (c’est-à-dire tributaire de l’attention de forces de l’ordre), la consommation de cannabis et d’autres drogues classées comme stupéfiants est donc confrontée à un regain de punitivité. La généralisation de l’AFD participe à la dynamique de « re-pénalisation » décrite par le sociologue Henri Bergeron, dans le sens où la consommation « simple », qui reste un délit en France, est, en pratique, plus souvent sanctionnée.
En outre, parce que l’AFD est inscrite au casier judiciaire (bulletins n°1 et 2), toute nouvelle infraction d’usage de stupéfiants alimente de façon « mécanique » le taux de récidive en France.
Premier bilan de mise en œuvre
Un premier bilan fait d’abord apparaître, sur un plan strictement comptable, le faible taux de recouvrement des AFD, ce qui relativise l’argument d’une meilleure effectivité de la réponse pénale.
Après six ans de mise en œuvre, les impayés restent très nombreux : entre 2020 et 2024, à peine un tiers des AFD pour « usage illicite de stupéfiants » étaient effectivement payées (35 %), encore moins l’année suivante : 24 % en 2025, soit un taux de recouvrement deux fois inférieur à celui des amendes pénales en matière de délits routiers.
L’augmentation du montant de l’AFD par la loi Ripost de 2026, qui la porte de 200 euros à 500 euros pour l’usage de stupéfiants (majorée à 1 000 euros en cas de paiement tardif, contre 450 euros auparavant), redouble les interrogations quant aux risques de non-recouvrement.
Par ailleurs, les conditions de mise en œuvre de l’AFD s’avèrent controversées :
taux d’irrégularités constatées multiplié par 49 entre 2020 et 2024 pour l’usage de stupéfiants (incluant des erreurs ou des incohérences dans le procès-verbal, le non-respect du périmètre des AFD, etc.), selon la Cour des comptes ;
constatations de non-conformité dans les règles d’emploi de l’AFD, parfois appliquée à des mineurs ou à des réitérants ou verbalisant un même individu pour plusieurs infractions dont au moins une ne peut théoriquement faire l’objet d’une procédure d’AFD ;
difficulté pratique, pour les forces de l’ordre, de distinguer cannabis et CBD (en accès légal dans des boutiques spécialisées), ce qui alimente les contestations ;
inégalités sociales d’application de l’AFD, objectivées par les recherches en sciences sociales : « ciblage » des catégories populaires, problématiques de surendettement de mineurs et de jeunes adultes ayant accumulé un volume important d’amendes compromettant leurs chances d’insertion sociale et professionnelle dès lors que celles-ci sont inscrites au casier judiciaire.
Une réponse pénale plus systématique, mais moins individualisée ?
Si l’AFD contribue à simplifier, à accélérer et à systématiser la réponse pénale aux contentieux de masse, celle-ci est porteuse de certaines ambivalences :
craintes d’atteintes aux droits des justiciables exprimées lors de divers débats parlementaires et par la Défenseure des droits (respect du principe du contradictoire, droit au respect de la présomption d’innocence, principe de l’individualisation des peines, etc.), l’AFD étant même taxée de « recul des droits pour les justiciables » par la Commission nationale consultative des droits de l’homme ;
critiques à l’égard d’une « pénalisation automatique » qui s’apparente selon certains syndicats professionnels à une « condamnation correctionnelle non individualisée, sans contact humain, sans recours effectif à un juge et sans accès aux droits de la défense » (Syndicat de la magistrature, Syndicat des avocats de France, CGT Intérieur Police) ;
récriminations des professionnels du soin en addictologie à l’égard d’une mesure contribuant à effacer le principe d’individualisation des sanctions et la possibilité d’une orientation pénale vers les soins pour des usagers dépendants. Dans ce sens, l’AFD s’éloigne de l’esprit de la loi du 31 décembre 1970, cadre fondateur de la politique française de lutte contre les stupéfiants, qui prévoyait un équilibre entre sanction et soins dans le traitement pénal des « simples » consommateurs de stupéfiants (à l’exclusion de tout autre délit).
Par-delà ces contestations, le développement de l’amende forfaitaire délictuelle
– tant sa rapide montée en charge que les modalités de sa mise en œuvre – s’inscrit dans la continuité de deux processus documentés par les travaux de recherche depuis les années 2000 : la déjudiciarisation des contentieux dits « de masse » du fait de la standardisation des procédures de sanction hors du contrôle d’un magistrat au nom d’une meilleure « gestion des flux » dans la filière pénale, d’une part ; l’accroissement des logiques de pénalisation financière des infractions les plus courantes, d’autre part.

Ivana Obradovic a reçu, pour le compte de l'OFDT, des financements de la CNAM (Fonds de lutte contre les addictions) et de la MILDECA (subvention pour charge de service public).
06.10.2026 à 15:54
Brésil : le monde ancien est mort, et le nouveau ne peut pas naître
Guilherme Casarões, Associate Professor of Brazilian Studies, Florida International University
Texte intégral (2856 mots)
L’ESSENTIEL
Flavio Bolsonaro a devancé Lula à l’issue du premier tour de la présidentielle brésilienne. Le leader de la gauche aura du mal à inverser la tendance au second tour.
Une défaite de Lula planterait le dernier clou dans le cercueil de la Nouvelle République, ce système instauré au milieu des années 1980 après la fin de la dictature militaire.
Flavio Bolsonaro, s’il est élu, appliquerait un programme totalement opposé à celui de son prédécesseur, sur le plan intérieur comme sur le plan international, où il se positionne comme un allié fidèle de Donald Trump.
Le dimanche 4 octobre 2026, en plaçant Flavio Bolsonaro en tête au premier tour de l’élection présidentielle, les Brésiliens n’ont pas seulement infligé un camouflet au président sortant Luiz Inácio Lula da Silva. Ils ont, de fait, planté le dernier clou dans le cercueil d’un projet politique qui, depuis près d’une décennie, ne survivait plus que sous perfusion : celui de la Nova República, la « Nouvelle République », née au milieu des années 1980, sur les ruines de vingt et un ans de dictature militaire, avant d’être consacrée par la Constitution de 1988. Pendant une génération, les Brésiliens l’ont considérée comme un pacte démocratique fondé sur trois engagements.
Le premier était social. La Nouvelle République faisait du pluralisme un principe et de la diversité de la population une composante de l’identité nationale plutôt qu’un problème à gérer.
Le deuxième était institutionnel. Dans un système multipartite fragmenté, personne ne peut gouverner seul : le consensus était donc le moteur de l’action publique. Ce consensus reposait sur des élections libres et régulières, mais aussi sur des coalitions permettant aux gouvernements fédéral, régionaux et municipaux de mettre en œuvre des politiques communes, ainsi que sur un équilibre fonctionnel entre le président, le Congrès et la Cour suprême.
Le troisième avait trait à la politique de l’État. Celle-ci devait préserver la stabilité économique, réduire les profondes inégalités sociales via la redistribution et élargir la participation des citoyens à la vie publique.
Pendant près de trente ans, jusqu’au milieu des années 2010, le pacte a tenu, tant bien que mal. Ses résultats ont été inégaux, mais bien réels : l’hyperinflation a été maîtrisée, des dizaines de millions de Brésiliens sont sortis de la pauvreté, et les alternances se sont déroulées pacifiquement entre les deux principaux partis de l’époque, à savoir le Parti des travailleurs (PT, gauche) et le Parti social-démocratique (PSDB, droite).
La première offensive
À gauche, beaucoup estiment que la Nouvelle République a commencé à se fissurer avec la destitution de la présidente Dilma Rousseff (PT) en 2016. Selon cette lecture, cette destitution aurait été orchestrée pour préserver les structures élitistes et corrompues que le nouveau pacte n’était pas parvenu à réformer.
Mais c’est surtout la victoire à l’élection de 2018 de Jair Bolsonaro, alors à la tête du Parti socia-libéral (parti centriste qu’il oriente vers la droite radicale) qui a constitué une offensive frontale contre chacun des engagements démocratiques du Brésil. Bolsonaro s’était alors présenté comme un outsider, alors qu’il avait passé vingt-huit ans au Congrès brésilien. Il a placé le nationalisme chrétien au cœur de son projet, aux dépens du pluralisme ; il a présenté la recherche du consensus comme une forme de corruption des élites et les coalitions qui avaient permis au Brésil d’être gouvernable comme la source même de sa décadence ; et il promettait de redresser l’économie en débarrassant les entreprises et les individus des contraintes de l’État, au nom de la liberté.
Bolsonaro n’a pas obtenu les résultats promis. Une fois au pouvoir, il a découvert qu’il devait gouverner dans le cadre du pacte contre lequel il avait fait campagne. Il lui fallait négocier avec le Congrès, respecter les décisions des tribunaux et composer avec des gouverneurs disposant de leurs propres fiefs. Ces contraintes permettent en partie de comprendre pourquoi tant de ses électeurs ont eu le sentiment d’avoir été déçus. Elles expliquent aussi pourquoi, après sa défaite face à Lula en 2022, il a cherché à organiser un coup d’État pour se maintenir au pouvoir, ce qui lui a valu, quelques années plus tard, d’être condamné à vingt-sept ans de prison, une peine qu’il purge actuellement à son domicile pour raisons de santé. Lorsqu’un dirigeant ne parvient pas à plier les règles à sa volonté, il peut finir par penser qu’il doit les briser.
La restauration qui n’a pas eu lieu
Après avoir gouverné le Brésil pendant deux mandats, de 2003 à 2010, Lula est revenu au pouvoir en 2023 en promettant de sauver la démocratie brésilienne. Son troisième mandat est, au contraire, devenu la démonstration la plus éclatante que la Nouvelle République ne pouvait plus être sauvée.
L’équilibre institutionnel qui avait permis au système de tenir s’était évanoui. Le Congrès, qui contrôle désormais une part considérable du budget fédéral à travers les crédits qu’il attribue directement, a pris la présidence en otage, tandis que la Cour suprême a progressivement occupé le vide laissé par le pouvoir politique en intervenant de plus en plus directement dans la production des normes.
Les tentatives de Lula visant à mettre en œuvre son programme se sont heurtées, les unes après les autres, à des blocages. Son bilan économique est honorable, mais son mandat n’a pas transformé la vie des Brésiliens : une croissance correcte et un faible taux de chômage ne se sont pas traduits par une amélioration significative des conditions de vie de la majorité de la population.
La sécurité, qui figure régulièrement parmi les principales préoccupations des électeurs, ne s’est pas améliorée sous Lula. Il faut toutefois rappeler qu’au Brésil, en vertu de la répartition des compétences, l’essentiel des forces de police relève des États fédérés et que le gouvernement fédéral ne peut agir que dans certaines limites. Mais les électeurs ne se préoccupent généralement ni de la lettre ni de l’esprit de la Constitution. Ils veulent des résultats.
Il y a enfin Lula lui-même. À 80 ans et après quatre décennies de vie publique, il était devenu le visage le plus reconnaissable de la Nouvelle République. Cela faisait de lui une cible idéale. Pour de nombreux Brésiliens, leur exaspération à l’égard du système politique s’est matérialisée par un profond rejet de Lula et, pour certains, avec une profonde haine à son endroit.
Le chant du cygne ?
Si la défaite de Lula se confirme au second tour, le 25 octobre, il ne s’agira pas seulement d’une défaite personnelle ou d’un revers pour le Parti des travailleurs, qui a gouverné le Brésil pendant près de dix-huit des vingt-quatre dernières années. Ce sera le chant du cygne d’un projet politique qui promettait de reconstruire un pays sur les ruines de l’autoritarisme et qui n’est jamais parvenu à tenir pleinement ses promesses : stabilité politique, prospérité économique et justice sociale.
Tout cela ne signifie pas que les 56 millions de Brésiliens qui ont voté pour Flavio Bolsonaro, l’un des fils de Jair Bolsonaro, rejettent la démocratie. Certains le font. Ils sont nostalgiques d’un passé largement fantasmé : une époque où la classe moyenne était plus forte – et beaucoup moins nombreuse –, où les valeurs familiales chrétiennes étaient dominantes et où l’ordre comptait davantage que l’État de droit.
Mais la véritable leçon du 4 octobre est ailleurs. Des millions de Brésiliens veulent une autre forme de démocratie : moins pluraliste, fondée sur une conception différente de ce que la démocratie doit permettre. Surtout, ils ne croient plus que la Nouvelle République soit capable de répondre aux défis du monde dans lequel ils vivent.
L’ancien monde se meurt
Le philosophe marxiste italien Antonio Gramsci (1891-1937) avait formulé une observation devenue célèbre : une crise survient lorsque « l’ancien monde se meurt et que le nouveau ne parvient pas à naître ». Le Brésil se trouve aujourd’hui à ce carrefour.
Contrairement à son père, Flavio Bolsonaro accéderait au pouvoir en bénéficiant d’un alignement exceptionnel des forces politiques. Les résultats des législatives tenues ce dimanche simultanément avec la présidentielle laissent penser que ses alliés détiendront près d’un quart des sièges de la Chambre des députés, la chambre basse du Congrès brésilien, et du Sénat : une base solide dans un Congrès où les coalitions s’achètent davantage qu’elles ne se construisent. Il pourrait également nommer quatre des onze juges de la Cour suprême au cours de son mandat.
Jair Bolsonaro a passé quatre ans à combattre les institutions. Son fils pourrait avoir les moyens de les remodeler.
Pour autant, Flávio n’incarne pas ce « nouveau monde » que Gramsci attendait. C’est un professionnel de la politique, visé par plusieurs accusations de corruption, et l’héritier d’une dynastie familiale. Il représente davantage la continuité de la réaction politique de la dernière décennie qu’une véritable rupture avec celle-ci.
S’y ajoute la volonté de Flávio de devenir l’allié privilégié de Donald Trump en Amérique du Sud.
Le Brésil pourrait ainsi consentir d’importantes concessions aux États-Unis dans les années à venir, en renonçant à une partie de ses richesses
– pétrole ou terres rares, par exemple – afin d’obtenir une place privilégiée dans le nouvel ordre continental promu par Washington. Reste à savoir ce que ce rang de premier allié de la Maison-Blanche signifierait réellement. Et les événements récents dans la région laissent à penser que ce statut n’aurait rien de particulièrement honorable.
Quoi qu’il en soit, la victoire de Flavio Bolsonaro bouleverserait le paysage politique brésilien. Les Brésiliens qui s’opposent à son programme – qu’ils soient de gauche, du centre ou de la droite démocratique – ne pourront plus compter sur l’ancien pacte pour les protéger ou leur permettre de revenir au pouvoir et devront apprendre à évoluer dans ce nouveau jeu, sur le plan intérieur comme sur la scène internationale.
La Nouvelle République appartient au passé. La question qui se pose désormais au Brésil – et à tous ceux qui ont observé le pays comme un révélateur de l’état de la démocratie dans le Sud global – est de savoir ce qui la remplacera, et si les nouvelles règles permettront enfin au Brésil d’entrer dans l’avenir.
Si les Brésiliens ne veulent pas que cet avenir ressemble à un passé sombre et lointain, ils doivent comprendre que le combat n’est pas terminé.

Guilherme Casarões ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 15:53
Les sociétés militaires privées en Amérique latine : de la fin de la guerre froide à Vectus Global
Valère Llobet, Doctorant en Science Politique, Université Grenoble Alpes (UGA)
Texte intégral (2489 mots)
L’ESSENTIEL
Les sociétés militaires privées (SMP) états-uniennes disposent d’un ancrage ancien en Amérique latine, où elles sont notamment impliquées dans la lutte contre le narcotrafic, dans la protection d’infrastructures et dans la formation des forces locales.
Le rôle central d’Erik Prince, ancien patron de la tristement célèbre Blackwater, aujourd’hui à la tête d’une nouvelle SMP nommée Vectus Global, illustre le retour en force de ces SMP dans la région.
La compétition entre les grandes puissances en Amérique latine se manifeste aussi dans ce domaine : la Chine investit progressivement le marché tandis que la présence russe, elle, semble reculer.
Avec le retour à la présidence des États-Unis de Donald Trump, un nom est réapparu sur la scène internationale : celui de l’un de ses fervents soutiens, Erik Prince. Figure emblématique des sociétés militaires privées (SMP) depuis la création de Blackwater, renommée Xᵉ en 2009 et Academi en 2011, puis revendue à Constellis Group, Prince poursuit depuis les guerres d’Afghanistan (2001) et d’Irak (2003) ses activités dans le secteur de la guerre privée. Il est notamment revenu sur le devant de la scène en Amérique latine avec sa nouvelle société, Vectus Global.
Les États-Unis ne sont toutefois plus les seuls à s’intéresser à ce marché. La Russie et, surtout, la Chine cherchent elles aussi à y développer leurs propres entreprises de sécurité.
Les SMP anglo-saxonnes, une présence ancienne
La situation sécuritaire délétère dans de nombreux pays latino-américains et la lutte contre les cartels et les gangs offrent depuis longtemps d’importants débouchés aux SMP américaines et, plus largement, anglo-saxonnes. Leurs activités répondent avant tout aux besoins liés à la lutte contre le narcotrafic et le crime organisé, mais aussi à la protection des investissements et des personnels étrangers. Sur place, elles proposent notamment des services de conseil, de formation et de vente d’armes.
Cette implantation remonte au moins aux années 1990. La société américaine DynCorp, présente en Colombie dès 1998, a notamment participé au « Plan Colombie », lancé sous la présidence de Bill Clinton pour lutter contre le trafic de drogue et renforcer la sécurité du pays. Elle a pris part à des actions antidrogue, notamment à l’épandage d’herbicides comme le glyphosate, mais aussi à la protection d’infrastructures et de personnels, ainsi qu’à des opérations armées. Ces activités ont suscité de nombreuses controverses, notamment en raison de leurs conséquences environnementales et sanitaires dans les pays limitrophes.
En Colombie, des entreprises états-uniennes ont également assuré des missions de renseignement aérien pour le compte des autorités de Washington. Certaines opérations ont été lourdement mises en cause : en 1998, des renseignements fournis par la société Airscan auraient notamment contribué au bombardement d’un village civil par l’armée de l’air colombienne. Dans ce pays, les SMP ont également profité de la présence de groupes rebelles comme les FARC. Une filiale d’ArmorGroup, Defense Systems Colombia, employait plusieurs centaines de personnes, principalement d’anciens militaires, pour assurer notamment la protection d’installations pétrolières, dont certaines appartenant à British Petroleum. Elle a par ailleurs été accusée d’implication dans de graves violations des droits humains.
À la même période, on retrouve dans la région d’autres SMP implantées dans le secteur de la formation militaire. Citons, au Pérou, les entreprises Gun Supply et Triple Canopy qui ont « offert leurs services » en matière de formation au sein d’installations militaires appartenant à Lima. Ou encore les groupes Your Solution Inc. et à nouveau Triple Canopy qui ont utilisé des installations gouvernementales au Honduras pour y former des combattants honduriens, chiliens, nicaraguayens et salvadoriens.
Cette longue coopération a aussi contribué à renforcer les compétences des forces gouvernementales latino-américaines, tout en facilitant ensuite le passage de certains militaires dans le secteur privé, notamment au sein de SMP étrangères.
Vectus Global, le retour d’Erik Prince
Depuis le retour de Donald Trump à la Maison-Blanche, l’activité d’Erik Prince et de son entreprise Vectus Global, semble connaître un nouvel essor. Il est notamment intervenu en République démocratique du Congo et, en ce qui concerne l’Amérique latine, en Équateur, au Salvador, au Pérou et en Haïti.
En Équateur, Prince a participé en 2025 aux efforts de lutte contre la criminalité aux côtés des autorités locales. Les détails des contrats restent peu documentés, mais ses activités auraient porté sur la formation et le conseil aux forces équatoriennes ainsi que sur la lutte contre l’exploitation minière illégale, le trafic de drogue et le crime organisé. Prince aurait également promis de fournir les « outils, tactiques et informations » nécessaires pour combattre les trafiquants de drogue.
Prince s’est également rapproché du président salvadorien Nayib Bukele, qu’il a rencontré à plusieurs reprises, et aurait proposé ses services au Pérou en 2025. Par ailleurs, il se serait également intéressé au Venezuela, en apportant un soutien plus ou moins direct à des opposants au régime de Caracas.
C’est surtout en Haïti que Vectus Global aurait développé une présence importante. Depuis début 2025, elle y serait chargée de contribuer à la lutte contre les gangs, mais aussi de reprendre le contrôle de certains axes routiers et de rétablir la collecte des impôts et des taxes. Le groupe aurait déployé entre 150 et 200 hommes, accompagnés de spécialistes du renseignement et des communications, ainsi que d’hélicoptères, de navires et de drones.
Ces derniers auraient été utilisés dans des opérations offensives menées conjointement avec les autorités haïtiennes. En janvier 2026, une opération aurait notamment visé le groupe criminel G9 et son chef Jimmy Chérizier, dit « Barbecue ».
Au total, entre le 1er mars 2025 et le 21 janvier 2026, 1 243 personnes, parmi lesquelles des civils, auraient été tuées et 738 blessées par des frappes de drones. Ces dernières ont été réalisées lors de 141 interventions attribuées aux autorités haïtiennes qui auraient opéré, tout ou partie, avec le soutien de Vectus Global.
Soulignons également que les SMP anglo-saxonnes ne se limitent pas aux opérations anticriminalité. Des entreprises comme MWM Inc. et Acri Defense développent par exemple des activités liées à la surveillance pénitentiaire et à la gestion des migrants à la frontière entre les États-Unis et le Mexique.
À lire aussi : Au Mexique, le pouvoir criminalise les défenseurs des migrants
La Russie : une présence limitée
La présence russe en Amérique latine est beaucoup plus réduite. Les SMP de Moscou ont obtenu quelques contrats, principalement auprès des alliés de la Russie, sans parvenir à s’implanter durablement.
En 2019, environ 400 membres de Wagner auraient ainsi été envoyés au Venezuela pour protéger Nicolás Maduro pendant la crise politique qui secouait le pays. Cette présence intervenait alors que des groupes armés vénézuéliens soutenus par la SMP américaine Silvercorp tentaient, avec l’opération Gideon, de renverser le gouvernement.
Fin 2021, une autre société russe, Vega Strategic Services, aurait mené des missions de formation auprès des forces vénézuéliennes. En somme, l’implantation des acteurs privés russes se limite des alliés de la Russie dans la région, mais il semblerait que depuis février 2022 et la reprise en main des structures militaires privées russes après la rébellion de Wagner en juin 2023, l’activité de ces sociétés dans la région semble s’être fortement réduite.
La Chine avance à couvert
La stratégie chinoise est différente. Elle accompagne l’expansion économique de Pékin en Amérique latine, notamment dans le cadre des Nouvelles Routes de la soie. La construction d’infrastructures stratégiques, comme le méga-port de Chancay au Pérou, crée de nouveaux besoins en matière de protection des investissements, des installations et des ressortissants chinois.
Des entreprises de sécurité chinoises sont ainsi présentes en Argentine, en Uruguay, au Venezuela, au Panama, au Salvador, au Costa Rica et au Pérou. Parmi elles figurent China Overseas Security Group, Beijing Dujie Security Technology Company, ZhongBao Hua’an Security Service ou encore China Security Technology Group, actif notamment dans le secteur minier.
Au Mexique, le « Conseil de sécurité mexicano-chinois », fondé par Feng Chengkang, ancien cadre du gouvernement de la RPC, assurerait pour sa part la protection d’hommes d’affaires chinois contre les gangs. Cette présence s’inscrit dans un marché de la sécurité privée particulièrement dynamique : entre 2012 et 2018, celui-ci aurait augmenté de 180 % pour atteindre 1,5 milliard de dollars.
L’Amérique latine constitue aujourd’hui l’une des cinq grandes zones d’intervention des SMP chinoises, avec l’Asie centrale, le Moyen-Orient, l’Afrique et l’Asie du Sud-Est continentale. Leur implantation y demeure toutefois plus récente et moins développée qu’ailleurs. Elle bénéficie du rapprochement politique et militaire entre Pékin et plusieurs gouvernements de la région, notamment à travers la fourniture d’équipements et la formation d’officiers latino-américains en Chine, notamment en République dominicaine.
Une concurrence internationale ancienne
La présence de SMP étrangères en Amérique latine n’est pas une nouveauté. Avant les entreprises russes et chinoises, des sociétés israéliennes s’étaient déjà implantées dans la région. À la fin des années 1980, la société Spearhead Ltd, dirigée par Yaïr Klein, avait fourni des armes et formé en Colombie des groupes paramilitaires ainsi que des hommes liés au narcotrafic, notamment au cartel de Medellín.
Au début des années 2000 l’entreprise Global CST, fondée par d’anciens responsables militaires et du renseignement israéliens, a notamment opéré au Pérou et en Colombie. Dans ce dernier pays, elle prodiguait notamment ses services dans le domaine de la formation à destination des unités d’intervention locales.
Le recours à des SMP étrangères présente pour les États latino-américains un intérêt évident : elles disposent souvent d’une expertise et de moyens supérieurs à ceux des sociétés locales, tout en étant moins susceptibles d’être liées aux organisations criminelles ou des gangs.
L’Amérique latine constitue ainsi un marché de plus en plus disputé. Les SMP américaines, qui y disposent d’un réseau ancien et étendu, accompagnent le durcissement de la politique de Washington contre le narcotrafic et le crime organisé. Les entreprises chinoises progressent parallèlement au développement des investissements et des infrastructures de Pékin, notamment pour protéger ses intérêts et ses ressortissants. La Russie, en revanche, paraît avoir vu sa présence fortement se réduire depuis le début de la guerre en Ukraine et surtout depuis la tentative de rébellion du groupe Wagner en juin 2023 qui a réduit leur marge de manœuvre.

Valère Llobet ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 15:52
Comprendre la crise de la « valeur travail » à travers les yeux de policiers, des informaticiens et des ouvriers
Marc Loriol, Directeur de recherche CNRS, sociologue, Université Paris 1 Panthéon-Sorbonne
Texte intégral (1809 mots)
L’ESSENTIEL
La crise de la « valeur travail » traduit une individualisation du sens donné au travail depuis les années 1950.
Pour comprendre ces évolutions, trois groupes professionnels ont été examinés à la loupe : ouvriers, policiers et informaticiens.
La financiarisation et la managérisation de l’économie française redéfinit le sens du mot travail. Pour quel avenir ?
À un an de l’élection présidentielle, le travail s’impose comme l’un des thèmes majeurs du débat public. À gauche, les discussions portent essentiellement sur les conditions de travail, la quête de sens et la reconnaissance professionnelle. À droite et au centre, le diagnostic est différent : les Français auraient perdu le goût du travail. Bruno Retailleau propose « d’instaurer la priorité travail », tandis que Gabriel Attal affirme que « le rapport au travail est l’une des questions les plus centrales ». Jean-Luc Mélenchon, dans un discours prononcé à Saint-Denis, estime que le rapport au travail a changé depuis 1958.
Mais le rapport au travail a-t-il réellement changé ? Peut-on parler d’un affaiblissement de la « valeur travail » ? Et pourquoi la question du sens du travail semble-t-elle aujourd’hui occuper une place aussi importante ?
Afin de comprendre les évolutions du rapport au travail depuis les années 1950, dans mon dernier livre, j’ai croisé les résultats d’enquêtes statistiques avec plus de 400 témoignages et récits de vie. Cette démarche a porté sur de nombreux secteurs d’activité, avec une attention particulière à trois groupes professionnels dans cet article : ouvriers, policiers et informaticiens.
Rapport au travail
Le rapport au travail comporte plusieurs dimensions étroitement imbriquées, loin d’être une simple affaire de personnalité ou de valeurs individuelles.
Il renvoie à l’importance d’un revenu. Une stabilité permet de construire des projets de vie : se loger, fonder une famille, financer sa consommation ou ses loisirs. Il participe à la construction de l’identité sociale et professionnelle. À ce titre, il est indissociable d’un métier, à savoir la possibilité de s’identifier à un groupe professionnel reconnu et valorisé. La plupart des salariés cherchent à trouver de l’intérêt dans leur travail, à lui attribuer une utilité sociale ou à y puiser une forme d’accomplissement personnel.
Ce rapport au travail se construit tout au long de son existence. Les socialisations familiales, les expériences professionnelles successives, la transmission – ou l’absence de transmission – des savoir-faire et des règles du métier, ainsi que les perspectives d’évolution professionnelle contribuent à façonner la manière dont chacun perçoit son travail.
Une réalité ambivalente
Cette complexité explique les résultats parfois paradoxaux des enquêtes sur la question du rapport au travail.
Une même personne peut déclarer aimer son métier, tout en critiquant ses conditions d’exercice et en souhaitant que ses enfants choisissent une autre voie professionnelle. De même, lorsqu’un salarié répond que le travail occupe une place importante dans sa vie, cette affirmation peut recouvrir des significations différentes. Elle peut traduire un investissement personnel dans l’activité exercée, mais aussi renvoyer à la nécessité de disposer d’un emploi pour gagner sa vie et conserver une place dans la société.
L’ambivalence du rapport au travail, entre satisfaction et rejet, ne peut se comprendre qu’avec des situations concrètes. C’est pourquoi je vous propose de découvrir le rapport au travail des ouvriers, des policiers, des infirmiers et des informaticiens.
Les ouvriers : améliorer le niveau de vie
Avant de parler du rapport au travail aujourd’hui, penchons-nous sur le passé. L’idée selon laquelle les travailleurs des années 1950 et 1960 auraient accordé une place centrale au travail mérite d’être nuancée, notamment pour les ouvriers.
Dans une étude réalisée en 1959, les personnes interrogées devaient choisir quelle activité leur procure « le maximum de satisfaction » parmi le travail, la famille et les loisirs. Seuls 25 % des ouvriers spécialisés et 15 % des ouvriers qualifiés plaçaient le travail en tête, loin derrière la famille et même les loisirs.
À lire aussi : Le « beau travail », une revendication ouvrière trop souvent oubliée
Les témoignages confirment cette tendance. Une ancienne ouvrière bobineuse, qui renonçait à son envie de faire des études pour aider financièrement sa famille, déclare que quand elle était jeune, en 1963, elle avait « amusement et travaillement au programme ». Si l’on travaille beaucoup durant les Trente Glorieuses, c’est souvent pour améliorer un niveau de vie encore modeste et accéder à la société de consommation en plein essor.
Les policiers : idéal du travail bien fait
Dans les années 1950 et 1960, de nombreux gardiens de la paix sont issus du monde ouvrier. Entrés dans la police pour échapper à l’usine, au chômage ou, pour certains, au service du travail obligatoire (STO), ils importent dans leur nouveau métier une culture professionnelle marquée par l’idéal du travail bien fait et la défense collective des intérêts du groupe.
Dans cette perspective, exercer correctement son métier consiste avant tout à maintenir la tranquillité publique, en privilégiant la prévention plutôt que la répression. Cette culture est transmise sur le terrain, des anciens aux nouvelles recrues.
À partir des années 1970, plusieurs évolutions viennent fragiliser ce modèle : accroissement des mobilités, politisation croissante des enjeux de sécurité, élévation du niveau de diplôme des recrues et, plus récemment, développement des logiques de performance et de « politique du chiffre ». Les policiers éprouvent davantage de difficultés à construire collectivement le sens de leur activité.
La transmission du métier ne se fait plus suffisamment : « la sagesse de l’ancien doit être prise en compte dans beaucoup de situations difficiles, pour éviter ce côté impulsif, calmer un peu ses ardeurs et temporiser », déplore un gardien de la paix de 35 ans interrogé en 2003. Les entretiens menés en 2018 par Marc Nino dévoilent des policiers encore plus isolés, avec des positions pas toujours conciliables, face aux difficultés de leur métier.
De même, l’étude à dix ans d’intervalle (2007-2017) d’un même commissariat par la chercheuse Élodie Lemaire révèle un recul du soutien collectif entre collègues face à une politique du chiffre et une individualisation des carrières qui freinent la coopération.
Les informaticiens : férus d’innovation technologique
Les récits de vie d’informaticiens montrent combien le sens du travail est lié au partage d’un intérêt commun pour la technique. Une ancienne informaticienne qui a travaillé dans la sécurité informatique explique :
« C’était un service hypertechnique avec des gens qui voulaient vraiment travailler dans la technique, donc c’était vraiment très chouette. C’est quelque chose qui galope toujours, parce que la technologie avance en permanence. »
Cet informaticien retraité se souvient de son premier emploi :
« J’ai débarqué dans ce monde, et c’était super sympa parce qu’il y avait plein de jeunes qui venaient de partout, il y avait tous les domaines, et ça rigolait pas mal, ça bossait bien. »
Les témoignages des professionnels nés avant 1970 décrivent tous une transformation profonde de leur environnement de travail au cours des années 1990 et 2000. À la suite de rachats, de privatisations ou de fortes croissances d’entreprise, ils observent l’émergence de managers davantage centrés sur la gestion et leur plan de carrière que sur la maîtrise technique.
« Nous avons eu un défilé de gens, on les appelait des ingénieurs Excel. Ils arrivent avec leurs uniformes pour t’expliquer comment tu dois bosser », explique cet ancien spécialiste d’informatique industrielle.
Cette évolution accroît la distance entre ceux qui conçoivent et réalisent le travail et ceux qui l’organisent.
Une transformation plus qu’un déclin
Le slogan de Mai 68 « ne pas perdre sa vie à la gagner » aurait sans doute trouvé un écho aussi bien dans les années 1950 qu’au lendemain de la pandémie de Covid-19. Il témoigne d’interrogations récurrentes – voire métaphysique – sur la place du travail dans notre existence.
Ce qui apparaît plus spécifiquement depuis les années 1990-2000 n’est pas tant un recul de l’attachement au travail qu’une transformation de ses fondements. Sous l’effet de la financiarisation de l’économie et des processus de rationalisation, les organisations ont connu une division accrue du travail, une personnalisation des carrières et une distanciation croissante entre producteurs, gens de métier, et gestionnaires, managers désincarnés.
Dans ce contexte, les questions d’utilité sociale, d’éthique professionnelle et de cohérence avec ses valeurs personnelles se posent avec une acuité croissante. Plus qu’une crise de la « valeur travail », les évolutions contemporaines semblent traduire une individualisation du sens donné au travail.

Marc Loriol ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 15:51
Mechanical Turk, la plateforme qui cachait des humains, tire sa révérence
Sophie Renault, Professeur des Universités en Sciences de Gestion et du Management, Université d’Orléans
Texte intégral (1949 mots)

L’ESSENTIEL
La plateforme de microtâches Amazon Mechanical Turk a fermé dans une relative discrétion. Elle était utilisée notamment par les chercheurs pour mener des expérimentations en ligne.
Que dit cette fermeture de l’évolution du modèle économique d’Amazon ? Comment l’interpréter en pleine vague de l’IA ?
C’est tout un pan du travail humain rendu invisible qui disparaît complètement. Qui se souviendra qu’aux débuts du numérique il fallait des hommes et des femmes pour faire « tourner » les machines ?
« On évalue régulièrement nos programmes, nos outils et nos services, et on apporte des ajustements en fonction de ces évaluations. À la suite d’une telle évaluation, on a pris la décision de fermer Amazon Mechanical Turk à compter du 30 septembre 2026. »
C’est en ces termes laconiques qu’Amazon a annoncé, fin août 2026, la fermeture de Mechanical Turk (MTurk), la plateforme de crowdsourcing (ou production participative) de microtâches qu’elle avait lancée en 2005, l’accès aux nouveaux clients ayant déjà été coupé depuis juillet.
Vingt et un ans après sa création, ce service que Jeff Bezos qualifiait d’« intelligence artificielle artificielle » disparaît ainsi dans une relative discrétion, sans raison officielle détaillée au-delà de cette formule prudente. Derrière elle se cache pourtant un basculement révélateur. Il semble en effet que la plateforme, qui a longtemps fourni la main-d’œuvre humaine invisible derrière l’intelligence artificielle, soit aujourd’hui rendue obsolète par cette même intelligence artificielle.
L’humain caché dans la machine
Le nom choisi par Amazon en 2005 pour sa plateforme de microtravail n’a rien d’anodin. Il rend hommage, avec une ironie assumée, au « Turc mécanique ».
Il s’agit d’un automate joueur d’échecs conçu en 1770 par l’ingénieur autrichien Wolfgang von Kempelen pour la cour de l’impératrice Marie-Thérèse d’Autriche. Présenté comme une machine capable de battre aux échecs de solides adversaires, l’automate a affronté de prestigieux joueurs comme Benjamin Franklin ou Napoléon Bonaparte. En réalité un joueur humain était dissimulé dans son socle, actionnant bras et pièces au moyen d’un système de leviers.
À lire aussi : Plus ubérisé qu’Uber ? Le microtravail numérique dans l’angle mort du droit
La supercherie ne fut pleinement révélée qu’après la destruction de la machine dans un incendie, à Philadelphie, en 1854. En reprenant ce nom pour sa plateforme de microtâches, Amazon assumait donc le fait de faire passer pour la performance d’une machine ce qui reste, en coulisses, un travail humain. Cette ironie a été largement commentée depuis par les chercheurs en études du travail numérique.
Une « intelligence artificielle artificielle »
À son lancement, MTurk répondait à un problème très concret. En effet, certaines tâches, triviales pour un humain, restaient hors de portée des machines. Il s’agissait, par exemple, d’identifier un objet sur une photo, de transcrire un audio, de juger du caractère positif ou négatif d’un commentaire déposé sur un site marchand, etc. Jeff Bezos avait résumé le concept d’une formule restée célèbre : une « intelligence artificielle artificielle », c’est-à-dire des humains rémunérés à la tâche pour simuler, en coulisses, les capacités que les algorithmes n’avaient pas encore.
Des centaines de milliers de « Turkers », répartis dans le monde entier, ont bâti autour de la plateforme une économie parallèle faite de micro-paiements et de communautés d’entraide en ligne.
Déjà utilisé pour l’annotation d’images depuis la fin des années 2000, MTurk connaît un regain d’intérêt à partir de 2018, quand Amazon Web Services (AWS, la division cloud d’Amazon) en fait l’une des sources de main-d’œuvre d’Amazon SageMaker Ground Truth, son service d’annotation de données pour l’apprentissage automatique. Les tâches confiées aux Turkers évoluent en conséquence, puis s’étendent avec l’avènement de l’intelligence artificielle (IA) générative : validation de réponses de chatbots, évaluation de modèles de langage…
Au-delà de son usage commercial, la plateforme a aussi occupé une place singulière dans la recherche académique. Elle est rapidement devenue une source privilégiée de participants pour les expérimentations en ligne : coût réduit, rapidité de collecte, diversité démographique bien supérieure aux échantillons traditionnels d’étudiants recrutés sur les campus. Moult articles publiés dans des revues de premier plan reposent, en tout ou partie, sur des données collectées par le biais de MTurk.
Anatomie d’une chute
Depuis plusieurs années, les chercheurs signalaient une dégradation de la qualité des données : bots, fermes à clics, réponses bâclées de travailleurs multipliant les tâches pour maximiser leur gain horaire et surtout un phénomène nouveau à savoir l’usage de l’IA générative par les participants eux-mêmes pour répondre aux enquêtes.
Une recherche intitulée « Artificial Artificial Artificial Intelligence », titre en clin d’œil à la formule de Bezos, estimait qu’entre un tiers et près de la moitié des travailleurs de MTurk y avaient recours pour des tâches de rédaction, interrogeant directement la validité de nombreuses données dites « humaines » collectées ces dernières années. Des plateformes concurrentes, comme Prolific ou CloudResearch, s’étaient déjà imposées dans une partie de la communauté scientifique en réponse à ces limites, en misant sur une vérification plus stricte de l’identité et de l’attention des participants.
Plusieurs facteurs convergent ainsi pour expliquer la fermeture du Turc mécanique d’Amazon. Le premier tient à cette érosion de la confiance dans les données produites par la plateforme, côté entreprises comme côté chercheurs. Le second est concurrentiel. En effet, des acteurs spécialisés dans l’entraînement et l’évaluation de modèles d’IA ont capté une large part des usages que MTurk dominait, avec des dispositifs plus fiables et mieux adaptés aux besoins actuels de l’IA générative.
Le troisième, plus structurel, tient à la transformation du besoin lui-même. En effet, les grands modèles nécessitent désormais moins d’annotation manuelle brute et davantage de retours experts ou de données synthétiques. Or, il s’agit d’un travail que MTurk, conçu pour la tâche massive et peu qualifiée, n’était pas taillé pour fournir. Faute d’investissements, Amazon a laissé la plateforme se scléroser techniquement pendant que l’écosystème évoluait autour d’elle.
Invisibles et pourtant indispensables
Cette disparition met en lumière une question restée irrésolue : celle du statut des travailleurs qui, pendant deux décennies, ont produit la donnée nécessaire à l’entraînement des systèmes d’IA, sans protection sociale comparable à celle d’un salariat classique. Nombre de ces Turkers dépendaient de la plateforme, parfois depuis sa création.
Cette situation illustre, derrière les conditions générales d’utilisation, l’absence persistante de cadre réglementaire consacré au crowdsourcing à l’échelle internationale, alors même que ce travail constitue l’un des fondements invisibles de l’économie de l’IA.
La boucle se referme ainsi sur l’ironie de départ : comme l’automate de Kempelen dissimulait un joueur humain sous des dehors mécaniques, la plateforme d’Amazon dissimulait, sous des dehors algorithmiques, des millions d’heures de travail humain, un travail qui a fini par nourrir les modèles capables, aujourd’hui, de s’en passer.

Sophie Renault ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 15:15
Petite histoire sensorielle de la truffe à l’époque moderne
Anne-Constance Legros, Doctorante contractuelle en histoire moderne, spécialisée dans la botanique des XVIe et XVIIe siècles., Université de Tours
Texte intégral (2568 mots)
L’ESSENTIEL
La truffe nourrit de nombreux discours et alimente nombre de controverses depuis l’Antiquité.
C’est à l’époque moderne, aux XVIᵉ et XVIIᵉ siècles, qu’elle est mise en valeur par les naturalistes, les artistes et les gastronomes.
À travers les sources littéraires et visuelles, il est possible de retracer une histoire sensorielle de la truffe.
La truffe, champignon aromatique, est hypogée – c’est-à-dire qu’elle vit sous terre contrairement aux champignons épigés qui croissent à la surface – et mycorhizienne (le terme vient du grec μύκης (mykēs), champignon et ρίζα (ríza), racine).
Autrement dit, la truffe vit en symbiose avec des racines, le plus souvent celles d’arbres appelés « truffiers ». La fructification, qui est communément dénommée truffe, est composée d’une chair (gléba) marbrée et d’une écorce (péridium) soit verruqueuse, soit lisse.
Dans le sillon de l’histoire des sensibilités représentée par les travaux de Lucien Febvre, d’Alain Corbin et d’Hervé Mazurel, il convient de s’intéresser aux sens mobilisés par les champignons, et plus particulièrement, dans la lignée des recherches de Jean-Louis Flandrin, aux odeurs et saveurs de truffe à l’époque moderne (XVIᵉ-XVIIᵉ siècles).
À travers l’étude des traités de naturalistes, des recettes et des représentations, cet article propose ainsi une approche historique du goût mycologique et de sa perception dans la première modernité.
La grande absente
En 1601, Charles de l’Écluse (1526-1609), dit Clusius publie une importante monographie sur les champignons : Fungorum in Pannoniis observatorum brevis historia. Mais étrangement, il n’y mentionne pas les truffes, singulière au regard de la tradition des savoirs mycologiques. C’est d’autant plus surprenant que Giambattista della Porta (1535-1615), dont Clusius a repris le chapitre sur les champignons dans l’addendum, consacre également un chapitre aux truffes, « De tuberibus », dans ses Villae, un important traité encyclopédique d’agronomie et d’architecture rurale (1592).
Trois hypothèses peuvent être envisagées pour expliquer cette omission. La première, sans doute la moins plausible au regard de l’attention portée par Clusius au legs antique et médiéval, serait celle d’un simple oubli. La deuxième supposerait l’absence de truffes en Pannonie – à cheval sur les actuelles Autriche, Hongrie, Slovénie, Croatie, Serbie et Bosnie-Herzégovine – ce qui expliquerait qu’elles ne soient pas mentionnées dans son étude de la région.
Si une telle absence paraît peu vraisemblable dans cette zone géographique, il reste possible que Clusius et son entourage n’aient pas eu l’occasion d’en observer sur le terrain.
Enfin, la troisième repose sur une distinction entre les Fungi (champignons) et les Tubera (truffes). Clusius les envisagerait comme deux catégories distinctes : une classe de Fungi, subdivisée en deux ordres, esculenti et noxii (comestibles et toxiques), eux-mêmes répartis en genres et en espèces ; et une classe indépendante regroupant les Tubera. Si aucune de ces hypothèses n’est vraiment satisfaisante, ce silence mérite d’être relevé, a fortiori parce qu’il se manifeste également dans son Codex clusii, recueil d’aquarelles mycologiques publié en 1578.
Pourtant, à l’époque de Clusius, les truffes commencent à sortir de l’ombre et à devenir un sujet d’étude à part entière. De la terre au traité, la truffe s’inscrit ainsi progressivement dans les discours médicaux, puis naturalistes, où elle acquiert progressivement le statut d’objet de savoir.
C’est ainsi que Le Libro de componere herbe et frutti, de Giovanni Cademosto de Lodi, composé vers 1460–1500, représente dans la notice des Tartufole, un homme récoltant des truffes, sur le même modèle que les descendants du Tacuinum sanitatis, manuel médiéval très populaire sur la santé.
Cependant, l’illustration ne reproduit pas seulement l’image des truffes, elle glisse également dans le paysage des champignons à stipe, au premier plan. Dans son panier néanmoins, l’homme n’a collecté que des truffes. La présence des champignons dans le paysage et leur absence dans le panier apparaissent comme un véritable mode d’emploi de la cueillette.
Dans cet esprit, le médecin et botaniste italien Pierandrea Mattioli (1501-1577), précise au sujet des truffes dans son Commentaire du médecin grec Dioscoride :
« Les truffes sont communes en Toscane et sont fort desirees des Gentils hommes et grans seigneurs. »
Ainsi, dans le contexte italien toscan, la truffe jouit du statut de mets de premier choix, destiné aux tables nobles.
Une histoire sensorielle
Au XIIIᵉ siècle, le dominicain Albert le Grand considère les truffes comme étant un genre de champignons. Cependant, il les différencie et précise qu’elles se caractérisent par l’absence de goût et/ou de parfum : « et sunt privati sapore omnes tuberes, et in hoc differunt a fungis ». En effet, le terme latin sapor, oris (m.) peut concerner les deux sens, olfactif et gustatif.
Dans le contexte mycologique, il n’est pas impossible qu’il puisse désigner les deux en même temps, à la fois l’odeur particulière du champignon et le goût prononcé de celui-ci. Leur consommation étant considérée par les autorités comme une cause de mélancolie, elles doivent être mangées avec du vin pur
– « vinum purum » – et des épices – « species condientes eos » – pour contrer leurs effets néfastes sur l’eucrasie (c’est-à-dire l’équilibre entre les quatre humeurs du corps : le sang, la phlegme, la bile jaune et la bile noire qui, déséquilibrées, engendrent des maladies, selon les croyances médicales de l’époque).
Il indique cependant que l’ajout de ces assaisonnements ne permet pas aux truffes de devenir plus goûtues, « mais elles restent toutefois inspides » (« sed tamen remanent insipidi »), écrit-il, ce qui est très surprenant, tant la truffe est connue au contraire pour son goût prononcé. Pour reprendre la formule du gastronome français Jean Anthelme Brillat-Savarin, « [q]ui n’a pas senti sa bouche se mouiller en entendant parler de truffes… » (Brillat-Savarin, Éd. 1828, p.203-204) et en imaginant leurs arômes sur notre palais ?
Alfonso Ceccarelli, médecin généalogiste et faussaire italien, publie à Padoue un court traité sur les truffes – Opusculum de tuberibus, 1564 – qui témoigne de l’intérêt renouvelé pour cet objet naturel et ses qualités gustatives à la Renaissance. Dans le chapitre IV sur la variété des truffes, il rapporte l’hypothèse de deux naturalistes qui en recensent quatre espèces. Celles-ci se différencient notamment par leur apparence, leur couleur et par leur goût :
« [Ils] affirment qu’il existe quatre sortes de truffes : certaines sont rousses avec une écorce noire et un goût désagréable ; d’autres sont blanches avec une écorce noire et sans goût ; d’autres encore sont grises avec une écorce noire, plus savoureuses que les autres ; et d’autres enfin sont noires, également avec une écorce noire, et ont un goût aromatique vif, sucré et très savoureux, supérieur aux autres, et sont très recherchées dans les cuisines par les amateurs de bonnes choses. »
Il existerait donc parmi les truffes une hiérarchie des saveurs : elles peuvent être désagréables, insipides, ou développer de vifs arômes. Les espèces de truffes semblent ainsi répertoriées selon leur sapidité, ce qui suggère une plus ou moins grande propension à les consommer. Contrairement à Albert le Grand, certaines variétés de truffes sont considérées comme intéressantes à cuisiner en raison de leurs particularités aromatiques. C’est notamment le cas de la truffe de couleur noire à l’écorce noire, qui désigne sans aucun doute le Tuber melanosporum
– Truffe noire dite du Périgord – dont le goût est jugé meilleur que celui de toutes les autres.
Dans l’édition posthume de De l’Honneste volupté, livre très nécessaire à la vie humaine, pour observer bonne santé… (1571), Platine de Crémone énonce la manière d’apprêter les truffes pour bien les déguster :
« Est bon toutefois (ainsi qu’il dict) de les bouillir premierement en eaue ensemble un roux d’œuf, & nettoyées & plumées les confire en huille doux & inspargir des espices. Autres y a qui les apprestent & lavent premierement avec du vin, & puis les font & laissent cuire soubz les cendres chaudes : & quand sont cuyctes & bien nettoyées les mettent à table toutes chaudes apres la chair inspargies de sel, & de poyvre. Et apres icelles mangées lon doit boire de bon vin… »
S’il mentionne l’usage de sel, de vin et d’épices pour rehausser les saveurs du plat, il ne fait cependant aucune mention du goût caractéristique de la truffe, ni des nuances gustatives propres à ses différentes variétés. En l’absence de toute caractérisation de sa saveur, la truffe semble ainsi perdre la singularité gustative qui lui est par ailleurs attribuée. Pourtant, Ceccarelli estime que la perfection et qualité des truffes – sous-entendu leur sapidité – dépendent de leurs régions et lieux de récolte.
« Que nul ne s’étonne si les truffes récoltées en différents lieux n’offrent pas le même degré de perfection et de qualité, car les végétaux varient et se transforment selon la région et l’emplacement […] Il faut assurément admettre que les racines des plantes acquièrent des saveurs distinctes déterminées par les propriétés du sol, tout comme on l’observe pour les fruits. »
Sous sa plume, l’odeur des truffes se décline en une série de qualificatifs
– plaisante (gratus), parfumée (odorata), aromatique (aromaticum), voire pénétrante (penetratiuum) – tandis que leur goût est décrit plus simplement, comme doux et agréable (dulcia, gustuque suavia). Dans le traité de cuisine « dedié aux Dames Mesnageres » de l’agronome Nicolas de Bonnefons (1654), la puissante senteur des truffes semble même aller jusqu’à susciter l’émotion chez d’aucuns :
« Elles ont une tres-bonne odeur, car si vous les enfermiez dans des Boettes pour les transporter au loing ; à l’ouverture de la Boete leur parfum est si puissant, qu’il tire les larmes des yeux. »
Cependant, davantage que le sens olfactif, c’est le sens gustatif qui revêt la plus grande importance pour l’agronome :
« À cause que de tous les sens, il n’y en a point de plus délicieux, ny de plus necessaire à la vie que celuy du Goust. »
Il suggère en ce sens de « fai[re] secher des Champignons » et de les réduire « en poudre bien fine ». Cette poudre « sera excellente […] pour […] relever le goust au tems [sic : temps] que l’on ne voit point de Champignons ».
Les champignons, y compris la truffe, deviennent ainsi des exhausteurs de goût et d’arômes, facilement conservables sous forme sèche, afin de contrer leur saisonnalité. Cette réflexion synesthésique, qui associe les perceptions olfactives et gustatives à l’expérience sensible, trouve un écho chez Ceccarelli. À la fin de son traité, il rapporte un distique attribué à Laurentius Sacchareus – qui rappelle une épigramme du poète latin Martial (Epigrammata, livre XIII, 50) :
« Nous sommes des fruits nés des entrailles déchirées de la terre ;
Que vous nous humiez ou que vous nous mangiez, nous sommes d’agréables truffes. »
En donnant voix aux truffes dans ces vers, il met en scène l’expérience sensorielle du consommateur, dont l’agrément tient tant à leur fragrance qu’à leurs qualités gustatives.
Les propriétés organoleptiques des truffes, stimulant les sens du goût et de l’odorat, sont connues dès le XVIᵉ siècle. La rareté de cet objet naturel et ses arômes vifs en font un produit alimentaire recherché. Tant est si bien que les truffes se retrouvent comme sujet de composition sous le pinceau du toscan Bartolomeo Bimbi (1648-1729) pour rejoindre le cabinet du grand-duc de Toscane, Côme III de Médicis (1642-1723), à la villa Medicea dell’Ambrogiana.
Comme l’indique le cartouche dans le tableau, cette masse fongique fut découverte en octobre 1706 sur le lieu de production habituel des « Tartufi neri odorosi » (truffes noires parfumées) et présentait « tutte le qualita di vero Tartufo, cioe figura, colore, consistenza, e odore » (« toutes les caractéristiques d’une véritable truffe – à savoir la forme, la couleur, la consistance et l’odeur »). Bien qu’il s’agisse d’une multitude de truffes agglutinées par la terre, ce portrait rigoureux confère à la truffe une certaine noblesse par sa représentation, dont le morceau découpé laisse deviner les effluves au spectateur.
Cet article est publié dans le cadre de la Fête de la science (qui a eu lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Anne-Constance Legros ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
06.10.2026 à 15:14
A camera combined with AI could help further diagnosis of movement disorders like spinal muscular atrophy in newborns
Imen Trabelsi, Chercheuse en intelligence artificielle, École pratique des hautes études (EPHE)
François Jouen, Directeur d'études émérite, École pratique des hautes études (EPHE)
Jean Bergounioux, PUPH chez AP-HP, Assistance Publique - Hôpitaux de Paris, Université de Versailles Saint-Quentin-en-Yvelines (UVSQ) – Université Paris-Saclay
Texte intégral (1541 mots)
Detecting impaired motor function as early as possible after birth with the help of a standard camera linked to intelligent systems can help in diagnosing infantile conditions characterised by hypotonia: reduction or loss of active muscle movement. A research team is investigating this approach based on the work carried out on babies with spinal muscular atrophy (SMA), a rare genetic neuromuscular disorder.
In 2019, the drug Zolgensma made headline news as the world’s most expensive treatment. The price of this medicine for spinal muscular atrophy (SMA) has been set at nearly 2 million euros per injection.
And, at the same time, what an extraordinary breakthrough! It promises to provide a definitive cure for a genetic disease that, if survivors do live, leads to extremely severe disabilities in children affected by what is the world’s first hereditary peripheral neurological disorder.
Behind these staggering figures lies an urgent medical situation. For these therapies to be effective, it is essential to identify the condition as early as possible. This is precisely the challenge our team set out to tackle, by using an ordinary camera coupled with artificial intelligence.
The aim was clear from the outset. Too many delays drastically reduce the effectiveness of the treatment. While the treatment can undeniably prevent neurons from dying, it cannot bring them back to life. Any delay in starting treatment – and, consequently, in diagnosis – represents an unacceptable loss of opportunity for patients.
What is spinal muscular atrophy?
SMA is a rare genetic condition that causes the progressive degeneration of the motor neurons that control muscle function.
In its most severe form – known as type 1 spinal muscular atrophy, infants with the condition rapidly lose the ability to move, sit up and eventually breathe. Without treatment, life expectancy rarely exceeds two years. In France, there is one case in every 6,000 to 10,000 births.
Since the introduction of new treatments, the prognosis has changed dramatically for children treated at a very early stage. Spinal muscular atrophy has, in fact, been included in routine neonatal screening in France since 2025. Not all countries have this screening in place yet. And even where it does exist, a complementary tool for rapid clinical assessment remains highly useful.
Hypotonia refers to a reduction in, or even the complete absence of, active movements. This symptom is non-specific and can be associated with many other childhood conditions, but it remains the first indicator, the one that allows the diagnosis to be raised promptly.
The challenge with clinical diagnosis
Before genetic testing, diagnosis relies on clinical observation. A specialist examines the newborn’s muscle tone and reflexes. The term “hypotonic infant” is often used: the baby appears limp, and their limbs droop without resistance.
However, this assessment is subjective, as it varies from one practitioner to another, and is all too often made at a very late stage, by which time the symptoms have already progressed significantly.
This, then, is the real challenge: the therapeutic window is narrow.
Our approach: motion capture
Our study involved 25 infants hospitalised in paediatric resuscitation units: 5 cases with genetically confirmed SMA and 20 patients with normal neurological results. We used computer vision to analyse infants’ spontaneous movements. The principle is simple: the infant is placed on a plain background, while a conventional camera captures its movements for sixty seconds; an artificial intelligence algorithm then analyses the video footage frame by frame.
In practical terms, this study is based on a 3-step video analysis pipeline, as shown in Figure 1.
The system first reconstructs a “digital skeleton” of the infant based on twelve anatomical joints, eight limb segments, and four movement angles (pose estimations), using a real-time human pose estimation method called Alpha Pose.
From this animated skeleton, hundreds of parameters are calculated (amplitude of gestures, movement limitations (depth), symmetry, frequency…). A total of 108 features were extracted. We then trained a supervised learning algorithm (of the type XGBoost) capable of distinguishing typical motor skills from ‘altered’ motor skills characteristic to spinal muscular atrophy.
Promising results
The results are encouraging: the algorithm correctly classified both groups with an accuracy of 97%.
At the top of the most discriminant parameters, we find the depth of movements or movement limitation; in other words the ability of the infant to move its limbs in space. Babies with SMA show a significant difference in depth-axis motor motion with detection sensitivity greater than 97%. The tool we developed rigorously measures this, turning a visual impression into objective data. What the clinician’s eye intuitively perceives, the algorithm quantifies with precision.
To make the AI outcome relatable, and thus incorporate it in clinical practice, we used a mathematical method called Shapley Additive Explanations (SHAP), which allows you to view the parameters that have been most influential in each algorithm decision.
A tool for other diseases causing hypotonia in infants
Our study was conducted before 2025, at a time when no systematic screening existed in France. Since then, SMA has been integrated into France’s national newborn screening program, which retrospectively confirms the urgency behind our study.
But beyond SMA, many other diseases cause hypotonia in infants without any rapid assessment tool. Our work continues in this direction. While this tool does not set out to replace doctors, in a few minutes it gives practitioners an initial objective pointer to guide their diagnosis without specialised equipment.
Artificial intelligence does not perform miracles, but it renders what is invisible to the naked eye visible. When each week counts for an infant, AI’s contribution to diagnosis becomes valuable.
The Axa science philanthropy is now part of the Axa Foundation for Human Progress, which brings together the commitments of Axa Group and Mutuelles d’Assurances in the fields of Science, Nature, Solidarity, and Culture. Before 2025, the global science philanthropy was held by the Axa Research Fund, which has supported over 750 projects around the world since its inception back in 2007. To learn more, visit Axa Foundation for Human Progress.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Imen Trabelsi received financing from Axa Research Fund.
François Jouen received financing from Axa Research Fund.
Jean Bergounioux received financing from Axa Research Fund.
- GÉNÉRALISTES
- Ballast
- Fakir
- Interstices
- Issues
- Korii
- Lava
- La revue des médias
- Time France
- Mouais
- Multitudes
- Positivr
- Regards
- Slate
- Smolny
- Socialter
- UPMagazine
- Le Zéphyr
- Idées ‧ Politique ‧ A à F
- Accattone
- À Contretemps
- Alter-éditions
- Contre-Attaque
- Contretemps
- CQFD
- Comptoir (Le)
- Déferlante (La)
- Esprit
- Frustration
- Idées ‧ Politique ‧ i à z
- L'Intimiste
- Jef Klak
- Lignes de Crêtes
- NonFiction
- Nouveaux Cahiers du Socialisme
- ✝ Période
- ARTS
- Actualitté
- Autre Quotidien (L')
- Beaux Arts
- Collateral
- Recours au poème
- Villa Albertine
- THINK-TANKS
- Fondation Copernic
- Institut La Boétie
- Institut Rousseau
- TECH
- Dans les algorithmes
- Framablog
- Goodtech.info
- Libre à lire (April)
- Quadrature du Net
- Revue Eur. Médias et Numérique
- INTERNATIONAL
- Alencontre
- Alterinfos
- Gauche.Media
- CETRI
- ESSF
- Inprecor
- Guitinews
- MULTILINGUES
- Kedistan
- Quatrième Internationale
- Viewpoint Magazine
- +972 mag
- PODCASTS
- Arrêt sur Images
- Le Diplo
- LSD
- Thinkerview