24.09.2026 à 07:00
Dans le capitalisme des mots
Hubert Guillaud
Texte intégral (2771 mots)
Dans un article du Monde Diplomatique de novembre 2011, le chercheur Frédéric Kaplan avait introduit la riche notion de « capitalisme linguistique ». Dans un petit livre pour Actes Sud, Dealers de mots, il revisite son concept à l’heure de l’IA générative pour souligner combien la fortune du capitalisme linguistique est plus totale qu’elle ne l’était quand Google inventait son Page rank, son algorithme de classement des résultats de recherche. Parier sur les mots a permis à Google de bâtir son empire et désormais bâtit ceux des producteurs d’IA. La langue est plus que jamais le pouvoir et certains l’accaparent au risque de nous en déposséder.
A l’heure où nous faisons nôtres les mots produits par des machines ou plutôt à l’heure où nous louons à d’autres nos capacités d’expression, l’usage de « prothèses linguistiques » nous exproprie toujours plus de notre propre parole. Tous nos discours ont été accaparés par quelques entreprises se forgeant un capital qu’elles n’ont plus qu’à nous revendre.
Dans son livre, le chercheur raconte l’évolution du capitalisme linguistique comme un roman, avec beaucoup de clarté, d’une manière très accessible. Une histoire que Google s’est longtemps accaparé, la firme transformant le classement des pages par les mots puis réinventant leur modèle économique par la publicité avec Adwords. « Tout ce qui peut être nommé peut donner lieu à une enchère ». Et l’immense capital accumulé par Google provient tout entier de ce marché : celui de la vente des mots. La somme des données linguistiques accumulées est devenue l’un des capitaux moteurs du capitalisme technologique. La plus value désormais consiste à découpler totalement la valeur économique des textes écrits du travail nécessaire pour les produire. C’est-à-dire de les réexploiter sans avoir à les payer : leur donner une nouvelle existence économique pour leur faire produire de nouvelles valeurs encore. Un capitalisme visant à exploiter la connaissance sous toutes ses formes, comme un raffinage nouveau d’une première extraction afin de produire non seulement de la connaissance mais plus encore des machines à connaissance. « Chaque année, Google gagne des centaines de milliards de dollars simplement en organisant la vente des mots à l’échelle planétaire » (493 millions de dollars par jour de chiffre d’affaires en 2020). Kaplan explique que le capital linguistique n’est rien d’autre que la somme des données linguistiques accumulées par un acteur. Ce capital résulte de l’extraction de textes existants et consiste à les accumuler pour les valoriser sous formes de services. Il consiste à capter, « idéalement sans les payer, ces écritures productives de valeur ». Ce nouveau territoire d’exploitation à l’avantage d’être peu balisé et peu réglementé, hormis par la propriété intellectuelle dont il exploite les failles.
Pour Kaplan, le modèle économique de Google ne repose pas tant sur une économie de l’attention, que sur une économie de l’expression, c’est-à-dire d’être un médiateur de l’écrit. Le but est bien plus d’optimiser l’efficacité de l’écrit, d’optimiser l’écriture, d’infléchir les productions à son profit et au profit de ses outils et services. Google nous corrige parce que les mots sont exploitables, à l’image des systèmes d’autocomplétion. Les corrections sont orientées « selon la valeur économique donnée par le marché aux expressions produites ». Nous écrivons via les outils de Google et Google peut exploiter chaque mouvement des productions langagières. Et la vente des mots se faisant sans effort, Google dégage des profits lui permettant de produire des projets sans contrainte de rentabilité.
Google ne fait pas qu’intercepter les flux de discours, il s’est également lancé dans des opérations d’extraction langagière, comme Google Books, qui a permis de numériser plus de 40 millions de livres, rappelle Kaplan, « l’équivalent de 820 millions d’années de travail ». Là, encore, Google a fait grandir son capital épistémique, accumulant « métaphores, personnages, concepts, faits ». Le lancement de ChatGPT en novembre 2022 a produit une nouvelle démonstration de la valeur qui pouvait être extraite de ce capital linguistique, dont la plupart des technologies sous-jacentes ont été produites par les équipes de Google (notamment la technologie Transformer). Le chercheur, rappelle d’ailleurs, avec une grande pédagogie, combien l’invention de cette linguistique plate, statistique, probabiliste, n’est pas autre chose que la continuité de l’approche que Google a appliqué avec Page Rank et Adwords. Désormais, la valeur du capital linguistique repose sur « la longueur cumulée de toutes les séquences de tokens auxquelles un acteur à un accès exclusif », car c’est ce capital même qui va permettre d’ajuster les paramètres des systèmes d’IA, de les ajuster depuis « la table de mixage du Transformer ». Dans cette reconfiguration, « seules comptent les performances de calcul des réseaux et la taille des données d’entraînement ». La performance des systèmes n’est qu’une question de puissance, de volume, d’argent. La puissance, la force brute, les volumes d’investissements… sont devenus les seuls enjeux et consistent à prendre le contrôle d’un marché depuis des logiques de pertes assumées.
OpenAI ne disposait pourtant pas du capital linguistique de Google. Pour résoudre cette difficulté, il a fait ce que Google avait fait avant lui : moissonner l’ensemble du web, comme l’a montré l’enquête du Washington Post. Dans ce moissonnage, tout l’enjeu est de qualifier les données pour donner plus de poids à certains contenus plutôt qu’à d’autres, notamment aux contenus issus de la presse. Dans la course au capital linguistique, désormais, les acteurs tentent de trouver des ressources exclusives permettant d’affiner leurs modèles pour produire d’innombrables « simulateurs de discours ». Mais plus encore désormais les différences tiennent bien plus dans les paramètrages, les phases d’entraînement et de renforcement. Pour Kaplan, les guerres du capitalisme linguistique risquent surtout de refermer les projets d’ouverture de la science. « Si le capital linguistique devient une ressource précieuse, liée à une forme de souveraineté linguistique nationale, il peut paraître irresponsable de l’offrir librement à n’importe quel acteur. Les grandes entreprises de l’intelligence artificielle l’ont compris depuis plusieurs années déjà : les corpus les plus stratégiques pour l’entraînement des modèles de langage ne sont jamais rendus publics ».
Le risque de l’atrophie linguistique
Nous sommes désormais enjoints à vivre avec les simulateurs de discours. Et cela n’est pas sans conséquences. Dans tous les domaines où le texte est moteur, les crises sont là : journalisme, éducation, droit… En exploitant la langue, c’est elle-même qui est transformée et en ré-exploitant les textes, c’est leur condition de production largement artisanale qui est menacée. L’économie du texte construit sur la difficulté à écrire est d’un coup bouleversée par les modèles de langage. En sciences, cela conduit par exemple à l’effondrement des modèles d’évaluation. A l’école, cela conduit à interroger le sens même de l’apprentissage. Tout notre édifice épistémique, construit sur les performances rédactionnelles, vacille, sous les coups du développement du capitalisme linguistique. Partout, les machines qui écrivent réévaluent la valeur du travail d’écriture dans les structures de management. Du code au droit, des contrats aux instructions, de l’information aux textes instrumentaux (compte rendu, demandes de rendez-vous, courriers administratifs…), c’est la pertinence même des processus bureaucratiques qui est remise en question. « Ecrire avec la machine à écrire de quelqu’un d’autre, c’est prendre le risque de se voir voler son texte ». Mais plus encore d’en être non seulement dépossédé, quand ce n’est pas remplacé par les productions automatisées. Derrière ces enjeux épistémiques, c’est l’épistémologie elle-même qui est remise en question. « L’écriture algorithmique change notre confiance dans l’écrit », explique Kaplan. Mais c’est désormais à chacun d’entre nous de gérer cela, dans une relation d’autant plus difficile que ces textes sont construits pour « cacher la nature des procédés qui les ont engendrés ».
Pour le professeur en Humanités numériques, nous sommes confrontés désormais à notre prolétarisation linguistique. Nous sommes désormais invités à payer pour écrire tant de mots (tokens) par mois, avec des prothèses plus ou moins sophistiquées, plus ou moins chères. L’usage de la langue n’est plus vendu seulement aux annonceurs, mais elle est désormais revendue à chacun d’entre nous. Les prothèses linguistiques sont partout. Elles interviennent dans la production, l’interprétation, la transmission. Elles améliorent l’efficacité, la précision ou la qualité ou la dénaturent. Nous déléguons nos compétences au risque de les abandonner, au risque de transformer profondément nos propres savoir-faire, comme le souligne très bien la philosophe Anne Alombert dans ses travaux, notamment son dernier livre, De la bêtise artificielle. Avec ces prothèses, le risque d’une atrophie de nos compétences semble plus certaine que celui d’un élargissement des compétences linguistiques du plus grand nombre. « Chaque fois qu’une technique prend en charge une faculté humaine, elle en accroît la puissance tout en affaiblissant la maîtrise (…). Les prothèses qui étendent notre intelligence risquent aussi de nous en déposséder si nous ne réinventons pas sans cesse notre façon de penser et d’agir avec elles ». Pour Kaplan, le risque d’une « atrophie expressive », d’une incapacité à composer un discours sans intermédiation est devant nous. « Le locuteur est devenu un locataire ». Nous écrivons et parlons par l’intermédiaire de mots que nous louons à ceux qui possèdent les machines.
Le capitalisme linguistique dévore le monde
Pour Kaplan, même si nous ne nous y sommes pas encore habitué, ce capitalisme linguistique là est pourtant peut-être déjà derrière nous !
Dans le premier régime du capitalisme linguistique, on a revendu les mots aux annonceurs. Dans le second, on peut désormais revendre les mots aux utilisateurs. Dans le troisième, les simulateurs linguistiques peuvent désormais construire, agir, décider. Depuis quelques instructions, les systèmes construisent des systèmes. « Dans le premier régime, les mots qui s’accumulent de façon exponentielle permettent l’organisation d’une bourse qui se globalise à l’échelle mondiale et peut générer des centaines de milliards de dollars de revenus. Dans le deuxième régime, les avancées des modèles de langage prédictifs rendent possibles des prothèses linguistiques d’une expressivité croissante, favorisant l’élargissement des parts de marché et l’accumulation accélérée de capital linguistique supplémentaire. Enfin, dans le troisième régime, l’augmentation conjointe des capacités de calcul et des volumes de données permet de produire des modèles capables de simuler des raisonnements plus complexes ou de résoudre des tâches plus difficiles, sans qu’il soit nécessaire d’apporter des changements significatifs à la nature des architectures informatiques. Il suffit d’investir davantage dans les centres de calcul pour bénéficier de cette augmentation des performances cognitives des modèles. » Avec l’arrivée de « l’autocatalyse cognitive », le capital linguistique croit alors de façon quasi automatique. L’IA agentique promet désormais la grande orchestration des systèmes entre eux et la production d’agents à la carte, facturés selon leur degré d’expertise. « Cette mise au travail du capital linguistique ne se déploie pas comme une superintelligence omnisciente, mais comme une force d’engendrement qui tire sa puissance des boucles de rétroaction dans lesquelles elle s’inscrit. » « Nous sommes en train de passer d’un savoir hérité des communautés humaines à un savoir auto-entretenu par les modèles ». Pour Kaplan, ce sont nos systèmes culturels mêmes qui sont en train d’être transformés, de changer d’état, de phase. Le risque, conclut le chercheur, c’est de basculer dans un quatrième régime du capitalisme linguistique : celui du contrôle de la production du discours et de la langue elle-même. Une forme de convergence des discours, une homogénéisation voire un aplatissement de la langue, structurant une lecture du monde unique. Une logique proche de la novlangue imaginée par George Orwell : « une langue conçue pour limiter la liberté de pensée et d’expression, par l’introduction progressive de contradictions internes. La guerre, c’est la paix ; la liberté, c’est l’esclavage ; l’ignorance, c’est la force ». Mais est-ce les machines qui nous conduisent à cette impasse ? Cette langue est aujourd’hui celle des discours les plus confus et elle n’est pas tant produite par les machines que par les hommes et les idéologies qu’ils activent.
Ce qui est sûr, c’est que le glissement culturel a commencé. En avril 2025, le trafic de Wikipédia, de Youtube, de Facebook et Google a commencé à baisser, alors que celui de l’IA, partout, explose. « L’attention se détourne des contenus construits, discutés et sourcés, pour s’orienter vers des savoirs instantanés et contextualisés ». Le document disparaît. Il est désormais recomposé à la volée. « Le quatrième régime du capitalisme linguistique confère un pouvoir démesuré à ceux qui contrôlent les modèles ». Kaplan plaide certes pour une reprise en main pour construire des corpus et des modèles publics, des modèles à code et paramètres ouverts. Nous devons garder la main sur les forces de production du langage, « avant que n’ayons peut-être plus les mots pour imaginer comment faire ». Le constat qui s’annonce est d’autant plus sombre que la puissance des outils tourne la tête de tous.
Si l’essai de Frédéric Kaplan manque souvent de perspective critique, notamment sur les errements que ces systèmes produisent où sur les gens que ces systèmes exploitent, sa force réside surtout dans sa clarté et dans l’éclairage que produisent les concepts. Reste que si face au capitalisme de surveillance, on pouvait encore réclamer ou opposer une exigence d’une moindre surveillance. Face au capitalisme qui exploite nos propres mots pour nous en déposséder, on ne sait plus quels leviers adresser pour le contenir voire le faire refluer. Face à l’exploitation de notre propre pensée, c’est assurément nous-mêmes qui en seront dépossédés.
Hubert Guillaud
23.09.2026 à 07:00
Quels travailleurs détestent le plus l’IA ?
Hubert Guillaud
Texte intégral (1678 mots)
Il y a visiblement une profession qui déteste l’IA plus que toute autre, ce sont les assureurs chargés du traitement des sinistres, rapporte Wired. Ils sont les premiers à se plaindre de « dirigeants obsédés par l’IA qui l’imposent, à eux et à leurs clients ». C’est en tout cas ce qu’on apprend d’une étude de Glassdoor sur le ressenti des travailleurs face à l’IA qui a étudié les réflexions des employés sur l’IA issue des avis qu’ils laissent sur leur employeur sur le grand site participatif d’évaluation des environnements de travail. Tout secteur confondu, rapporte l’étude, les mentions de l’IA dans les avis Glassdoor ont augmenté de 240 % entre mai 2025 et mai 2026. Mais si par le passé, les avis mentionnant l’IA étaient majoritairement positifs (81 % d’avis positifs en 2019), cette tendance s’inverse : en 2026, on ne compte plus que 43 % d’avis positifs, 4 % d’avis mitigés et 53 % d’avis négatifs.
L’étude empirique de Glassdoor montre un renforcement de la tension sociale autour de l’IA. Hormis les dirigeants d’entreprises qui demeurent le groupe le plus favorable à l’IA, certains métiers adhèrent à ses avantages, comme les responsables des ventes et des produits, les recruteurs, les architectes logiciels ainsi que les analystes et ingénieurs de données. A l’inverse, d’autres professions y sont majoritairement hostiles, notamment les rédacteurs, les journalistes, les comptables, les agents de service client, les designers et professionnels de l’informatique. Mais les plus hostiles restent les gestionnaires de sinistres : 98 % de leurs commentaires étant négatifs.
Les femmes et la génération Z (nés entre 1997-2012) sont les plus critiques à l’égard de l’IA. Les travailleurs plus âgés ont tendance à avoir une opinion plus positive de l’IA, tandis que les plus jeunes sont plus critiques. Au sein de chaque génération, les hommes sont plus enclins à mentionner l’IA, et les femmes se montrent plus critiques que les hommes à son sujet. Chez les hommes de la génération X (nés entre 1960 et 1980), 50 % des commentaires sur l’IA sont positifs, alors que 42 % des commentaires des femmes de cette même génération sont négatifs. Les différences liées au poste occupé et au secteur d’activité expliquent entièrement cet écart. Les commentaires des hommes de la génération Y (milléniaux, nés entre 1980 et 1997) sont positifs à 44 %, contre 33 % pour les femmes. Les différences de poste et de secteur n’expliquent qu’un quart de cet écart. Les hommes de la génération Z affichent 42 % d’avis positifs, contre 21 % pour les femmes de la même génération ; ici, le poste et le secteur d’activité n’entrent pas en ligne de compte. Cet écart persiste même après ajustements statistiques.
Les commentaires sur l’IA reflètent des opinions tranchées Les mentions de l’IA apparaissent généralement dans des avis Glassdoor très positifs ou très négatifs, en particulier concernant la direction et les perspectives de l’entreprise. Seuls 23 % des auteurs d’avis critiques envers l’IA approuvent le PDG, et 18 % perçoivent des perspectives commerciales positives. À l’inverse, 86 % des auteurs d’avis positifs sur l’IA approuvent le PDG et 81 % envisagent des perspectives commerciales favorables. Les auteurs d’avis positifs sur l’IA sont plus attachés à leur entreprise Les employés ayant cité l’IA comme un point positif sont 47 % moins susceptibles de postuler à d’autres emplois sur Glassdoor. Ceux qui émettent des critiques sur l’IA postulent à d’autres emplois dans des proportions similaires aux employés ne mentionnant pas l’IA. Aucun secteur ni aucune taille d’entreprise ne recueille une majorité de commentaires positifs sur l’IA, mais certains affichent un taux de critique élevé. Les travailleurs du secteur technologique mentionnent l’IA 3,6 fois plus souvent que la moyenne. Les secteurs suivants en termes de fréquence sont les médias et la communication (1,8 fois) ainsi que la gestion et le conseil (1,1 fois le taux de référence). L’IA est la plus populaire dans le secteur juridique, bien que les avis y soient partagés à parts égales (50/50). D’autres secteurs se montrent extrêmement critiques à l’égard de l’IA, notamment les arts (89 % d’avis négatifs), les organisations à but non lucratif (85 %), les assurances (81 %), les télécommunications (80 %) et le transport/la logistique (79 %). Les petites entreprises (200 employés ou moins) ont tendance à susciter davantage de commentaires positifs sur l’IA (50 % d’avis positifs), un chiffre qui tombe à 33 % pour les entreprises de plus de 10 000 employés.
Bon, revenons à nos agents d’assurances. « Nous sommes épuisés par la quantité d’IA qu’on nous impose », témoigne l’un d’eux à Wired. En fait, la profession traverse une crise majeure. Le nombre de postes a baissé de 5% au cours de la dernière décennie et de plus de 21% entre mai 2025 et 2026, et les postes de débutants ont chuté de plus de 50% depuis 2025. Pour le bureau des statistiques du travail américain, cette chute serait liée au déploiement technique. « Des startups spécialisées, comme Liberate ou Pace, ont levé des millions de dollars en promettant de « réinventer » l’assurance, tandis que les assureurs ont intensifié le recours à l’IA pour traiter un volume croissant de dossiers. Concrètement, cela peut se traduire par un échange avec un chatbot plutôt qu’avec une personne physique pour déclarer un sinistre. Au lieu d’envoyer des agents inspecter une habitation endommagée, des outils d’IA peuvent analyser des photos ou des vidéos pour estimer le montant des indemnisations. L’IA peut également résumer des centaines de pages de dossiers médicaux afin d’en extraire les informations essentielles. Ou bien, l’outil d’IA d’un assureur pourrait traiter les informations transmises par un assuré – photos, vidéos, documents, reçus – puis effectuer un versement, le tout en quelques secondes », comme le propose Lemonade dont le chatbot traiterait 55% de l’ensemble des dossiers de sinistres, laissant à ses employés la gestion des dossiers les plus complexes. Mais les professionnels du secteur ont surtout l’impression d’être remplacés par des modèles d’IA… sans que les clients ne comprennent très bien que les conclusions d’une expertise (et ses erreurs) sont bien plus le fait de robots que d’experts.
Comme le résume l’historien Brian Merchant sur son blog qui s’est également intéressé à l’étude : « les personnes qui décrivent l’IA en termes très positifs occupent, pour la grande majorité, des postes de direction ; ce sont les cadres de niveau directeur ou supérieur qui manifestent le plus d’enthousiasme à son égard. Les responsables des ventes – en somme, les chefs d’équipe commerciale – se montraient également bien plus favorables que défavorables à l’IA, dans une proportion d’environ deux pour un. Les chefs de produit, les recruteurs et les ingénieurs logiciels affichent eux aussi un avis plutôt positif, avant que les opinions ne tendent vers un certain équilibre ». A l’inverse, remarque l’historien, si l’on observe les professions qui décrivent l’IA en termes très négatifs, on voit apparaître une toute autre configuration sociale. Merchant souligne que le basculement des avis négatifs a progressé et qu’il s’affirme à mesure que les entreprises adoptent massivement des solutions d’automatisation basées sur l’IA. Mais, il semble que « plus les travailleurs sont exposés à l’IA, moins ils l’apprécient ». Pour Merchant, « le ressenti vis-à-vis de l’IA au travail dépend probablement du pouvoir dont vous disposez au sein de l’entreprise ». Le rapport à l’IA est distribué selon le pouvoir dont on dispose sur ces outils. L’appréciation est directement liée à la position sociale qu’on occupe.
« Pour percevoir l’IA de manière positive, il faut avoir la main sur les décisions concernant son utilisation (ou non) et disposer d’une marge de manœuvre suffisante pour se sentir protégé contre le risque de remplacement, de surveillance ou de dégradation des conditions de travail ». Les cadres et les patrons ont bien peu de comptes à rendre quant à leur utilisation de l’IA. A l’inverse, les employés, eux, n’ont bien souvent aucune liberté dans leur rapport à l’IA. Pour Brian Merchant, la question de la responsabilité éclaire la différence de perception. C’est pourquoi les emplois d’employés sont bien plus en colère contre l’IA que les cadres. Cela explique que les comptables, les conseillers clientèles ou les informaticiens de base soient mis en difficulté par ces outils, car c’est sur eux que repose la tension de la vérification entre « le patron exige que toute l’entreprise utilise l’IA » et « la moindre erreur est de votre faute et vous en êtes responsable ». Entre ceux qui sont contraints et ceux qui restent libres. La tension entre ceux que ces outils assistent et libèrent et ceux que ces outils contrôlent et limitent, n’est pas tant une différence d’approche de l’IA, qu’une différence sociale entre le haut et le bas du déploiement de l’IA.
22.09.2026 à 07:00
Musique : le piège du droit d’auteur génératif
Hubert Guillaud
Texte intégral (4316 mots)
Pour le magazine canadien Maisonneuve, le journaliste Michael Rancic, qui fait partie de la coopérative de journalistes musicaux New Feeling, se désole de l’omniprésence de la musique générative partout. Mais si les plateformes de streaming sont déjà envahies des morceaux produits notamment via les outils proposés par Suno et Udio, les acteurs majeurs de la musique (stations de radio, organismes de réglementation et maison de disques), eux, tergiversent, hésitant entre intégrer ou au contraire à contrer la musique générative.
En octobre 2025, la Socan (Société canadienne des auteurs, compositeurs et éditeurs de musique) a annoncé avoir harmonisé sa position sur la génération de musique avec son homologue américain, l’Ascap (la société américaine des compositeurs, auteurs et éditeurs).
Désormais, « les auteurs-compositeurs peuvent enregistrer des chansons partiellement générées par l’IA pour percevoir des redevances ». Pour Rancic, c’est là un tournant : les œuvres créées avec l’aide de l’IA générative peuvent être intégrées aux systèmes existants de propriété et de rémunération. L’annonce précise soigneusement que, pour être éligible aux redevances, une chanson doit toujours comporter des « éléments de création humaine ». Cependant, elle légitime simultanément une technologie que beaucoup perçoivent comme une menace pour le savoir-faire musical humain.
Or, rappelle Rancic, Suno a reconnu avoir entraîné son modèle depuis toute la musique enregistrée disponible. L’entreprise n’avait aucune autorisation pour ce faire et n’a offert aux artistes aucun moyen de retirer leurs œuvres, qu’elles soient protégées ou non par le droit d’auteur. Des plateformes comme Suno absorbent ainsi des décennies de travail humain et produisent des imitations convaincantes en quelques secondes. Entraînée sur des milliers d’œuvres protégées par le droit d’auteur, la production est alors considérée comme une « nouvelle » chanson. Durant leurs premières années d’activité, Suno et Udio ont également mis en place des cadres propriétaires autour de ces nouvelles chansons : celles-ci peuvent être immédiatement acquises par quiconque saisit l’instruction de génération. Ce contournement des droits d’auteur a, à juste titre, suscité l’inquiétude des artistes.
Premièrement, il a permis aux entreprises d’IA de tirer profit d’œuvres pour lesquelles elles n’avaient pas nécessairement acquis de licence. Deuxièmement, il permet aux utilisateurs de générer des quantités massives de musique sans rémunérer les artistes – un système qui pourrait entraîner la perte de revenus pour de nombreux musiciens. Une lettre ouverte de 2024, signée par des artistes tels que Billie Eilish, Chappell Roan et Arkells, qualifiait l’entraînement d’IA sur de la musique sans compensation d’« atteinte à la créativité humaine ».
Ces tensions ne sont pas propres à la musique. Les artistes visuels ont exprimé des préoccupations quasi identiques concernant les générateurs d’images entraînés sur leurs œuvres, tandis que les cinéastes et les acteurs ont commencé à se confronter aux outils d’IA capables de reproduire des voix, des textes et même des images.
En annonçant les nouvelles lignes directrices sur les redevances, la Socan a décrit l’IA comme un outil précieux largement adopté par les musiciens. Dans le même temps, la déclaration critique le fonctionnement actuel de cet outil censément utile : « l’utilisation par les entreprises de technologies d’IA de modèles basés sur des œuvres musicales protégées par le droit d’auteur, sans autorisation, compensation ni mention des créateurs, ne relève pas de l’usage loyal, mais du vol ». La Socan a réitéré ce point de vue lors d’une récente campagne publique, appelant le gouvernement fédéral à « dire non à l’entraînement de l’IA sur de la musique sans licence ». Mais si la Socan le croit vraiment, pourquoi autoriser la perception de redevances sur des œuvres produites à l’aide de telles plateformes ?
Les lignes directrices de la Socan concernant l’enregistrement de l’IA font la distinction entre les « productions générées par l’IA », qui ne sont pas admissibles à l’enregistrement, et les « œuvres assistées par l’IA ». Or, les déclarants n’ont pas à divulguer l’utilisation de l’IA dans leurs œuvres assistées par l’IA, ce qui signifie que la Socan fait preuve d’une grande confiance, explique Michael Rancic. Déterminer si une chanson a été partiellement ou entièrement créée avec l’IA semble reposer sur une simple intuition. Seule compte une directive vague selon laquelle « la créativité de l’auteur humain doit être centrale ». Il serait envisageable de déposer une chanson avec des voix humaines sur une musique instrumentale générée par IA – entraînée sur les meilleurs rythmes jamais créés – et de satisfaire ainsi aux exigences minimales fixées. Si certains défenseurs font la distinction entre la musique utilisant simplement des composants d’IA et celle entièrement produite par IA, cette frontière est de plus en plus difficile à maintenir. En pratique, les deux reposent souvent sur les mêmes infrastructures d’entraînement et l’extraction de données à partir d’enregistrements humains, ce qui rend la distinction moins pertinente qu’il n’y paraît et pourrait même contribuer à redorer l’image de la génération par IA.
Bien que toutes les plateformes de musique générée par IA ne soient pas entraînées sur de la musique sans licence, la nouvelle réglementation n’identifie aucun mécanisme permettant de distinguer la musique générée par IA utilisant ou non des chansons sans licence, et crée un précédent en faveur de l’adoption de cette technologie. Parallèlement, la déclaration souligne l’importance de soutenir les artistes et de favoriser la créativité. « L’avenir de la musique peut intégrer l’IA tout en restant profondément humain », affirme Jennifer Brown, PDG de la Socan. Ce cadre confère de fait la propriété intellectuelle aux utilisateurs d’IA générative et fragilise les structures de propriété antérieures, censées protéger les artistes. Il révèle une asymétrie dans le traitement de la paternité, du travail et des risques au sein de l’industrie musicale. « Les associations musicales s’empressent d’adopter les nouvelles technologies et plateformes, tout en les critiquant, reflétant une tendance générale du secteur à privilégier les plateformes au détriment des artistes ».
Alors que des organismes comme la Socan acceptent la musique générée par l’IA, les acteurs gouvernementaux et industriels élaborent leurs propres approches. Le gouvernement fédéral canadien consulte actuellement les intervenants du secteur, notamment la Socan, sur l’interaction entre l’IA générative et le droit d’auteur. Ces consultations, menées auprès du Groupe de travail sur la stratégie en matière d’IA du gouvernement et du Comité permanent du patrimoine canadien, visent à éclairer l’élaboration de la stratégie canadienne en matière d’IA pour les années à venir. Malgré la croissance rapide de l’IA générative, le Canada ne dispose actuellement d’aucune loi spécifiquement conçue pour traiter de ses implications en matière de droit d’auteur et de droits des créateurs. Toutes les questions relatives au droit d’auteur relèvent de la Loi sur le droit d’auteur. Actuellement, la Loi sur le droit d’auteur limite l’« utilisation équitable » à des fins spécifiques comme la recherche, la critique, l’éducation ou la parodie. Autrement dit, il est légal d’utiliser des œuvres protégées par le droit d’auteur sans autorisation à ces fins et dans certains contextes. Ces fins n’incluent pas explicitement les entreprises d’IA qui entraînent leurs modèles sur de la musique sans autorisation. « Dans ce contexte, la décision de la Socan d’intégrer la musique générée par l’IA à son système de redevances, avant même que le Canada n’ait établi si cette technologie est conforme à la loi sur le droit d’auteur, revient à mettre la charrue avant les bœufs ».
Il est paradoxal de voir les organisations de l’industrie s’empresser de créer des voies d’accès pour l’IA, explique Michael Rancic. « Prenons l’exemple des plateformes musicales. Lorsque de nouvelles technologies ont bouleversé les normes créatives par le passé, l’industrie n’a pas hésité à intervenir pour protéger les titulaires de droits et sanctionner ceux qui opéraient en dehors du cadre établi. Le sampling (ou échantillonnage), par exemple, a suscité des décennies de litiges, d’accords de licence stricts et une dynamique inéquitable où la charge du risque juridique lié à l’autorisation des échantillons incombait à celui qui les utilisait. Dans les années 1980 et 1990, les différends canadiens liés au sampling ont été largement influencés par les grandes maisons de disques et les titulaires de droits américains. John Oswald, pionnier de l’approche de collage musical par échantillonnage baptisée « plunderphonics », a ressenti le poids et l’influence de la Canadian Recording Industry Association (CRIA, aujourd’hui Music Canada). L’œuvre d’Oswald transformait des tubes classés en tête des palmarès en mosaïques sonores abstraites, métamorphosant le familier en quelque chose d’étrange et d’insolite – une prouesse alliant virtuosité technique et créativité. La CRIA a agi pour le compte des majors américaines en adressant à Oswald une mise en demeure, obtenant finalement la destruction de son œuvre. »
Le régime actuel du droit d’auteur favorise les artistes établis représentés par de grandes maisons de disques, ces dernières disposant des ressources nécessaires pour identifier les titulaires de droits, négocier les licences et régler les frais initiaux éventuels, rappelle Michael Rancic. « Ce système opaque et bureaucratique pénalise lourdement les artistes émergents : il rend risquée l’utilisation transparente d’échantillons et les empêche souvent de détenir légalement les droits sur leurs œuvres – et donc d’en tirer profit. Une chanson contenant un seul échantillon non autorisé ne peut être enregistrée pour percevoir des redevances ; en revanche, une chanson créée par des plateformes entraînées sur une quantité colossale de musique non autorisée semble, elle, échapper à ces contraintes. »
« Les structures du droit d’auteur dans l’industrie musicale sont conçues pour servir ses membres les plus puissants » (voir notre article, « Mais qui décide de comment on compte ? », qui prenait justement l’exemple des Majors de la musique). « Les nouvelles technologies contribuent à perpétuer ce mécanisme : il est révélateur, par exemple, qu’avant même de pouvoir générer de la musique, les outils d’IA aient été utilisés par l’industrie pour surveiller les violations du droit d’auteur ». Spotify a acquis The Echo Nest en 2014 après que cette entreprise a mis au point une technologie d’empreinte acoustique (audio fingerprinting), capable d’analyser les caractéristiques sonores uniques d’un enregistrement pour les convertir en une signature numérique compacte. Concrètement, cette technologie permet aux plateformes de reconnaître les chansons dès leur mise en ligne et d’empêcher la diffusion de copies non autorisées. Aujourd’hui, les plateformes de streaming utilisent des technologies similaires – telles que des « filtres anti-spam musical » – pour identifier la musique générée par IA et les violations potentielles du droit d’auteur. Ces outils sont présentés comme une réponse aux violations du droit d’auteur liées à la génération de musique par IA, alors même qu’ils reposent eux aussi sur cette technologie, explique Rancic. Lorsque l’IA est à la fois le problème et la solution, il semble qu’il n’y ait plus vraiment de choix.
« Le déploiement rapide, au cours de la dernière décennie, d’outils de protection des droits basés sur l’IA témoigne de la priorité accordée de longue date à la préservation de la propriété intellectuelle et des redevances associées. Pourtant, lorsque ces mêmes technologies sous-jacentes permettent la production automatisée de musique, la réaction du secteur se fait nettement plus permissive, voire complaisante. » Au départ, l’industrie a semblé céder à la panique face à l’émergence de la musique générée par IA, les grandes maisons de disques intentant des procès aux entreprises technologiques à l’origine de ces outils. Aujourd’hui, certains de ces mêmes acteurs cherchent activement à collaborer avec ces entreprises. Warner Music Group a récemment trouvé un terrain d’entente avec Suno et Udio concernant les méthodes d’entraînement de leurs modèles d’IA, et Universal Music Group a également conclu un accord avec Udio, sans que les détails financiers et une grande partie des clauses contractuelles de ces accords ne soient ni publics ni transparents, rappelle le journaliste. « Ce que l’on sait, en revanche, c’est que ces accords s’accompagnent de l’annonce d’un partenariat entre Warner, Universal et Udio visant à créer une nouvelle plateforme de génération de musique par IA. Les accords conclus par Udio avec ces deux labels, tout comme celui passé entre Warner et Suno, prévoiraient des mécanismes permettant aux artistes de choisir si leur musique peut ou non servir à l’entraînement des modèles d’IA. Udio et Suno promettent tous deux d’abandonner progressivement les modèles actuels de leurs plateformes – entraînés à partir de musiques non autorisées -, bien que ces modèles soient toujours en service à l’heure où nous écrivons ces lignes. »
Cette attitude permissive de l’industrie face au vol de contenu par les plateformes devient plus compréhensible si l’on reconsidère la véritable finalité de la génération de musique par IA, explique Rancic. Le discours marketing d’Udio affirme que l’entreprise « développe des outils d’IA pour permettre à la prochaine génération de créateurs musicaux d’émerger », tout en soulignant sa capacité à « élargir les horizons musicaux et à permettre à chacun de créer une musique extraordinaire ». Cette présentation de l’IA comme un outil de création se retrouve dans les déclarations de la Socan ainsi que dans des articles du secteur vantant les innombrables possibilités offertes par la musique générée par IA ; comme de générer « des genres musicaux nouveaux ». « Mais tout cela relève de la communication. La véritable proposition de valeur des plateformes de musique générative ne réside ni dans l’innovation esthétique, ni dans un meilleur accès aux outils musicaux, ni même dans l’enrichissement de la création. Elle consiste avant tout à produire des contenus sonores dont on peut immédiatement s’approprier les droits. » Avant les poursuites engagées à leur encontre par les grandes maisons de disques, Suno et Udio permettaient toutes deux aux utilisateurs de télécharger et, de fait, de s’approprier les morceaux générés par l’IA. Dans le cadre de son accord à l’amiable, Udio ne permet plus aux utilisateurs de télécharger et de posséder des chansons générées par IA. Tandis que Suno impose désormais aux utilisateurs de payer pour télécharger les morceaux créés sur sa plateforme. Le nouvel abonnement « Pro » de Suno promet aux utilisateurs la possibilité de générer jusqu’à 500 chansons par mois et l’octroi immédiat des « droits d’utilisation commerciale pour les nouvelles créations ».
« Vous n’avez pas les moyens d’obtenir les droits d’utilisation d’un sample d’artistes Warner comme Neil Young ou Ed Sheeran ? Aucun souci. Vous pouvez désormais créer une chanson dans le style de ces artistes. Vous en devenez immédiatement propriétaire, vous pouvez l’échantillonner à volonté et, grâce à l’annonce de la Socan, vous pouvez même percevoir des droits d’auteur, à condition d’avoir écrit les paroles. Ce nouveau modèle contourne complètement les structures de droits d’auteur et de propriété de l’industrie musicale, le tout dans le but de générer de la valeur pour les investisseurs du secteur technologique (et, grâce à leurs accords, les maisons de disques s’assurent toutefois de conserver leur part du gâteau). Il est franchement lassant de voir ce cycle se répéter sans cesse et de constater que ceux qui, dans l’industrie, ont le pouvoir d’influencer le changement, traitent ces évolutions comme s’il s’agissait de nouveautés – une énième technologie présentée comme un outil de démocratisation de la musique, alors qu’elle sert surtout à consolider leur pouvoir et à s’approprier le travail d’autrui. »
L’abonnement « Pro » offrant « 500 chansons par mois » fait qu’il est difficile de voir Suno autrement que comme un outil de production de masse de musique sous licence pour la publicité, la télévision, les réseaux sociaux et les espaces publics. Cette stratégie est tout à fait logique étant donné la financiarisation croissante de l’industrie, où la propriété des compositions est devenue primordiale. Posséder les droits sur la composition d’une chanson – non seulement l’enregistrement sonore, que l’industrie a toujours exploité, mais aussi la musique et les paroles – est devenu un bien précieux. Des musiciens canadiens comme Young et Justin Bieber ont vendu les droits d’une part importante de leur catalogue. « L’argent dans l’industrie musicale provient désormais des contrats de licence, et non plus des ventes de disques, et les chansons constituent un actif financier », rappelle pertinemment le journaliste. « Grâce à l’IA, les grandes maisons de disques peuvent exploiter davantage ces actifs pour créer de la musique à l’image de leurs artistes sans nécessairement leur verser de royalties ». Un phénomène qui se manifeste dans l’ensemble des industries créatives, à l’image du monde des acteurs et des scénaristes… « Si l’industrie musicale s’est d’abord montrée méfiante face à la menace que représente l’IA pour le droit d’auteur, elle a désormais compris qu’elle pouvait intégrer cette technologie à ce système à son propre avantage ». Au final, tout cela se traduit par moins de travail et probablement une baisse des revenus pour les artistes.
La question n’est plus de savoir si l’IA va transformer la musique, mais dans quelles conditions cette transformation aura lieu. « Des décisions comme celle de la Socan, et les récents accords conclus entre les grandes maisons de disques et les principales entreprises de musique générée par IA, laissent penser que l’industrie se prépare à intégrer les systèmes génératifs avant même d’avoir mis en place des garde-fous capables de protéger les créateurs que ces systèmes exploitent. Les nouvelles politiques de la Socan, et leur exclusion des œuvres entièrement générées par IA, pourraient constituer les prémices de tels garde-fous, mais leur portée reste floue et leur application encore plus complexe. En l’absence de normes contraignantes concernant les données d’entraînement, le consentement et la rémunération, la normalisation de la paternité assistée par IA risque de consolider les inégalités plutôt que de les résoudre. Les cadres émergents permettent aux plus influents de tirer profit de la musique générée par IA, tandis que les artistes moins connus, dont le travail a été volé, sont exploités de manière perpétuelle à chaque utilisation de ces plateformes. »
« Bien que je ne partage pas leur analyse selon laquelle les craintes suscitées par l’IA sont comparables à celles qui ont accompagné l’apparition des synthétiseurs et des boîtes à rythmes, Gordon A. Gow et Brian Fauteux proposent une idée pertinente pour un cadre potentiel encadrant l’IA », explique encore Rancic. S’appuyant sur le précédent du système de classification canadien MAPL – un label apposé sur la musique canadienne indiquant qu’elle répond à un certain niveau de contribution canadienne -, ils proposent d’étiqueter les chansons générées par l’IA. Des labels physiques et numériques pour l’IA pourraient à tout le moins favoriser la transparence et permettre aux consommateurs de faire des choix éclairés, souligne le journaliste pour qui « la transparence est essentielle et doit guider tout cadre réglementaire futur ». « Les plateformes d’IA générative doivent divulguer leurs sources de données d’entraînement et fournir une documentation sur leurs modèles d’IA (taille de l’ensemble de données, répartition par genre et méthodologie). »
Certains de ces changements sont en cours : Suno a annoncé en 2025 qu’elle abandonnerait ses modèles d’IA actuels et les remplacerait par de nouveaux modèles « plus avancés », entraînés exclusivement sur des données autorisées, dans le cadre de son accord avec Warner. Toutefois, on peut soutenir que les plateformes ayant bâti leur valeur grâce à de la musique non autorisée devraient être explicitement exclues de tout cadre réglementaire régissant la musique générée par IA. Les récompenser aujourd’hui ne ferait qu’encourager, à l’avenir, ces mêmes modèles fondés sur le principe « construire d’abord, demander ensuite ».
« L’IA générative menace de déstabiliser non seulement les revenus des artistes, mais aussi le lien conceptuel entre la créativité et les créateurs eux-mêmes ». Contrairement au sampling ou à l’imitation – pratiques ancrées dans des choix guidés par un dialogue artistique et une longue tradition de la citation musicale -, « l’IA générative évince totalement le créateur ». Il ne s’agit pas d’un outil de création retravaillant ou répondant à une œuvre existante, mais d’un processus qui dépossède les artistes de leur propre travail. « Si les accords conclus entre les grandes maisons de disques et les plateformes d’IA peuvent sembler positifs pour les artistes, il convient de rappeler qu’ils sont conçus dans l’intérêt des dirigeants et des actionnaires, et non nécessairement de celui des artistes et musiciens ; ces derniers risquent de subir des pressions pour s’intégrer à ces nouveaux systèmes d’IA, alors même que leurs opportunités s’amenuisent face à la production de masse de chansons ».
« Si les décideurs politiques n’agissent pas avec détermination, les artistes pourraient se retrouver confrontés à un avenir où prospèrent des structures de propriété prédatrices et des plateformes dominantes, tandis que la pratique musicale humaine deviendrait de plus en plus précaire au sein des systèmes qui reposent pourtant sur elle. Il n’en résulterait pas nécessairement le silence, mais une profusion de musique à la tonalité étrangement anonyme : un flux ininterrompu de chansons aux styles familiers, générées pour imiter des artistes et des genres populaires, mais déconnectées des communautés et des relations qui les avaient fait naître. Dans ce scénario, la musique de demain se caractériserait par une présence sonore constante doublée d’une absence croissante d’auteur identifiable. »
21.09.2026 à 07:00
Quelles formations recherchez-vous ? La réponse dépend toujours de là où vous habitez
Hubert Guillaud
Texte intégral (814 mots)
« La plupart des étudiants commencent leur recherche d’université sur Google. Une simple requête comme « université » génère un mélange de résumés produits par l’IA, de résultats sponsorisés provenant d’établissements à but lucratif, de résultats organiques issus d’établissements publics ou à but non lucratif, ainsi que de classements provenant de sources telles que les classements des établissements. Le tout généralement adapté à la localisation de l’étudiant. »
Ce processus peut paraître anodin et égalitaire. Il ne l’est pas, rapporte Washington Monthly à la suite d’une publication de sociologues de l’université Northwestern menés par le professeur Lincoln Quillian. « En moyenne, Google affiche des résultats de moindre qualité pour les étudiants résidant dans des zones géographiques (codes postaux) à faibles revenus. »
« En évaluant chaque établissement selon des critères tels que le taux d’obtention du diplôme, le taux de défaut de remboursement des prêts, le revenu médian et les taux de mobilité sociale, ils ont déterminé que les étudiants aisés ont jusqu’à trois fois plus de chances que leurs homologues moins favorisés de voir apparaître dans leurs résultats des universités offrant les meilleures perspectives d’avenir après l’obtention du diplôme. » Un porte-parole de Google s’est défendu en expliquant que « nos systèmes de recherche ne personnalisent pas les résultats en fonction de niveaux de revenus déduits ». Mais la situation géographique depuis laquelle un étudiant fait ses recherches sert en fait de proxy sur son niveau économique… Les chercheurs de Northwestern affirment que, si la situation géographique explique entre 40 et 80 % des tendances observées dans les résultats de recherche, une part résiduelle semble dépendre d’autres indicateurs : l’algorithme prend également en compte les taux de clics, les données personnelles et le ciblage publicitaire payé par les établissements eux-mêmes. « Surtout pour les élèves brillants issus de zones à faibles revenus, le système semble fournir des résultats qui les orientent souvent vers de mauvais choix. »
Les experts qualifient ce phénomène d’undermatched (sous-appariement) : une situation qui existait déjà avant que la recherche en ligne ne devienne le principal moyen de découvrir les établissements d’enseignement supérieur. « Ces élèves étaient systématiquement orientés vers des établissements en deçà de leur potentiel, bien avant même l’apparition de l’IA et d’autres outils en ligne, comme si l’algorithme reproduisait ce que faisait la société auparavant. »
« En réalité, selon l’étude de Northwestern, les recherches Google effectuées depuis des zones géographiques à faibles revenus génèrent davantage de résultats renvoyant vers des établissements à but lucratif. » les écoles aux « résultats médiocres » représentaient 30 % des résultats pour les étudiants issus de foyers gagnant 50 000 dollars par an, contre moins de 10 % pour ceux issus de foyers dont les revenus dépassaient 150 000 dollars. Google n’est pas le seul en cause. Une étude publiée en 2024 par des chercheurs de Princeton et de l’Université de Californie du Sud a révélé que l’algorithme de Meta avait tendance à afficher, aux utilisateurs noirs, davantage de publicités pour des établissements d’enseignement supérieur à but lucratif aux pratiques « prédatrices », qui ont d’ailleurs tendance à avoir recours à des stratégies publicitaires agressives. »
« Le principal moteur de recherche du pays entrave davantage l’accès à un enseignement supérieur de qualité pour les étudiants qui en bénéficieraient le plus », conclut le journal.
La prise en compte problématique de la situation géographique de celui qui fait des requêtes sur un service en ligne (et de son historique) n’est pas sans effet sur les résultats qui lui sont proposés. Le risque est fort de renforcer une forme de discrimination numérique territoriale (digital redlining) et sociale, peu visible. Le problème de cette discrimination numérique est qu’elle reste documentée depuis longtemps (on se souvient notamment du livre de Safiya Umoja Noble, Algorithm of oppression, NYU Press, 2018, non traduit) et que peu est proposé pour la résoudre.
18.09.2026 à 07:00
La transcription automatique en ses limites
Hubert Guillaud
Lire la suite (348 mots)
On avait déjà souligné les grandes limites de la synthèse automatisée. Un organisme de surveillance du service national de santé (NHS) britannique, Healthwatch England, met en garde : les assistants de transcription par IA – qui écoutent et transcrivent les consultations médicales – utilisés par de plus en plus de docteurs, se trompent sur les noms de médicaments et les diagnostics, rapporte The Guardian. « Si elles ne sont pas détectées, ces erreurs risquent de se retrouver dans les dossiers médicaux des patients et d’affecter leur prise en charge ». Le problème, souligne Healthwatch England, c’est que les dispositifs de transcription automatiques des consultations sont au cœur du « grand virage » prévu pour le NHS, visant à transformer un service fonctionnant sur des méthodes analogiques en un service numérique. Ces erreurs, souvent repérées par les patients eux-mêmes, nécessitent de mettre en place un système de signalement et de rectification adapté. Le problème, pointe encore l’organisme, c’est que l’Agence de réglementation des médicaments et des produits de santé a décidé de ne pas classer ces outils de transcription par IA comme des dispositifs médicaux ; cela signifie qu’il n’y aura aucune supervision à l’échelle de l’Angleterre pour garantir leur sécurité et leur efficacité.
Pour Charlotte Blease, experte en utilisation de l’IA dans le secteur de la santé à l’université d’Uppsala (Suède), les erreurs sont plus susceptibles de se glisser dans les dossiers lorsque la consultation implique plusieurs personnes, que les patients ont des antécédents médicaux complexes ou les patients maîtrisent mal l’anglais.
17.09.2026 à 07:00
Comprendre les défaillances de la chaîne d’élimination automatisée
Hubert Guillaud
Texte intégral (3253 mots)
L’AI Now Institute en collaboration avec Airwars.org, un site qui depuis 2014 documente les conflits, ont publié un excellent reportage visuel pour comprendre les enjeux de l’IA sur le champ de bataille sous forme d’un récit, fictif et simplifié, d’une attaque menée avec l’IA, augmenté d’explications spécifiques. « Pour démystifier l’IA militaire, nous construisons une chaîne de destruction abstraite qui reflète un cycle de ciblage par IA. Plutôt que de copier un cadre formel de chaîne de destruction utilisé par un État spécifique, notre schéma illustre les activités tactiques et les décisions impliquant l’utilisation de systèmes d’IA à travers six étapes : 1. Capteurs et données, 2. Surveillance, 3. Renseignement et identification, 4. Sélection, 5. Frappe et 6. Évaluation post-frappe. »
« Les systèmes d’aide à la décision assistés par l’IA – qu’ils s’appuient sur de grands modèles de langage (LLM) ou sur d’autres types d’algorithmes d’apprentissage automatique – intègrent des informations provenant de capteurs couvrant les zones d’opérations militaires. Il peut s’agir de textes issus d’Internet, d’images satellites, de données audio provenant de télécommunications ou de vidéos captées par des drones. Ces données sont synthétisées sur une interface unique et conviviale.
Le problème : les données des capteurs peuvent être incomplètes ou altérées en raison de défaillances, d’interruptions des communications ou d’incertitudes environnementales. Des données comportant des erreurs d’étiquetage (par exemple, des inversions, des omissions ou des étiquettes superflues) peuvent entraîner une dégradation significative, bien que difficile à déceler, des performances de l’IA. L’écosystème d’information dans lequel évoluent les LLM ou autres réseaux de neurones peut également contenir des informations obsolètes ou délibérément corrompues. Ces sources de données sont par ailleurs vulnérables aux afflux massifs d’événements, aux campagnes de désinformation, au détournement de tendances et aux manœuvres de leurre militaire, autant d’éléments qui finissent par compromettre l’efficacité des technologies d’IA en matière de ciblage. » En fait, contrairement au discours qui voudrait que toutes les données utilisées soient parfaitement fiables, c’est en fait assez peu le cas, rappellent les chercheurs.
Si l’histoire est fictive, les technologies décrites, elles, sont bien réelles. Et les explications permettent de comprendre les enjeux de chacune, comme la détection d’anomalie par exemple, qui vise à repérer des schémas inhabituels ou des changements dans l’imagerie satellitaire, les données radar et autres flux de télédétection provenant de zones d’opérations militaires. Ces systèmes peuvent recourir à des réseaux de neurones à convolution ou à des auto-encodeurs pour traiter des volumes massifs de données et repérer des éléments susceptibles d’indiquer des mouvements de troupes, des déploiements de missiles, des infrastructures endommagées ou des modifications inattendues du terrain. Le problème avec ces technologies de détection d’anomalies c’est qu’elles peinent à distinguer des menaces réelles des variations environnementales ordinaires. « Les conditions météorologiques, les ombres, le bruit des capteurs et les différences d’angles de vue peuvent entraîner des erreurs de classification. De même, les auto-encodeurs sont entraînés à différencier les schémas correspondant à une classification spécifique des anomalies qui s’en écartent. Toutefois, ces modèles manquent de généralisabilité et de fiabilité ; par ailleurs, les données utilisées pour leur apprentissage peuvent être biaisées, présenter une distribution limitée ou reposer sur des classifications stéréotypées, conduisant à une mauvaise identification de la nature ou de l’identité d’une menace imminente. En 2025 par exemple, il a été démontré que la précision de Maven peut chuter en dessous de 30 % lorsqu’il est déployé sur un terrain inconnu ou dans des conditions environnementales incertaines entravant sa capacité à reconnaître et à signaler des objets », comme le rappelait Katrina Manson dans son livre.
Parmi les nombreuses techniques utilisées, il y a aussi le géorepérage de ces mêmes cibles pour détecter les véhicules ou téléphones qui entrent dans une zone, déclenchant une surveillance et un suivi de la localisation des téléphones et véhicules et une interception des communications : les messages sont automatiquement relayés et traduits en direct, avec des termes qui déclenchent des alertes renforcées (notamment des termes temporels, comme « imminent » ou « bientôt »). Les propriétaires des cartes Sim sont bien sûr identifiés pour contrôler s’ils ne sont pas déjà sur des listes de suspects ou contrôler leur score de risque (un système de notation sociale qui passe au crible toutes les données collectées passivement sur les habitants, données issues de caméras et des réseaux sociaux, pour créer un score de probabilité qu’ils appartiennent à l’armée adverse, voir notre dossier). Si le score de menace est élevé, l’opérateur peut accéder aux sources afférentes pour enquêter et confirmer ou infirmer la menace depuis toutes les données collectées. Parmi celles-ci : les déplacements provenant du GPS du téléphone, les informations relatives aux plaques minéralogiques du propriétaires du véhicules (et donc les déplacements associés à ces véhicules), ses SMS, l’enregistrement de ses derniers appels, l’enregistrement de son visage ou de ses empreintes pour débloquer son téléphone, ses mails, savoir s’il s’est déjà trouvé dans une zone géorepérée… Des tonnes d’informations que l’opérateur n’a souvent pas le temps d’examiner car son temps est compté. Mais surtout, les liens et les activités sur les réseaux sociaux constituent l’un des facteurs du score de risque. Une analyse des publications est produite, traduite et analysée automatiquement notamment pour y détecter des émotions, comme le fait que leur auteur soit susceptible d’apprécier des actions de l’ennemi, ou que ces échanges aient été likés par des membres avérés de l’armée adverse. Dans ces analyses traduites, automatisées, il est impossible de vérifier si les publications en question sont bien réelles ou si les traductions sont fidèles. Ses relations sur les réseaux sociaux ou via ses appels et SMS sont également analysées pour montrer si ses abonnés sont membres de l’armée adverse ou s’il a pu échanger avec des ennemis confirmés. En accédant à son profil, on peut récupérer des photos permettant de lancer automatiquement une requête dans les réseaux de caméras de vidéosurveillance et observer si ses déplacements ont un rapport avec des sites surveillés et sensibles. Là encore les erreurs d’identification peuvent être innombrables. Compte tenu du temps limité, l’opérateur a tendance à valider ce que le système de notation sociale suggère. Si l’identification a un caractère d’urgence, un drone de surveillance peut être déployé pour suivre la personne identifiée.
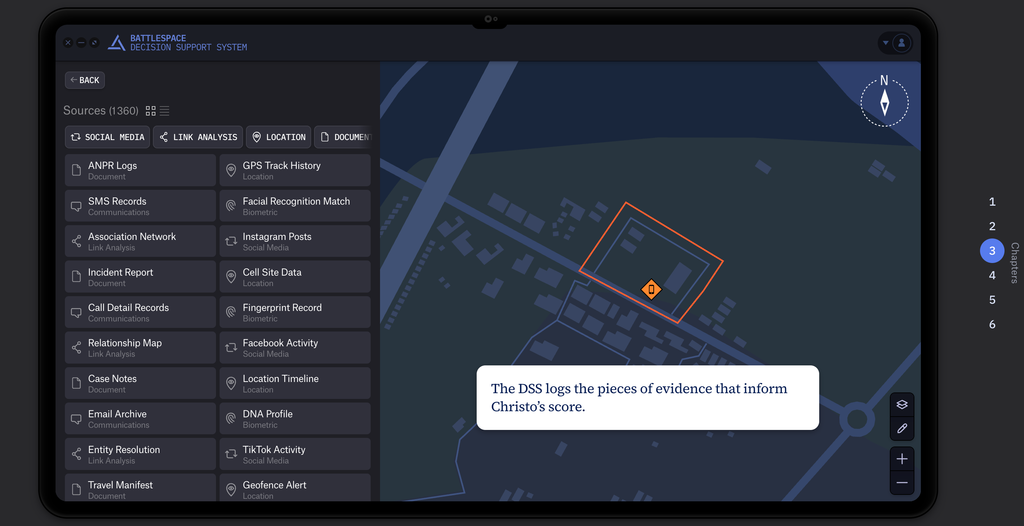
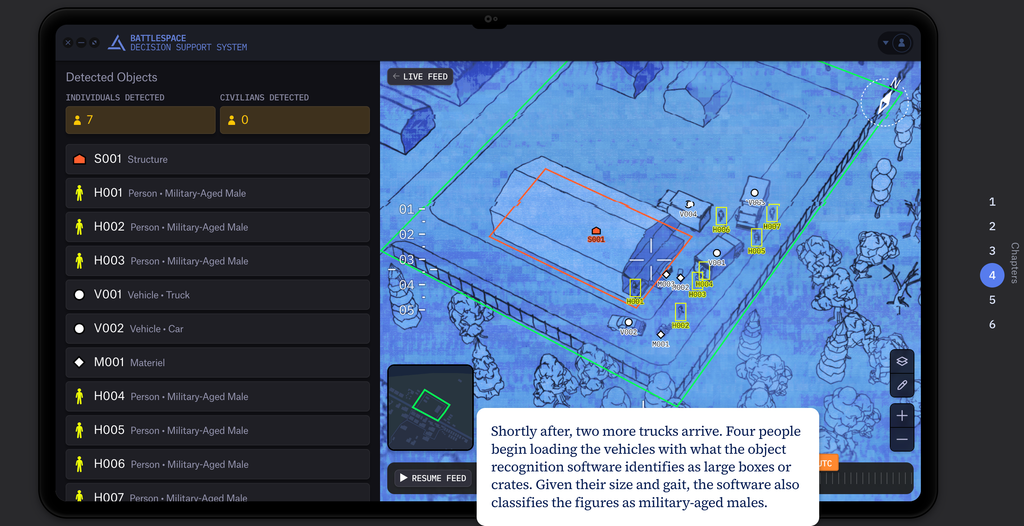
Dans ce cas, le flux vidéo permet d’identifier qui est présent. Les personnes, les véhicules… et les personnes sont distinguées entre civils et membres de l’armée ennemie. Selon leur taille ou leur gabarit, il identifie les objets et les personnes, par exemple en les classant comme des « hommes en âge de combattre ». Chaque image du scénario permet d’accéder à des fenêtres contextuelles permettant de mettre en perspective la fiabilité des technologies utilisées. Par exemple, l’animation rappelle que la détection de formes et d’objets reste peu fiable. « Des recherches ont par exemple révélé que les systèmes peuvent classer de manière erronée 97 % des objets s’ils apparaissent dans des postures s’écartant de celles figurant dans les données d’apprentissage. Par ailleurs, diverses études montrent qu’une grande précision lors des phases de test ne garantit pas nécessairement une précision ou des performances élevées lors du déploiement en conditions réelles. En 2021, l’US Air Force a mené un programme pilote de reconnaissance de cibles affichant un taux de précision de 95 % dans des scénarios d’entraînement. Ce chiffre a toutefois chuté à seulement 25 % en environnement réel. Dans la grande majorité des cas, des algorithmes entraînés à reconnaître des images de missiles sol-sol sous un angle oblique se sont révélés incapables d’identifier ces mêmes objets lorsqu’ils apparaissaient dans des positions différentes. »
Une fois la frappe accomplie, l’opérateur reçoit un rapport d’évaluation, généré par un système d’évaluation des dommages de combat assisté par IA. Ces rapports ont tendance à renforcer les erreurs de classification déjà commises par les systèmes. Les réseaux sociaux sur place et les publications journalistiques locales donnent souvent une autre vision de ces résultats, mais ces informations ne sont pas réintégrées dans le système pour apprécier ses erreurs. Ils montrent aussi parfois que les personnes ciblées ne sont pas aussi menaçantes qu’elles semblaient l’être, en rappelant leur parcours et leurs fonctions.
« À Gaza, l’armée israélienne a publié une vidéo d’une frappe tuant un homme qui transportait ce qu’elle a identifié comme un lance-roquettes. Elle a par la suite reconnu que ses forces avaient mal identifié l’objet : il s’agissait d’un vélo. » La vidéo est d’ailleurs confondante. Vue de haut, on ne sait pas ce que l’homme tient à son bras. Mais, si le système vous indique que c’est un lance-roquette, alors assurément, cela semble en être un. En fait, on comprend que c’est la manière dont ces outils regardent le monde qui est problématique. Pour un système de ce type, tout est menace, tout est orienté pour détecter des menaces, et à force de regarder le monde comme une menace, il le devient.
« Les partisans de l’IA soutiennent qu’elle peut atténuer et réduire ces erreurs. Toutefois, ces systèmes risquent aussi de provoquer l’effet inverse, notamment en augmentant les taux d’erreur tout au long de la chaîne de ciblage et de frappe. Au cours d’une campagne de frappes de 40 jours contre l’Iran ce printemps, l’armée américaine a déclaré avoir atteint plus de 13 000 cibles, un rythme d’opérations quasi impossible à tenir avant l’avènement de l’IA.
L’IA pourrait également compliquer l’identification des défaillances et entraver l’obligation de rendre des comptes. À la suite d’une enquête d’Airwars sur une série de frappes assistées par l’IA ayant tué un étudiant irakien, l’armée américaine a déclaré n’avoir « aucun moyen de savoir » si la frappe meurtrière avait reposé sur l’IA.
Le livre Project Maven (voire notre critique), consacré à l’IA militaire américaine a révélé que, dans certaines opérations, seules deux des six étapes de la chaîne de ciblage et de frappe impliquent désormais une intervention humaine directe, une troisième nécessitant une certaine supervision humaine. Les autres étapes sont aujourd’hui entièrement automatisées. »
Dans une interview pour Democracy Now, Heidy Khlaaf, directrice scientifique chargée de l’IA à l’AI Now Institute et responsable de la publication avec AIrwars de cette fiction explicative, rappelle que derrière ces systèmes automatisés il n’y a pas de robot tueur, mais des chaînes de systèmes algorithmiques qui ont tous leurs propres pièges et leurs propres défauts. « Ils présentent tous une fiabilité et une précision très faibles. Ces systèmes s’appuient les uns sur les autres et s’alimentent mutuellement pour aboutir, malheureusement, à des pertes civiles, comme nous l’avons souvent constaté lors de leur utilisation. » « La distinction entre systèmes autonomes et systèmes de soutien est assez superficielle en pratique ». En réalité, quand on utilise ces systèmes, les biais d’automatisation sont très forts, rappelle-t-elle : tout y est présenté comme un risque. C’est le cas par exemple des systèmes de traduction automatisés, comme l’a montré une enquête d’Associated Press, qui montrait que l’usage de systèmes de traduction avaient du mal avec l’arabe. Prendre un mot pour un autre peut suffire pour vous inscrire sur une liste de personnes cibles. « Il est très difficile de comprendre pourquoi une IA a pris une décision donnée lorsqu’il s’agit de grands modèles de langage, en raison de leur envergure et de leur mode de fonctionnement. Était-ce dû à des données erronées ? L’IA a-t-elle reçu des instructions en ce sens ? S’agissait-il d’hallucinations ? Quiconque a utilisé ChatGPT sait que ces agents conversationnels inventent souvent des informations. C’est, je pense, la situation dans laquelle nous nous trouvons actuellement. La cause exacte de ces événements reste incertaine. En fait, je dirais même que c’est là l’une des finalités des systèmes d’IA : ils servent souvent à diluer la responsabilité », comme le pointait très bien le sociologue Ori Schwarz également (voir notre article).
« En fin de compte, ces entreprises sont en train de réinventer la notion de sécurité. Elles s’approprient bon nombre de termes traditionnellement utilisés dans l’ingénierie de la sûreté et de la sécurité pour les appliquer à des formes de sécurité différentes. Au lieu de se demander : « Nos systèmes sont-ils fiables ? Sont-ils précis ? Fonctionnent-ils comme prévu ? Sont-ils adaptés à leur usage, de sorte qu’aucun être humain ne subisse de préjudice du fait des décisions ou des recommandations qu’ils génèrent ? » Au lieu de cela, nous nous retrouvons avec des cadres relatifs à la sécurité et à l’éthique qui portent sur des questions telles que l’autonomie, l’intentionnalité ou la conscience de ces systèmes. Or, il s’agit là d’une question tout à fait différente. Ces systèmes peuvent souvent donner l’illusion de posséder ces caractéristiques, ce qui conduit à anthropomorphiser le langage ou les actions de ces modèles. Nous avons vu récemment, par exemple, les capacités de cybersécurité être présentées comme si ces systèmes étaient autonomes – comme s’ils agissaient de leur propre chef, ce qui correspondrait à une attente que nous aurions à leur égard. Pourtant, dans la réalité, ces entreprises les déployaient dans des environnements très peu sécurisés et amenaient délibérément ces modèles à mener des cyberattaques dans le cadre de tests ou d’évaluations comparatives. »
« C’est précisément ce qui me pose problème : ces entreprises tentent, une fois de plus, d’attribuer la responsabilité à l’IA plutôt qu’à elles-mêmes. Or, l’IA ne fait que ce que nous lui ordonnons de faire ; elle n’est capable que de ce pour quoi nous l’avons conçue. »
« Il est donc crucial de garder à l’esprit que, certes, ces systèmes sont performants. Oui, ils sont capables de mener des actions telles que des cyberattaques ou des frappes. Et ils accélèrent effectivement les opérations ; c’est indéniable. C’est même l’une de leurs caractéristiques fondamentales. Toutefois, si l’on dispose d’un outil qui accélère les opérations mais dont la fiabilité et la précision de base se situent entre 30 et 60 %, le résultat ne diffère guère d’un ciblage aveugle, n’est-ce pas ? » Nous ne sommes pas confrontés à des robots tueurs dotés d’intentions propres, mais à une conception délibérée, défaillante, produite par des personnes qui « décident de le déployer, en toute connaissance de cause des systèmes à la fiabilité et à la précision médiocres – surtout dans des situations inédites, un cas de figure plus probable encore en temps de guerre que lors de cyberattaques.»
- Persos A à L
- Carmine
- Mona CHOLLET
- Anna COLIN-LEBEDEV
- Julien DEVAUREIX
- Cory DOCTOROW
- Lionel DRICOT (PLOUM)
- EDUC.POP.FR
- Marc ENDEWELD
- Michel GOYA
- Hubert GUILLAUD
- Gérard FILOCHE
- Alain GRANDJEAN
- Hacking-Social
- Samuel HAYAT
- Dana HILLIOT
- François HOUSTE
- Tagrawla INEQQIQI
- Infiltrés (les)
- Clément JEANNEAU
- Paul JORION
- Christophe LEBOUCHER
- Michel LEPESANT
- Persos M à Z
- Henri MALER
- Christophe MASUTTI
- Jean-Luc MÉLENCHON
- MONDE DIPLO (Blogs persos)
- Richard MONVOISIN
- Corinne MOREL-DARLEUX
- Timothée PARRIQUE
- Thomas PIKETTY
- VisionsCarto
- Yannis YOULOUNTAS
- Michaël ZEMMOUR
- LePartisan.info
- Numérique
- Thomas BEAUFILS
- Blog Binaire
- Christophe DESCHAMPS
- Dans les Algorithmes
- Louis DERRAC
- Olivier ERTZSCHEID
- Olivier EZRATY
- Framablog
- Fake Tech (C. LEBOUCHER)
- Romain LECLAIRE
- Tristan NITOT
- Francis PISANI
- Irénée RÉGNAULD
- Nicolas VIVANT
- Collectifs
- Arguments
- Scientifiques en Rebellion
- Bondy Blog
- Dérivation
- Économistes Atterrés
- Dissidences
- Mr Mondialisation
- Palim Psao
- Paris-Luttes.info
- Rojava Info
- X-Alternative
- Créatifs / Art / Fiction
- Nicole ESTEROLLE
- Julien HERVIEUX
- Alessandro PIGNOCCHI
- Laura VAZQUEZ
- XKCD