
14.10.2026 à 16:19
Santé mentale des adolescents et mobilisations lycéennes, des causes communes ?
Maria Melchior, Epidémiologiste, Directeur de recherche, Inserm; Sorbonne Université
Camille Davisse-Paturet, Chercheure contractuelle, Inserm; Sorbonne Université
Texte intégral (2530 mots)
L’ESSENTIEL
À l’heure des mobilisations lycéennes, on peut s’interroger sur les liens entre les conditions de scolarité et la santé mentale des jeunes.
Des études objectivent les difficultés psychologiques que connaissent nombre de jeunes, dès le collège, les filles davantage que les garçons.
Ces données peuvent être mises en regard de résultats qui documentent leur ressenti concernant leur scolarité (pression, impact de Parcoursup, classes surchargées…).
Depuis la mi-septembre 2026, des dizaines de milliers de lycéens et étudiants se mobilisent en France pour réclamer des améliorations de leurs conditions d’enseignement : davantage de professeurs remplaçants, des emplois du temps plus adaptés à leurs besoins, un bâti en bon état, et une refonte du système d’affectation dans l’enseignement supérieur – Parcoursup, pointant les inégalités sociales au sein du système d’enseignement secondaire et à l’université.
À lire aussi : « Vous pouvez nous prendre le téléphone, mais pas la parole » : le mouvement lycéen et le sentiment de ne pas être écouté
Leurs revendications illustrent un ressenti de pression scolaire et d’anxiété, attribué à un environnement d’apprentissage peu favorable au bien-être psychologique. Que nous disent les études sur ce sujet ? Comment va la santé mentale des jeunes en France, et quels liens avec leurs conditions de scolarité ?
Des enquêtes sur les difficultés psychologiques des collégiens et lycéens
La santé mentale des adolescents est décrite depuis les années 2000 au travers des enquêtes HBSC (Health behavior in School-Aged Children) et ESPAD (European School Survey Project on Alcohol and Other Drugs), rassemblées depuis 2018 sous la forme de l’enquête EnCLass. Édition après édition, celles-ci montrent un niveau élevé de difficultés psychologiques.
L’adolescence est par définition une période de transformation psychique, corporelle, sociale et le fait qu’elle soit synonyme de difficultés psychiques pour certains et certaines jeunes est connu.
Néanmoins, les résultats du suivi populationnel construit au travers de l’enquête Enclass montrent une évolution défavorable accélérée par la pandémie de Covid-19 – si, pendant les confinements toute la population était deux fois plus anxieuse et plus déprimée qu’auparavant, les adultes sont revenus à des niveaux de symptômes plus habituels après la fin de la pandémie. Pas les jeunes.
D’après les dernières données d’EnClass recueillies en 2024, 45 % des collégiens (scolarisés en sixième, cinquième et quatrième) rapportent au moins une plainte psychologique (déprime, irritabilité ou nervosité) plus d’une fois par semaine depuis au moins six mois, 32 % déclarent ressentir de la nervosité, 29 % de l’irritabilité et 21 % un sentiment de déprime.
Ce type de difficultés psychologiques est systématiquement plus élevé chez les filles et augmente avec l’âge. Chez les garçons, les niveaux de détresse psychologique semblent être en léger recul par rapport à l’édition EnClass 2022.
Chez les lycéens, la situation s’est plutôt détériorée : 19 % des lycéens ont un risque important de dépression, 20 % déclarent avoir eu des pensées suicidaires au cours des 12 mois précédents, 15 % ont fait une tentative de suicide à un moment de leur vie.
Chez l’adulte, des épisodes dépressifs et troubles anxieux plus fréquents entre 18 et 29 ans
Les difficultés psychologiques peuvent persister après la fin de la scolarité dans l’enseignement secondaire. Le Baromètre de Santé publique France révèle qu’en 2024, les jeunes de 18 à 29 ans sont le groupe d’adultes le plus touché par des épisodes dépressifs caractérisés – une personne sur cinq (21 %) était concernée au cours des 12 mois précédant l’enquête, près de 7 % rapportant un épisode dépressif sévère.
De manière similaire, le trouble anxieux généralisé est aussi plus fréquent chez les jeunes de 18 à 29 ans que dans d’autres groupes de la population : 8 % sont concernés.
Enfin, les jeunes de 18 à 29 ans sont aussi le groupe déclarant le plus de pensées suicidaires (8,6 % dans les 12 mois précédant l’étude) et de tentatives de suicide (6,7 % en ont déjà fait une au cours de leur vie). Ce dernier résultat est surprenant dans la mesure où les tentatives de suicide sont cumulatives et où les taux devraient augmenter avec l’âge.
Il pourrait indiquer que les jeunes, particulièrement concernés par des gestes suicidaires, s’en souviennent mieux que d’autres groupes. Un effet générationnel pourrait aussi exister, avec des jeunes nés au début des années 2000 plus touchés par des comportements suicidaires que des générations antérieures pour des raisons multiples – dégradation de l’état de santé mentale, augmentation de la pauvreté, influence de contenus diffusés sur les réseaux sociaux – il ne pourra être confirmé qu’à plus long terme.
La santé mentale des jeunes dégradée depuis le Covid-19
Les données de recours aux soins examinées confirment une dégradation de la santé mentale des jeunes depuis la pandémie de Covid-19 : en 2024, les jeunes filles de 11-17 ans et l’ensemble des jeunes de 18-24 ans étaient les groupes au sein desquels les recours aux urgences pour des gestes auto-infligés, dont des tentatives de suicide, étaient les plus élevés, les niveaux étant relativement stables depuis 2021.
Le taux d’hospitalisations pour des gestes auto-infligés était par contre plus élevé en 2024 qu’au cours des trois années antérieures, avec des niveaux particulièrement élevés chez les jeunes filles de 11-17 ans et les 18-24 ans des deux sexes.
Santé mentale des jeunes : le Covid-19 et les inégalités socioéconomiques en cause ?
Plus de cinq ans après la fin de la pandémie de Covid-19, les difficultés psychiques des adolescents et des jeunes adultes sont donc à des niveaux élevés en France, une tendance observée également dans d’autres pays. Le contexte de conflits armés en Ukraine et au Moyen-Orient, le changement climatique, et les contenus véhiculés par les réseaux contribuent certainement à ces niveaux de mal-être.
Mais l’aggravation des inégalités sociales pourrait également jouer également un rôle : en France, le taux de pauvreté est passé de 14 % de la population en 2016 à 15,4 % en 2024, c’est-à-dire le niveau le plus élevé depuis 30 ans, un niveau élevé toutefois équivalent à la moyenne de l’Union européenne. Le groupe le plus touché par la pauvreté – 30 % des personnes – est les familles monoparentales, au sein desquelles grandissent environ 25 % des adolescents en France.
À lire aussi : Pourquoi la souffrance psychique des jeunes n’est pas une affaire individuelle
Pression, climat en classe, réforme du bac… quels impacts des conditions de scolarité ?
À côté de ces déterminants sociétaux et macro-économiques, quel est le rôle du contexte scolaire ? Les jeunes invoquent régulièrement le stress lié à Parcoursup, le système d’affectation dans l’enseignement supérieur qui se base sur les résultats obtenus au cours des deux dernières années de lycée.
La pression scolaire, sur fond d’inquiétudes plus larges concernant l’avenir scolaire et professionnel, fait partie des facteurs de stress pouvant augmenter le risque de symptômes d’anxiété et de dépression chez les jeunes. L’étude internationale Health Behavior in School-Aged Children (HBCS) menée sous l’égide de l’Organisation mondiale de la santé en Europe (OMS), en Asie Centrale et au Canada, montre que les élèves français ne sont pas ceux qui s’en plaignent le plus.
En revanche, ils font partie de ceux qui ont connu une évolution peu favorable au cours des dernières années, surtout les jeunes filles. En 2014, 40 % des jeunes filles de 15 ans en France rapportaient une forte pression scolaire, elles étaient 60 % 8 ans plus tard.
La pression peut venir des programmes scolaires à couvrir et des modes d’évaluation. Elle peut aussi refléter les conditions d’apprentissage et la possibilité pour les élèves de recevoir le soutien dont ils ont besoin de la part de leurs enseignants.
Les adolescents français se distinguent aussi par des niveaux de confiance dans leurs enseignants plus bas que la moyenne : 35 % des élèves de 15 ans disent être soutenus par leurs enseignants, par rapport à 42 % en moyenne. En parallèle, ils sont 48 %, par rapport à une moyenne de 53 %, à déclarer se sentir soutenus par leurs camarades.
Les enquêtes PISA (Programme international pour le suivi des acquis des élèves) confirment ces résultats – en 2022, 18 % des élèves français de 15 ans indiquaient que les professeurs ne s’intéressaient pas à la réussite de chacun des élèves, par rapport à 11 % en moyenne. Par ailleurs, la moitié des élèves français se plaignaient du bruit et de l’agitation en classe, et la France figurait dans la fourchette haute des pays dont les élèves avaient tendance à avoir moins confiance en eux et déclaraient plus fréquemment avoir peur de l’échec.
Ces tendances peuvent être rapprochées de l’augmentation du nombre d’élèves par classe au lycée d’enseignement général et technologique, de 27 par classe en 1990 à plus de 30 en 2023. On peut aussi s’interroger sur l’impact de la réforme du baccalauréat de 2018 qui, en supprimant les séries, a peut-être individualisé les parcours scolaires et éclaté les groupes classes, en isolant les élèves et en rendant plus difficile la possibilité de trouver du soutien auprès de leurs camarades. Une hypothèse sur laquelle devraient se pencher de futurs travaux de recherche pour l’infirmer ou la confirmer.
Prendre aussi en compte la baisse relative des moyens de l’enseignement
La pression scolaire vient aussi de la perception de ce qui se passe après le lycée. Si, en 2024, près de huit bacheliers sur dix ont poursuivi leurs études dans l’enseignement supérieur, environ 35 % des étudiants inscrits en licence seulement décrochent un diplôme en trois ans et 55 % quittent l’université sans diplôme, ces taux étant respectivement de 45 et 40 % dans l’Union européenne.
Enfin, si la France investit en moyenne autour de 15 000 dollars US par élève (ce qui équivaut actuellement à environ 13500 euros) tout au long de sa scolarité, ce qui correspond à environ 5 % du produit intérieur brut, des montants comparables aux moyennes observées dans les pays de l’OCDE, cet investissement est resté stable entre 2015 et 2022, alors que le nombre d’étudiants a augmenté de 20 % au cours de la même période. Ceci s’est traduit par une diminution relative de la part des financements publics pour l’enseignement supérieur, passé de 80 % en 2015 à 75 % en 2022.
Cette baisse relative des moyens investis dans l’enseignement secondaire et supérieur pourrait se traduire par la dégradation des conditions d’apprentissage constatées par les élèves – professeurs non remplacés, baisse de l’attractivité des concours d’enseignants entraînant l’emploi d’enseignants contractuels peu formés, problèmes d’affectation des milliers de bacheliers faute de places dans l’enseignement supérieur.
La santé mentale des jeunes est directement liée aux environnements dans lesquels ils grandissent, physiques et virtuels, et le système scolaire dans lequel ils évoluent influe indéniablement sur leur vécu, le niveau de stress, et le sentiment d’injustice et d’inquiétude que nombre d’entre eux expriment.
Les raisons pour lesquelles les lycéens se mobilisent pourraient bien être, au moins en partie, les mêmes que celles pour lesquelles leur santé mentale s’est dégradée au cours des dernières années.

Maria Melchior est adhérente de la FCPE (association de parents d’élèves) et membre du conseil d'administration de l’Ecole des Parents et des Educateurs. Elle a reçu des financements de l’Union européenne, de l’Agence Nationale de la Recherche, et de l’Institut national du cancer.
Camille Davisse-Paturet a reçu des financements de l'Institut pour la Recherche en Santé Publique (IReSP).
14.10.2026 à 16:17
Can AI feel safer than human advice for consumers who face discrimination?
Arash Talebi, Professeur assistant, EDHEC Business School
Sylvain Riffe-Stern
Texte intégral (1699 mots)
KEY TAKEAWAYS
A study highlights that consumers who have experienced discrimination are more likely to turn to AI-based recommendations rather than human advice.
The fear of being judged or feeling embarrassed can lead people to use AI.
If AI systems are themselves biased, they risk exacerbating the very discrimination that consumers were trying to escape.
What should you cook for dinner on a budget of 20 euros when you have a guest with a gluten intolerance? A shopper might ask a shop assistant for advice or consult, for example, Hopla, the AI-powered shopping assistant launched by French supermarket chain Carrefour. Behind this very ordinary everyday choice lies a broader question: when faced with a recommendation, who do we trust more? A human being or an AI?
Recent research – on decision-making processes, the impact of errors, etc. – has highlighted a clear and well-established trend: people tend to prefer other people (as opposed to AI systems). This phenomenon, known as “algorithm aversion”, has been widely documented, even when algorithms objectively demonstrate better performance.
However, this preference is not universal. Our research highlights that it can be reversed in a common context: in facing discrimination on platforms and offline in services ranging from car dealership to financial consultancy. More specifically, consumers who are victims of discrimination – particularly in public places – are significantly more likely to turn to AI-based recommendations rather than human advice even in a subsequent domain fully independent of the discrimination domain!
What is the emotional mechanism behind this shift? Embarrassment. When people feel socially judged or treated unfairly because of an irrelevant personal attribute, they seek refuge in systems perceived as “neutral and free from bias”.
How does this mechanism work? What does this mean for the organisations concerned? And what does it reveal about the hidden drivers behind the adoption of AI?
Implicit discrimination
Discrimination in consumer contexts is by no means rare. Studies show that certain groups face less favourable conditions than others when it comes to similar services, for example in terms of access to credit or insurance. Beyond their economic consequences, these experiences have significant psychological repercussions. They increase stress, undermine the sense of fairness, and influence future behaviour.
It is important to clarify what discrimination means in a market context. A market, in the broadest sense, refers to any setting where consumers interact with service providers, be it a car dealership, a restaurant, a bank or a healthcare platform. Within these spaces, differential treatment is not inherently discriminatory. For example, a VIP customer receiving premium service is treated differently on the basis of a relevant commercial criterion.
Discrimination, however, occurs when the factor used to differentiate is irrelevant and illegitimate, such as skin colour, ethnic origin, or gender. What makes it particularly insidious is that it can be hidden, implicit or even unintentional, whilst causing real psychological harm to those who suffer it.
An AI system ‘devoid of emotions’
As part of a field studywe conducted under real-world conditions, “agents” – who were in fact people involved in the research project (i.e. confederates) – assessed loan applications on a university campus using almost identical questionnaires; almost because one version of the questionnaire included an additional question asking participants to self-assess their skin colour (an element by design to evoke discriminatory feelings).
All applicants were subsequently rejected; those who had been asked the question about skin colour reported feeling that they had been discriminated against (phase 1). During the follow-up data collection, carried out at a later date, all participants were offered the choice between a human assessor and an AI assessor (phase 2).
A significantly higher proportion of those who felt they had been discriminated against in the first phase (compared with those who did not feel they had been discriminated against in that same phase) chose, in the second phase, to be assessed by the AI system, perceived to be “devoid of emotions and biases”.
Feeling of embarrassment
Consumers who have experienced discrimination appear significantly more likely to rely on AI-based recommendations than on human advice. In other words, aversion to algorithms can turn into a preference for them, also known as “algorithm appreciation”. This shift can be explained by a specific psychological mechanism: embarrassment. This social emotion arises when individuals feel they are being judged negatively by others.
In our experiments, participants exposed to discriminatory situations reported higher levels of embarrassment, and this emotion directly influenced their subsequent choices. The more embarrassed they felt, the more they sought to limit human interactions.
In this context, AI appears to be a safer alternative.
#AI is perceived as being more neutral
Compared to human beings, algorithmic systems are perceived as more neutral, more objective and less prone to bias or prejudice.
The reality is more complex. Algorithms can be biased, depending on the data and training they receive. Yet many people continue to regard them as neutral and objective. In this context, it is these perceptions that matter most. Opting for AI allows consumers to reduce the risk of feeling that they are once again being judged or treated unfairly. This effect depends on the context in which decisions are made. We find that it is particularly pronounced in public situations, when choices are visible to others. By contrast, when decisions are made in private, this effect (i.e. preference for AI systems vs. human ones) weakens considerably.
Previous social experiments
These findings shed new light on the adoption of AI. They suggest that the use of automated systems is driven not only by considerations of efficiency or performance, but also by psychological needs shaped by past social experiences.
For businesses, the implications are significant. In sectors where interactions may be perceived as sensitive – such as banking, healthcare, or customer service in general – offering AI-based alternatives can help some consumers feel more at ease. For these individuals, AI is not merely a technological tool; it becomes a means of escaping social judgement and regaining control following negative experiences.
At the same time, these findings come with an important caveat: if AI systems are themselves biased – trained on biased data or designed without regard for equity – they risk reproducing, or even amplifying, the very discrimination that consumers were trying to escape. Even more seriously, this type of discrimination often goes unnoticed because it is hidden and difficult to detect. The roll-out of AI as a “safe” alternative only makes sense if that safety is real, and not merely perceived.
As AI becomes increasingly integrated into everyday life, understanding these mechanisms will be essential for designing more inclusive and adaptive customer experiences.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
14.10.2026 à 12:17
Replay : les défis de la recherche en zone de conflit
Grégory Rayko, Chef de rubrique International, The Conversation
Lire + (242 mots)
Dans ce webinaire organisé par Normandie pour la Paix et The Conversation France, trois spécialistes partagent leur expérience du terrain, de l’Afghanistan à l’Ukraine, en passant par le Haut-Karabakh.
Comment mener des recherches dans ces contextes ? Comment faire face aux difficultés rencontrées sur place et au retour ? Comment maintenir les liens avec les personnes rencontrées et partager les résultats de ses recherches ?
Pour en discuter, trois spécialistes croisent leurs expériences : Pierre Micheletti, médecin, écrivain et universitaire, président d’honneur d’Action contre la Faim et président de SOS Méditerranée ; Anita Khachaturova, docteure de l’Université libre de Bruxelles et spécialiste du Caucase du Sud ; et Romain Huët, ethnographe à l’Université Rennes 2, ayant travaillé en Syrie et en Ukraine en temps de guerre.
Un webinaire animé par Grégory Rayko, chef de la rubrique International de The Conversation France.

14.10.2026 à 11:58
Et si les éléments indispensables au développement de la vie étaient présents sur Terre depuis bien plus longtemps qu’on ne le pensait ?
Ingrid Blanchard, Chargée de recherche CNRS, Centre national de la recherche scientifique (CNRS); Sorbonne Université
Texte intégral (909 mots)
L’ESSENTIEL
Depuis les années 1970, on pensait que la Terre avait connu un épisode d’apport tardif de matériel par l’intermédiaire des météorites : la théorie du « vernis tardif ».
Une nouvelle étude vient remettre en cause cette théorie.
Ce résultat permet une nouvelle vision de l’accrétion de la Terre, de la Lune et des autres planètes telluriques du système solaire.
La Terre s’est formée il y a 4,5 milliards d’années, par une succession de collisions entre des météorites. Il a été proposé dans les années 1970 que la Terre ait connu un épisode d’apport tardif de matériel par l’intermédiaire des météorites (aussi appelé « vernis tardif » ou late veneer, en anglais) à la fin de sa formation.
En effet, les scientifiques avaient alors observé que le manteau terrestre présentait des teneurs en certains éléments (les éléments hautement sidérophiles, avec une forte affinité pour le fer, tels que l’or et le platine) qui ne semblaient pouvoir être expliquées que par une arrivée tardive de météorites, une fois la planète refroidie. Cet apport de matériel afin d’expliquer les abondances en éléments hautement sidérophile du manteau terrestre a été utilisé afin de proposer que les éléments indispensables au développement de la vie tels que le carbone et l’hydrogène aient été apportés au même moment. Cette hypothèse permettait donc de résoudre deux des grandes questions de la géochimie simultanément.
Notre étude, publiée dans Science Advances, propose un autre scénario dans lequel les conditions extrêmes qui régnaient lors de la formation de la Terre permettent d’expliquer les teneurs en éléments hautement sidérophiles du manteau, sans avoir recours à un apport tardif massif de matériel. Si le vernis tardif n’a pas lieu, ou n’est pas aussi abondant que proposé précédemment, il devient difficile d’expliquer l’arrivée sur Terre des ingrédients nécessaires au développement de la vie par ce biais. Ainsi, notre étude propose, par extension, que ceux-ci aient été présents sur Terre dès le début de la formation de notre planète.
Dans cette étude, nous avons recréé au laboratoire les conditions de pressions et de températures extrêmes de la différenciation terrestre, qui sont de l’ordre de plusieurs centaines de milliers de fois la pression atmosphérique et plusieurs milliers de degrés Celsius. En effet, lors de sa formation, notre planète était couverte d’un océan magmatique d’une profondeur de plus de 1 500 kilomètres au sein duquel les éléments chimiques se sont séparés en fonction de leurs affinités pour le métal ou le magma. C’est ainsi que se sont formés les deux principaux réservoirs terrestres que sont le noyau métallique et le manteau silicaté. Cette différenciation noyau-manteau, qui a duré plusieurs dizaines de millions d’années, est fondamentale dans l’histoire de la Terre, car une fois achevée, les échanges chimiques ne sont plus possibles.
Pour reproduire les conditions de la formation terrestre, nous avons utilisé des cellules à enclumes de diamants couplées à un chauffage laser. L’analyse des échantillons synthétisés a mis en évidence le rôle prépondérant de la température sur le partage entre le noyau et le manteau des éléments hautement sidérophiles étudiés (l’or, le rhénium, le palladium, l’iridium et l’osmium). En effet, aux conditions de la formation du noyau terrestre, ces éléments sont bien moins sidérophiles, et voient leur affinité pour les silicates augmenter. En utilisant des modèles numériques de formation de la Terre, cette étude montre que les teneurs mantelliques de ces éléments peuvent être expliquées par les effets de hautes températures qui avaient lieu lors de la différenciation terrestre.
Ce résultat permet une nouvelle vision de l’accrétion de la Terre, de la Lune et des autres planètes telluriques du système solaire sans faire appel à un important vernis tardif. Il s’agit d’une avancée majeure, car le vernis tardif avait été proposé depuis plusieurs décennies comme vecteur d’éléments volatils indispensables au développement de la vie. Nous proposons donc que les éléments tels que l’eau et le carbone aient été présents très tôt dans l’histoire de la Terre, et non apportés une fois la différenciation terminée.

Ingrid Blanchard a reçu des financements de la Deutsche Forschungsgemeinschaft, de European Union’s Horizon 2020 research and innovation program
14.10.2026 à 10:57
Quand les machines apprennent à lire nos émotions, ou l’essor de l’« informatique affective »
Charlotte De Sainte Maresville, Postdoctoral research, Université Bretagne Sud (UBS)
Texte intégral (1245 mots)
Imaginez un ordinateur capable de percevoir que vous êtes fatigué, frustré ou enthousiasmé, et d’adapter son comportement en conséquence. C’est exactement ce que promet l’« informatique affective ». Ce champ de recherche désigne l’ensemble des technologies conçues pour détecter, interpréter et simuler les émotions humaines. En d’autres termes : des systèmes en mesure de capter nos états intérieurs afin de mieux interagir avec nous.
L’expression « informatique affective » est née en 1997, sous la plume de Rosalind Picard, chercheuse au MIT. Dans son ouvrage fondateur, elle pose une question simple en apparence : pourquoi les ordinateurs, si puissants pour traiter de l’information, sont-ils si maladroits face aux émotions humaines ? Picard fait le pari que des machines capables de reconnaître et d’exprimer des affects pourraient devenir de bien meilleurs partenaires pour les êtres humains.
Le mot « affective » est emprunté à la psychologie, où il désigne tout ce qui relève de l’affect, du ressenti, des états émotionnels. Accolé à « informatique », il crée une tension productive : celle d’une discipline qui cherche à mettre le calcul au service de ce qu’il y a de plus imprévisible chez l’être humain.
Comment ça fonctionne concrètement ?
Les systèmes d’informatique affective s’appuient sur plusieurs types de signaux. Le plus répandu est l’analyse des expressions faciales : des caméras capturent les micromouvements du visage, que des algorithmes traduisent en émotions supposées (joie, surprise, tristesse, colère…).
Ces catégories d’émotions « de base » ont été théorisées dès les années 1990 par le psychologue Paul Ekman, dont les travaux ont largement inspiré les systèmes actuels de reconnaissance faciale. Mais d’autres canaux sont également exploités pour analyser les émotions : le ton de la voix, le rythme cardiaque, les mouvements du corps ou encore les variations de la conductance électrique de la peau, indicateur physiologique du stress.
Ces données sont captées en temps réel à travers les capteurs intégrés à nos appareils : la caméra de l’ordinateur, le microphone du téléphone ou les capteurs physiologiques d’une montre connectée. Elles sont ensuite traitées par des modèles d’apprentissage automatique entraînés à reconnaître des configurations récurrentes associées à des états émotionnels.
Concrètement, ces modèles ont été exposés à des milliers, parfois des millions d’exemples : une position précise de sourcils correspond à de la surprise, un tremblement de voix à de l’anxiété et une accélération du rythme cardiaque à du stress. Le système apprend à associer ces configurations à une émotion, puis applique ce qu’il a appris à de nouvelles situations.
En d’autres termes, le système ne « ressent » rien : il calcule des probabilités. Il estime, à partir de signaux mesurables, que vous exprimez très probablement de la satisfaction ou que vous semblez concentré plutôt qu’ennuyé.
À lire aussi : Souriez, vous êtes filmés : ce que l’« emotion AI » voit vraiment sur nos visages
Des usages déjà bien présents dans notre quotidien et des applications plus inattendues
L’informatique affective s’est glissée dans des outils que beaucoup d’entre nous utilisent au quotidien, parfois sans le savoir.
Par exemple, les plateformes de visioconférence intègrent désormais des modules capables d’analyser l’attention des participants. Certains outils de formation en ligne s’en servent pour ajuster le rythme d’un cours en fonction de l’engagement détecté chez les apprenants. Les assistants vocaux, eux, commencent à moduler leurs réponses selon le ton perçu dans la voix de l’utilisateur.
Au-delà des réunions en ligne, l’informatique affective investit des domaines plus surprenants. Dans le secteur automobile, des systèmes embarqués détectent la somnolence du conducteur à partir de l’analyse de son regard, déclenchant une alerte avant qu’un accident ne survienne (le dispositif GSR2 rend obligatoire un système de surveillance active de l’attention du conducteur dans les véhicules neufs depuis juillet 2026).
Dans le domaine culturel, des musées expérimentent des installations qui s’adaptent aux réactions émotionnelles des visiteurs. C’est le cas du musée Munch à Oslo (Norvège), qui a co-développé avec des chercheurs une expérience dans laquelle un système d’informatique affective analyse les expressions faciales des visiteurs devant les œuvres et leur remet en souvenir une carte postale visualisant leurs données émotionnelles.
Dans la santé, des outils thérapeutiques aident des patients atteints de troubles de la communication à mieux déchiffrer les signaux émotionnels de leur entourage. C’est notamment le cas pour les enfants autistes, pour lesquels des robots sociaux intégrant des technologies de reconnaissance des émotions ont été développés afin d’améliorer leurs interactions sociales.
Ce que ce terme dit de notre époque
Si l’expression « informatique affective » commence à entrer dans le langage courant, c’est parce qu’elle reflète une transformation profonde de notre rapport aux machines. Né dans les laboratoires de recherche à la fin des années 1990, le concept a longtemps circulé dans les seules sphères académiques. Pendant longtemps, le grand public considérait l’ordinateur était un outil purement logique : on lui donnait des instructions, il exécutait. Avec l’informatique affective, la machine devient un interlocuteur capable de tenir compte de notre humeur, de notre niveau de fatigue, de notre engagement.
Ce glissement dit quelque chose d’essentiel sur nos attentes vis-à-vis des technologies : nous ne voulons plus seulement qu’elles soient efficaces, nous voulons qu’elles soient attentives. L’informatique affective est le nom donné à cette ambition, celle de machines qui cherchent à s’adapter à l’humain qui se trouve en face d’elles, déplaçant une frontière que l’on croyait stable : celle qui sépare le monde du calcul du monde du ressenti.
La série « L’envers des mots » est réalisée avec le soutien de la délégation générale à la langue française et aux langues de France du ministère de la culture.

Charlotte De Sainte Maresville a reçu des financements de ANR dans le cadre du projet France relance 2030.
14.10.2026 à 10:33
Un « espace liminal » entre les humains et l’IA : la frontière sera-t-elle moins discernable qu’on voudrait le croire ?
Ganesh Gowrishankar, Chercheur au Laboratoire d'Informatique, de Robotique et de Microelectronique de Montpellier, Université de Montpellier
Madalina Croitoru, Prefessor, Université de Montpellier
Texte intégral (2019 mots)
L’ESSENTIEL
Les outils étaient jusqu’à présent bien distincts de l’être qui les utilisait.
Aujourd’hui, l’émergence des systèmes d’intelligence artificielle grand public brouille les pistes : nos souvenirs et nos décisions sont souvent intimement liés à nos traces numériques tandis que les systèmes informatiques modernes se nourrissent de nos données.
Considérer un effacement progressif de cette frontière conceptuelle permet de changer les termes des débats et des réflexions autour de l’essor de l’IA.
Il existe quelque chose d’étrangement rassurant dans la manière dont nous continuons à parler de l’intelligence artificielle. Comme si la géométrie fondamentale de cette relation avait déjà été tracée une fois pour toutes. D’un côté, les êtres humains. De l’autre, les machines.
Pourtant, les machines deviennent plus rapides, plus convaincantes, plus autonomes ; les humains s’adaptent, résistent, ou finissent peut-être par s’effacer un peu. Mais la frontière qui sépare les deux demeure remarquablement peu interrogée, comme si sa permanence allait de soi.
Et pourtant, à mesure que nous vivons avec ces systèmes, quelque chose de plus ambigu commence à apparaître.
Une interaction avec les systèmes artificiels de plus en plus internalisée
La particularité de l’intelligence artificielle contemporaine réside précisément dans son refus de rester à l’extérieur de nous-mêmes.
Les outils d’autrefois occupaient une place relativement simple dans nos existences. Un marteau prolongeait la main. Un télescope étendait la portée du regard. Un ordinateur facilitait le calcul. On les utilisait tout en restant solidement ancré dans son identité propre.
L’intelligence artificielle vient troubler cet équilibre. Peu à peu, l’interaction cesse de paraître cognitivement extérieure. La mémoire se disperse dans des archives numériques auxquelles nous revenons sans cesse. Les décisions émergent d’une négociation continue avec des algorithmes capables d’anticiper nos préférences (à l’image des systèmes de recommandation déployés sur les grandes plateformes numériques) avant même que celles-ci ne se soient entièrement formées.
Les systèmes fondés sur le dialogue argumentatif illustrent cette transformation en intégrant les réactions de l’utilisateur dans un processus itératif de justification et de révision des recommandations : la réflexion peut désormais se déployer au travers d’échanges avec des agents conversationnels. En somme, la pensée humaine emprunte de plus en plus souvent des structures artificielles avant de revenir vers nous, subtilement transformée.
À lire aussi : Outil ou compagnon ? Comment nous parlons aux robots en dit long
Dans le même temps, les systèmes artificiels se nourrissent d’immenses quantités de traces de l’expérience humaine. Les modèles de langage y découvrent les multiples formes d’expression des émotions et acquièrent la capacité d’en interpréter les nuances. Ils en ont appris les indices linguistiques, les nuances affectives et les contextes d’expression, jusqu’à reconnaître des états émotionnels complexes dans les interactions textuelles. Ils assimilent les traces de l’expérience humaine sans jamais relever de l’expérience humaine elle-même.
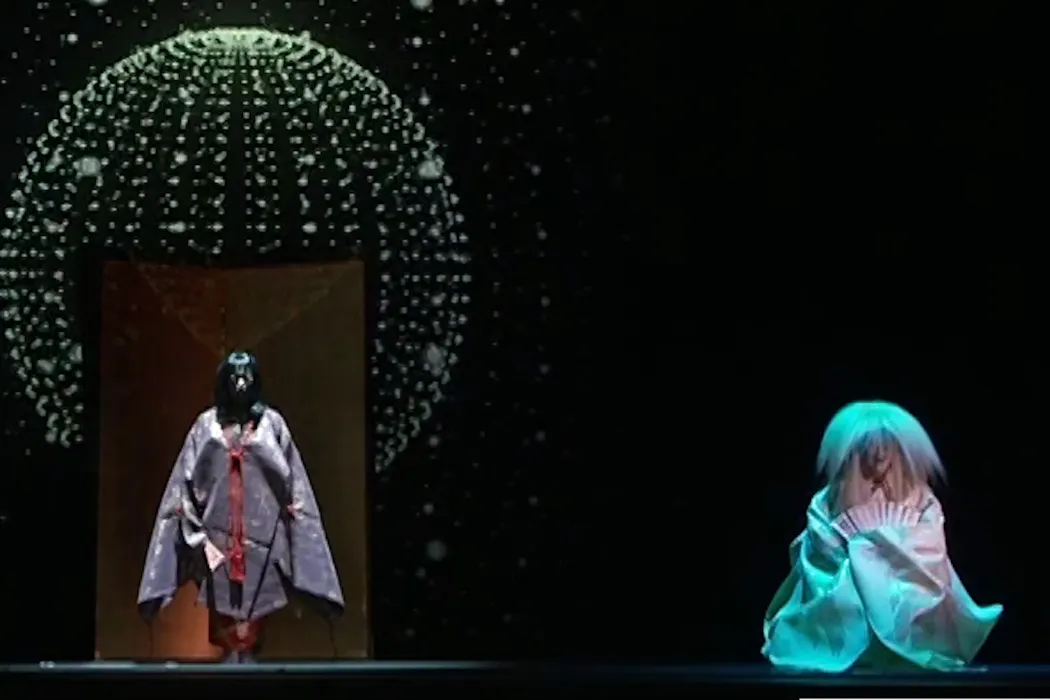
Ce qui apparaît alors est un « espace liminal » : un territoire où il n’y a ni fusion véritable ni séparation nette, mais un état intermédiaire, fluide, dans lequel les catégories qui structuraient autrefois nos interactions perdent progressivement leur évidence.
L’humain devient partiellement artificiel à travers l’externalisation graduelle de sa cognition, de sa perception et de son action. La machine, quant à elle, absorbe le langage, les mouvements, les comportements et les affects humains au fil même de l’interaction. Autour d’eux, l’environnement commence lui aussi à se transformer, acquérant une nature hybride qui lui est propre.
Aucune de ces catégories ne disparaît complètement. Mais aucune ne ressort intacte de la rencontre.
À lire aussi : Vous prendrez bien un sixième doigt ?

Les technologies d’augmentation des capacités humaines : au cœur de cette ambiguïté
Une personne munie d’une prothèse adaptative est accompagnée par un dispositif qui ajuste continuellement son comportement à ses mouvements et à ses intentions. Cette logique d’adaptation s’étend aujourd’hui aux prothèses motorisées du membre inférieur, capables d’ajuster leur assistance à la dynamique de la marche.
Au-delà de la compensation d’une fonction perdue, les robots portables prolongent le corps en lui offrant de nouvelles possibilités d’action, parfois au moyen de membres supplémentaires directement contrôlés par l’utilisateur.
D’autres approches privilégient une collaboration étroite entre l’humain et des bras robotiques portés sur le corps afin d’assister l’exécution de tâches complexes.
Enfin, les systèmes cognitifs prédictifs exploitent les données produites en continu par l’utilisateur pour anticiper certains de ses états ou besoins et adapter leur fonctionnement en conséquence.
La pensée, le mouvement et la perception commencent à circuler simultanément entre des couches biologiques et artificielles. L’agentivité déborde progressivement les limites du corps pour se distribuer dans des systèmes qui anticipent, répondent et s’adaptent en retour. Et le cerveau, lentement, redéfinit ce qu’il considère comme faisant partie du corps et du soi.
Ce qui émerge n’est alors ni entièrement humain ni entièrement artificiel, mais une condition plus fluide, continuellement reconstruite à travers l’interaction avec la machine et l’environnement qui l’entoure.
Les machines transforment aussi notre environnement
La réalité virtuelle et la réalité augmentée offrent sans doute l’expression la plus visible de cette transformation de l’environnement. Dans ces univers immersifs, le corps demeure physique tandis que la perception s’ancre dans un monde généré computationnellement. La présence cesse de coïncider parfaitement avec l’espace matériel. L’environnement lui-même acquiert une qualité « liminale », suspendue quelque part entre réalité tangible et construction artificielle.
À lire aussi : Que sont les xénobots, ces robots biologiques qui bouleversent les frontières entre vivant et machine ?
Pourtant, une grande partie des discussions actuelles autour de l’intelligence artificielle continue de se concentrer sur l’intelligence, la conscience ou le remplacement de l’humain. Ces questions sont certes importantes, mais elles ne sont peut-être pas les plus profondes.
La transformation essentielle n’est pas dans un éventuel remplacement de l’humain
La transformation principale réside dans l’effacement progressif des frontières conceptuelles au moyen desquelles les sociétés modernes ont longtemps organisé leurs relations avec les machines et avec leur environnement.
Et c’est peut-être cela qui confère à l’intelligence artificielle contemporaine son étrange mélange de fascination et d’inquiétude. L’interaction ne modifie pas seulement nos habitudes ou nos comportements. Elle commence à déstabiliser les catégories mêmes à travers lesquelles nous avons traditionnellement compris ce que nous sommes, ce que sont nos machines et ce que sont les mondes que nous habitons.
Les collaborations futures entre psychologues, neuroscientifiques, informaticiens et artistes seront essentielles pour explorer cet espace liminal. Comprendre comment il transforme le cerveau humain, les comportements individuels et les dynamiques sociales constitue une étape nécessaire si nous souhaitons développer une intelligence artificielle conçue comme une entité de collaboration plutôt que comme une entité de compétition.
Les auteurs remercient Shotaru Oku et l’équipe d’Evision Tokyo pour leur collaboration artistique de longue date, marquée par la réalisation conjointe de spectacles et d’œuvres cinématographiques immersives, ainsi que pour les échanges qui ont enrichi les travaux présentés dans cet article.

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
14.10.2026 à 10:33
Pourquoi les petits chiens vivent-ils plus longtemps que les grands ? Un paradoxe à l’échelle du vivant
Sara Hoummady, DMV, PhD, Associate professor in ethology and animal nutrition, UniLaSalle
Léna Rousseau, Postdoctoral fellow, UniLaSalle
Texte intégral (1469 mots)
L’ESSENTIEL
Chez la plupart des animaux, les grandes espèces vieillissent plus lentement que les petites, le chien fait figure d’exception.
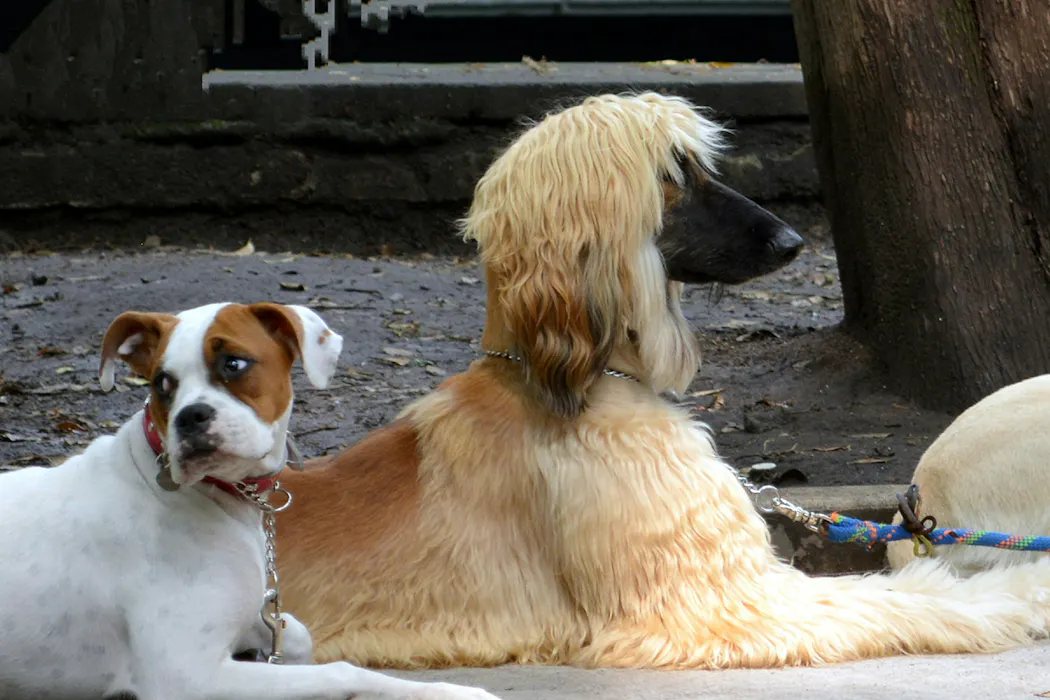
Un chihuahua peut souffler ses 16 bougies, alors qu’un dogue allemand ne dépasse que rarement les 10 ans.
Derrière cette simple observation se cache une véritable question scientifique. Quelles sont les principales pistes d’explication connues à ce jour ?
Le chien contredit une tendance du vivant : celle qui veut que les espèces de grande taille aient en général une espérance de vie plus longue. L’éléphant vit ainsi des décennies, tandis que le rat, lui, n’a qu’une espérance de vie de trois ans.
Chez le chien, les individus de petites races ont tendance à vivre plus longtemps que ceux de grandes races. Ce paradoxe est au cœur de nombreuses études en gériatrie canine, alors même qu’un médicament est actuellement testé aux États-Unis pour augmenter la longévité des chiens de grande taille.
Une relation claire entre la taille et la longévité
Une étude états-unienne portant sur plus de 2 millions de chiens, suivis par leur vétérinaire au moins deux fois entre janvier 2010 et décembre 2012, a permis d’observer que l’espérance de vie des chiens de taille géante (plus de 40,9 kg) était de 11,11 ans, contre 13,38 ans pour les grandes races (entre 22,7 kg et 40,9 kg), 13,86 ans pour les races de taille moyenne (entre 9,1 kg et 22,7 kg) et 14,95 ans pour les petites races (moins de 9,1 kg), avec une survie supérieure pour les chiens croisés (14,45 ans) comparés aux chiens de race pure (14,14 ans).
Bien que la taille reste un des facteurs importants, ce n’est pas le seul à intervenir. D’autres facteurs semblent jouer un rôle, comme la brachycéphalie (le fait d’avoir un nez très court, comme chez le carlin) ou encore le sexe et le statut reproducteur (stérilisé ou non) de l’individu. Ces tendances se retrouvent dans les bases de données d’autres pays.
Des profils de maladies différents selon la taille
Des données issues du Dog Aging Project apportent des éléments de réponse à ce phénomène. La taille semble associée à la survenue de maladies cutanées, de cancers ainsi qu’à des maladies infectieuses et orthopédiques. Les chiens de grande race sont ainsi plus à risque de certaines maladies chroniques, comme les cancers, tandis que les chiens de petite race développent plutôt des maladies cardiaques ou ophtalmologiques. Une étude se focalisant sur les cancers et leur malignité a mis en évidence que cette dernière augmente globalement avec la taille.
Ces premières données suggèrent une piste : les grandes races seraient plus à risque de certaines maladies mortelles. Mais cette hypothèse ne permet pas, à elle seule, d’expliquer cette différence.
Croissance et vieillissement : des pistes biologiques
Une autre piste est également explorée : celle de la croissance rapide des grandes races. Au cours de ses premiers mois de vie, un chiot dogue allemand passe de quelques centaines de grammes à la naissance, à plus de 50 kg en deux ans. Il s’agit d’une croissance très exigeante sur le plan biologique, comparée à celle d’un chihuahua.
Pour permettre cette croissance, l’organisme active fortement des mécanismes qui stimulent la production et la multiplication des cellules. L’un des principaux acteurs de cette croissance est l’IGF-1 (Insulin-like Growth Factor 1), une molécule proche de l’insuline. Ce facteur de croissance agit comme un signal ordonnant aux cellules de croître, de se multiplier et de fabriquer davantage de protéines. Ce mécanisme a été vérifié au sein de différentes espèces, de la souris à l’humain, il a été démontré qu’une signalisation élevée de l’IGF-1 était associée à une vie plus courte. Chez les chiens, les concentrations d’IGF-1 sont plus élevées chez les grandes races que chez les petites, ce qui crée une réelle différence au sein de la même espèce, une spécificité de l’espèce canine.
Cette croissance accélérée pourrait avoir un coût à long terme : une activité cellulaire et un renouvellement des tissus plus importants pourraient augmenter les dommages cellulaires ou solliciter davantage les mécanismes de réparation de l’organisme. À terme, cela pourrait contribuer à un vieillissement plus rapide.
Cette hypothèse reste toutefois à démontrer, l’IGF-1 n’est probablement pas le seul mécanisme en jeu pour expliquer cette différence de longévité entre les petites races et les races dites « géantes ». D’autres modifications du métabolisme sont également observées. Les cellules des grands chiens présenteraient une activité glycolytique plus importante pour dégrader le glucose et produire de l’énergie. Ces modifications pourraient être liées à une plus forte sollicitation des cellules et, à long terme, contribuer au stress cellulaire et au vieillissement.
Il est aussi possible de citer le tryptophane, un acide aminé utilisé par l’organisme pour fabriquer différentes molécules, dont le métabolisme est différent entre les chiens de grande et de petite race. Or, certaines voies de transformation du tryptophane interviennent dans des processus liés au fonctionnement cellulaire, à l’immunité et à l’inflammation. Cette différence pourrait donc constituer une nouvelle piste de compréhension.
Une question encore ouverte
Il reste encore beaucoup de recherches à mener pour comprendre précisément pourquoi les petits chiens vivent plus longtemps que les grands. Les chiens partagent notre environnement et une partie de notre mode de vie. Ce contexte exceptionnel est également une source d’apprentissage pour les spécialistes du vieillissement humain, ainsi que pour les vétérinaires, afin de mieux cerner les spécificités de chaque espèce et de proposer un accompagnement personnalisé à chacun de nos animaux.
Que l’on partage sa vie avec un Jack Russell terrier (petite race) ou un bouvier bernois (race géante), le rythme du vieillissement se joue en partie dans les gènes, mais aussi dans la qualité de vie offerte au fil des années : cela passe par un suivi régulier du poids, un exercice régulier et un suivi vétérinaire. Les grands chiens nous quittent trop tôt, mais comprendre pourquoi, c’est déjà commencer à réfléchir à la manière de leur offrir, à nos côtés, une vie de qualité.

Sara Hoummady a reçu des financements de la FVE (Federation of Veterinarians of Europe), a travaillé dans l'industrie pharmaceutique vétérinaire et est membre fondatrice de l'Association Française pour la Gériatrie Animale et les Soins Palliatifs.
Léna Rousseau ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 18:07
« Si l’élection avait lieu dimanche prochain… » : une méthodologie contestable au cœur des sondages
Léo Gerville-Réache, Modélisation statistique, Université de Bordeaux
Texte intégral (2110 mots)
L’ESSENTIEL
La question la plus utilisée dans les sondages électoraux pose un sérieux problème méthodologique.
Elle pousse notamment les électeurs à répondre dans une immédiateté artificielle, elle force une prise de position dénaturée et ignore l’absence d’opinion.
Ce type de sondage produit des données biaisées qui influencent le débat politique et les choix des électeurs.
La présidentielle approche, et avec elle revient le rituel du baromètre des intentions de vote, pilier du commentaire politique. Des mois avant le scrutin, pour mesurer le pouls de l’opinion, la quasi-totalité des instituts recourt à la même question :
« Si le premier tour de l’élection présidentielle avait lieu dimanche prochain, pour lequel des candidats suivants y aurait-il le plus de chances que vous votiez ? »
Cette formule consacrée est souvent présentée comme une simple commodité de recueil. Elle repose pourtant sur une expérience de pensée contrefactuelle qui brouille durablement le débat démocratique.
La sociologie de l’opinion publique documente ce problème méthodologique depuis longtemps. Le protocole de collecte, lui, continue de l’ignorer.
La fiction comme protocole de mesure
Une proposition contrefactuelle repose sur une prémisse explicitement contraire aux faits. Par définition, l’élection n’a pas lieu dimanche prochain (sauf dans la semaine du scrutin).
Ce dispositif impose un double forçage :
un forçage temporel : on demande au citoyen d’agir dans une situation d’urgence artificielle, court-circuitant le temps long de la délibération, de la campagne officielle et des débats ;
un forçage de l’offre politique : pour poser la question, l’institut doit proposer une liste fermée de personnalités. Or, les candidatures officielles ne sont validées par le Conseil constitutionnel que quelques semaines avant le scrutin. Tester des hypothèses arbitraires des mois à l’avance relève du casting médiatique : cela confère une existence statistique à des candidatures virtuelles tout en invisibilisant des alternatives émergentes.
De plus, l’analyste ne mesure pas un comportement ou une disposition réels dans le monde présent, mais le résultat d’une simulation mentale sous contrainte, aussi imaginaire que contrefactuelle. On fait alors le pari non vérifié (et le plus souvent invalidé) que la règle de décision adoptée par un individu dans ce cadre est identique à celle qu’il adoptera le jour réel du scrutin.
Ce pari n’est pas propre aux sondages électoraux.
Depuis les années 1970, l’économie expérimentale a précisément documenté, sous le nom de « biais hypothétique », l’écart systématique entre ce que des individus déclarent qu’ils feraient dans un scénario fictif et ce qu’ils font réellement une fois la situation concrète. Par exemple, lorsqu’on demande à des individus combien ils seraient prêts à payer pour un bien, les méta-analyses convergent : leur réponse surestime en moyenne de deux à trois fois le montant qu’ils déboursent réellement lorsque la situation se produit.
Rien ne garantit que le vote imaginé un jour ordinaire de campagne échappe à ce même écart entre déclaration et comportement.
À lire aussi : Peut-on faire confiance aux sondages politiques ? Un statisticien nous donne les clés pour les décrypter
La mécanique de l’entonnoir : comment les sondages effacent le doute
Pour bien comprendre l’ampleur de cet artefact (c’est-à-dire un résultat purement artificiel fabriqué par l’outil de mesure lui-même), il faut ouvrir le capot méthodologique des notices déposées par les instituts auprès de la Commission des sondages.
Comment arrive-t-on à publier un graphique avec des barres totalisant 100 % d’opinions exprimées à des mois, voire des années, d’une élection ? Par une mécanique de triple réduction de l’échantillon.
- Le filtre de la certitude absolue : les instituts évaluent la probabilité d’aller voter, souvent sur une échelle de 1 à 10. Pour établir les intentions de vote, les instituts restreignent leur échantillon aux seules personnes répondant 10/10, c’est-à-dire celles qui se disent « certaines d’aller voter ».
C’est un tri drastique. Affirmer une certitude absolue de participation des mois avant une élection est une posture contraignante, ce qui exclut mécaniquement une grande partie du corps électoral. L’ampleur de cette première coupe a été mise en lumière devant la commission d’enquête de l’Assemblée nationale du 26 mars 2025. Le rapporteur a notamment confronté l’Ifop à un sondage de décembre 2024 : sur 1 101 inscrits interrogés, 814 exprimaient une intention de vote, parmi lesquels 628 seulement se déclaraient certains de se déplacer. Bien que les instituts affirment utiliser l’ensemble du panel pour observer d’autres indicateurs, c’est bien sur ce sous-échantillon final – souvent restreint à environ 60 % du panel initial – que s’appuie le calcul strict des intentions de vote.
- L’illusion de l’urgence : aux survivants de ce premier filtre, on impose le fameux forçage contrefactuel (« Si l’élection avait lieu dimanche prochain… ») assorti d’une liste arbitraire.
Ce cadre fictif exige une projection artificielle dans l’immédiateté, forçant une prise de position dénaturée. Une démarche méthodologiquement sincère consisterait, au contraire, à respecter la réalité de cette échéance lointaine : il s’agirait de demander aux électeurs pour qui ils auraient le plus de chances de voter à la date effective du scrutin, plutôt que de les forcer à simuler un vote imaginaire.
- L’invisibilisation des indécis : malgré l’urgence de cette situation fictive, une proportion significative de ces électeurs (entre 15 % et 25 %) pourtant « certains d’aller voter » refuse de choisir un nom, déclarant ne pas se prononcer (NSP) ou vouloir voter blanc.
Que fait la mécanique sondagière ? Si les instituts se défendent d’ignorer ces profils en affirmant les conserver pour analyser l’évolution générale des électorats, tous les excluent de fait lors de la publication médiatique. Comme l’exige la simulation d’un résultat électoral fondé sur les seuls suffrages exprimés, les pourcentages finaux sont systématiquement recalculés uniquement sur le noyau de ceux qui ont donné un nom, afin d’atteindre artificiellement la somme parfaite de 100 %.
Le « déchet » statistique qui était en réalité la donnée
L’argument technique souvent avancé pour justifier ce nettoyage mécanique est celui de l’ « exploitabilité ». Pour les commentateurs en quête de classements, le flou est perçu comme un bruit gênant, un résidu qu’il faut expurger. Le contrefactuel et la pratique du redressement (modifications des données brutes d’un sondage pour rendre l’échantillon plus « représentatif » de la population globale) servent de compresseurs d’indécision.
Pourtant, lorsqu’une part massive des électeurs ne sait pas quoi répondre ou attend la campagne, ce n’est pas un échec de la mesure : c’est l’état réel du système. L’indécision à huit mois du scrutin n’est pas une absence d’opinion, c’est une donnée politique fondamentale.
Le sociologue Pierre Bourdieu formulait déjà cette critique en 1973, dans son texte fondateur « L’opinion publique n’existe pas » : les instituts, en supposant que tout le monde a une opinion et que toutes les opinions se valent, produisent un artefact statistique là où il faudrait au contraire restituer les rapports de force et les degrés d’investissement réels des enquêtés. Le contrefactuel temporel décrit ici n’est jamais qu’une version actualisée et techniquement affinée de ce même mécanisme : il ne se contente plus de faire comme si toutes les opinions se valaient, il fait comme si l’absence d’opinion elle-même n’existait pas.
En éliminant cette zone de flou pour fabriquer des scores lisses, le sondage produit un artefact d’opinion. Cette présentation a des effets directs sur le jeu politique : elle fige prématurément le paysage, dicte le « vote stratégique » selon des rapports de force fictifs et transforme la campagne – censée être un espace de persuasion – en une simple vérification d’un pronostic autoentretenu.
Pour une hygiène du questionnement
Une exigence de rigueur doit s’appliquer dès la conception du protocole d’interrogation. Il faut changer les questionnaires.
La question aujourd’hui favorite des instituts de sondage, « Si le premier tour de l’élection présidentielle avait lieu dimanche prochain, pour lequel des candidats suivants y aurait-il le plus de chances que vous votiez ? », ne devrait plus être utilisée.
Elle devrait être remplacée par une question ancrée dans le réel, une mesure scientifiquement et démocratiquement sincère, qui laisse place à l’incertitude et à la délibération :
« Dans huit mois se tiendra l’élection présidentielle. Il est possible que les personnalités suivantes se présentent, mais à ce stade, la liste n’est pas définitive. Aujourd’hui, pour laquelle auriez-vous le plus de chances de voter, ou préférez-vous attendre de connaître les candidats officiels, de découvrir leurs programmes et de voir comment la campagne évolue avant de vous prononcer ? »
Cette seconde formulation, certes plus longue, change tout le paradigme de la mesure. En explicitant le statut incertain des candidatures et la distance au scrutin, elle rappelle précisément à l’électeur ce sur quoi il se prononce. Surtout, en intégrant organiquement et explicitement les raisons rationnelles de patienter, elle ne traite plus l’indécision comme un déchet statistique qu’il faudrait cacher. Elle la valide comme une posture civique légitime.
Dans cette configuration, si, par exemple, 50 % des sondés répondent qu’ils attendent le déroulement de la campagne, la donnée publiée sera exactement celle-ci. Ce ne sera plus un « non-résultat », mais la photographie honnête d’un corps électoral en phase de réflexion.
Le respect du suffrage universel commence par le respect de sa temporalité. Un sondage ne devrait pas contraindre l’électeur à mimer le geste d’un vote fictif pour satisfaire le rythme continu de l’actualité et produire des classements prématurés. Reconnaître le droit au doute et à l’observation n’affaiblit pas la valeur de l’information statistique : cela lui redonne sa juste place et sa dignité scientifique et démocratique.

Léo Gerville-Réache ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 18:06
Santé mondiale : Le multilatéralisme est en crise, mais peut-on vraiment s’en passer ?
Marie-Paule Kieny, Experte en santé publique internationale, présidente du conseil d'administration de la DNDi (Drugs for Neglected Diseases Initiative) et du Medicines Patent Pool, Auteurs historiques The Conversation France
Michel Kazatchkine, Senior Fellow, Institut des Hautes Etudes en affaires internationales et développement, Genève
Sana Kahlaoui de Courcelles, Director, Global Coalition for Social Justice, ILO, Université de Genève
Texte intégral (2448 mots)
L’ESSENTIEL
En réponse à la crise du multilatéralisme, il est tentant de privilégier des accords de coopération restreints, tels que des coalitions de pays ou des accords régionaux.
En santé, certaines fonctions nécessitent une participation universelle pour être efficaces ou légitimes, tandis que d’autres peuvent être organisées à l’échelle régionale ou par des coalitions plus restreintes.
La réforme du multilatéralisme ne doit pas consister à le remplacer par un « minilatéralisme », mais plutôt à adapter les architectures de coopération à la nature des enjeux.
Le multilatéralisme à vocation universelle, incarné notamment par le système des Nations unies, traverse une crise profonde. Les rivalités entre grandes puissances entravent le fonctionnement de certaines institutions multilatérales tandis que l’ordre international se fragmente progressivement en blocs concurrents. Les institutions internationales sont, par ailleurs, régulièrement critiquées pour leur lenteur et leur manque d’efficacité.
Ces critiques ne sont pas sans fondement : les institutions du système des Nations unies, pour beaucoup créées au lendemain de la Seconde Guerre mondiale, peinent à s’adapter aux rapports de force du XXIᵉ siècle. Les divisions entre États paralysent souvent les processus de décision, et les organisations internationales doivent composer en permanence avec des rapports de force politiques qui réduisent leur capacité d’action.
Face à ces difficultés, des formes de coopération plus restreintes se multiplient : G7 et G20 Créé en 1975, le G7 est un forum informel qui réunit chaque année les dirigeants de sept grandes économies industrialisées et démocratiques (Allemagne, Canada, États-Unis, France, Italie, Japon, Royaume-Uni). L’Union européenne y est associée. L’objectif est de coordonner les positions des participants sur l’économie, la sécurité et les grands enjeux mondiaux. Ses décisions ne sont pas juridiquement contraignantes.
En 1999, cette consultation a été élargie aux grandes économies émergentes pour former le G20, qui regroupe 19 pays et deux unions régionales (l’Union européenne et, depuis 2023, l’Union africaine). ,coalitions de pays partageant les mêmes intérêts, alliances à géométrie variable ou accords régionaux.
Ce « minilatéralisme » présente des avantages réels. Réunir moins de pays peut permettre de décider plus vite, d’expérimenter de nouvelles solutions et d’éviter les blocages inhérents à la recherche d’un consensus universel. Mais cette efficacité potentielle soulève aussi des questions de légitimité, d’équité et de responsabilité : qui décide, au nom de qui, et avec quelles conséquences pour ceux qui ne participent pas ?
Une plus grande agilité suffit-elle à faire de ces coalitions une alternative aux institutions universelles ? La réponse dépend moins du nombre de pays autour de la table que de la nature des fonctions à assurer, comme l’illustre l’exemple de la santé mondiale.
La santé mondiale, un cas d’école
Les travaux sur les biens publics mondiaux montrent que les contributions des différents acteurs ne se combinent pas toujours de la même manière. Cette expression désigne des biens dont personne ne peut être exclu et dont le bénéfice pour l’un ne réduit pas celui des autres, avec des effets qui dépassent les frontières nationales. Dans certains cas, une coordination étroite est essentielle : le contrôle du trafic aérien mondial, par exemple, suppose que tous les acteurs appliquent des règles et des standards compatibles.
Dans d’autres, les efforts s’additionnent. C’est largement le cas de la lutte contre le changement climatique : chaque réduction d’émissions contribue au résultat collectif. Des coalitions de grands émetteurs peuvent donc avancer plus rapidement sur certains objectifs, expérimenter des solutions ou créer des incitations pour que d’autres pays les rejoignent. C’est le principe des « clubs climatiques » – des coalitions de pays qui s’engagent sur des mesures climatiques ambitieuses et qui imposent des pénalités commerciales aux pays restés en dehors. Les recherches révèlent toutefois que ces clubs sont davantage susceptibles de compléter le cadre multilatéral que de s’y substituer.
Enfin, certains biens communs obéissent à la logique du « maillon le plus faible » : le niveau de protection de tous dépend alors de la contribution du pays le moins capable d’agir. L’universalité n’est donc pas toujours nécessaire. Mais dans certaines situations, elle cesse d’être un idéal politique ou moral : elle devient une condition d’efficacité. La surveillance des maladies infectieuses illustre particulièrement bien cette logique du « maillon le plus faible », en particulier lorsqu’il s’agit de détecter rapidement une nouvelle menace et de la signaler.
Quand la solidarité renforce la sécurité
Le contrôle de certaines maladies contagieuses est classiquement décrit comme un bien public de type « maillon le plus faible ». En effet, la sécurité collective dépend notamment de la capacité de chaque pays à détecter rapidement un nouvel agent pathogène, à signaler une flambée épidémique et à partager les informations nécessaires à la réponse. Une défaillance locale peut avoir des conséquences mondiales : si un seul pays est dépourvu de capacités de détection ou de notification, ou ne fait pas preuve de suffisamment de transparence, il fait courir aux autres un risque de crise sanitaire. La sécurité de tous dépend donc de la capacité de chacun, y compris du plus vulnérable.
Dans cette situation, aider les pays disposant des capacités de surveillance les plus faibles n’est pas seulement une exigence de solidarité, un idéal politique ou moral : c’est aussi une manière pour les pays disposant des capacités les plus solides de renforcer leur propre sécurité. Exclure les États les plus fragiles n’améliore pas l’efficacité du système. Le multilatéralisme universel n’est donc plus un choix parmi d’autres, mais la condition même de l’efficacité collective.
L’Organisation mondiale de la santé (OMS) permet à la fois d’organiser la surveillance et l’alerte internationales et de produire des normes communes indispensables à la circulation de l’information et à la coordination des réponses.
À lire aussi : Pourquoi l’Organisation mondiale de la santé est utile aux citoyens français
Le retrait des États-Unis de l’OMS offre aujourd’hui un test grandeur nature des risques liés à la fragmentation de cette architecture. La remise en cause par l’administration Trump du rôle des institutions internationales s’est accompagnée d’une préférence pour des relations directes entre États et pour la négociation d’accords bilatéraux, dans lesquels le poids politique et économique des partenaires tend à déterminer l’issue des négociations, au détriment de mécanismes de décision plus inclusifs.
Dans le domaine de la santé mondiale, un tel basculement risque d’entraîner une divergence croissante des normes sanitaires, des systèmes de surveillance et des mécanismes de réponse aux crises. Chaque puissance organiserait progressivement son propre réseau de coopération, avec le risque de voir émerger des architectures de plus en plus fragmentées et difficilement interopérables.
Si le recul est encore insuffisant pour en mesurer les conséquences à long terme, une analyse récente replace ce retrait dans une évolution plus profonde de l’ordre international dont dépend l’OMS et souligne que l’affaiblissement de celle-ci pourrait nuire aux États-Unis eux-mêmes.
Le problème dépasse largement la perte d’un important contributeur financier : il pose la question de la capacité à préserver des mécanismes universels de surveillance, d’alerte et de coordination dans un monde de plus en plus fragmenté. Face à un agent pathogène susceptible de franchir les frontières en quelques heures, aucune puissance ne peut durablement se protéger seule…
Réformer plutôt que renoncer
Ces constats ne plaident pas pour le maintien à l’identique des institutions multilatérales. Ils invitent plutôt à réserver l’universalité là où elle est indispensable, et à accepter des formes de coopération plus souples lorsqu’elles peuvent être plus efficaces.
Pour l’OMS, cela signifie préserver et renforcer les fonctions qui nécessitent la participation de tous : les mécanismes de surveillance et d’alerte prévus par le Règlement sanitaire international (RSI), ainsi que l’élaboration de normes communes.
Le RSI impose notamment aux États de développer des capacités de détection et de réponse et de notifier à l’OMS les événements susceptibles d’avoir une portée internationale ; il confie parallèlement à l’OMS une fonction mondiale d’alerte et de coordination.
Le RSI est juridiquement contraignant pour les États parties. Il leur impose notamment de développer certaines capacités de surveillance et de réponse, de notifier à l’OMS les événements susceptibles d’avoir une portée internationale et de rendre compte régulièrement de leur mise en œuvre. Son application repose toutefois principalement sur les dispositifs nationaux et sur le suivi organisé par l’OMS : le RSI ne prévoit pas de mécanisme classique de sanction en cas de non-respect.
D’autres activités, comme les achats groupés de médicaments et de vaccins, peuvent en revanche être organisées à l’échelle régionale ou par des coalitions de pays volontaires, quitte à élargir ensuite ces initiatives.
Réformer le multilatéralisme ne consiste donc pas à choisir entre universalisme et minilatéralisme, mais à les articuler en fonction des problèmes à résoudre.

Cela passe également par une participation plus effective des États aujourd’hui les moins influents, ainsi que par l’intégration plus systématique d’acteurs non étatiques, tels que collectivités territoriales, universités, secteur privé, fondations, organisations de la société civile.
Et la France et l’Europe ?
Pour la France et l’Union européenne, cette réflexion n’est pas seulement théorique. Dans un monde où les règles communes s’affaiblissent au profit des rapports de force, les puissances intermédiaires disposent de moins de leviers face aux plus grandes. La littérature montre d’ailleurs qu’elles ont traditionnellement privilégié les institutions internationales, le multilatéralisme et la construction de coalitions, qui leur permettent d’accroître leur capacité d’influence.
Le désengagement américain ouvre à cet égard un espace particulier pour l’Europe. Une analyse récente estime que l’Union européenne pourrait contribuer à préserver un ordre international fondé sur des règles et fédérer autour d’elle une coalition de pays partageant cet intérêt, tout en soulignant les limites politiques, budgétaires et militaires qui restreignent encore sa capacité de leadership.
Pour la France comme pour l’Europe, défendre le multilatéralisme ne signifie donc ni préserver à l’identique les institutions existantes ni refuser les coalitions plus restreintes. C’est un choix stratégique dans un monde où les rapports de force tendent à reprendre le pas sur les règles communes.
Le défi n’est donc pas de choisir entre multilatéralisme universel, régionalisme et coalitions restreintes. Il est de savoir les articuler – et de préserver l’universalité là où elle demeure irremplaçable.

Marie-Paule Kieny est membre du groupe de réflexion Santé mondiale 2030.
Michel Kazatchkine est membre du groupe de réflexion Santé mondiale 2030.
Sana Kahlaoui de Courcelles est membre du groupe de réflexion Santé mondiale 2030.
13.10.2026 à 18:06
Logement : vivre seul est-il devenu la norme ?
Laurent Proulhac, Géographe, Laboratoire Ville Mobilité Transport, Université Gustave Eiffel
Texte intégral (2051 mots)
L’ESSENTIEL
Vivre seul n’est plus seulement une transition, mais recouvre une diversité de situations.
La situation conjugale des personnes seules est variée, tout comme leurs profils économiques.
Cette situation peut exacerber les tensions sur le marché immobilier et invite à repenser le parc de logements.
Près de quatre logements sur dix sont aujourd’hui occupés par une personne vivant seule. Mais derrière cette configuration de plus en plus fréquente se cachent des réalités plus diverses qu’il n’y paraît. Les personnes seules ne peuvent plus être réduites à quelques figures sociales bien identifiées, comme l’étudiant en studio, le célibataire urbain dans un petit appartement ou la veuve dans une maison à la campagne.
Comme le souligne une étude menée par le bureau d’étude Intermède et l’Université Gustave Eiffel, soutenue par Leroy Merlin Source et Bouygues Immobilier, la vie en solo correspond à une variété de profils, de trajectoires, de conditions résidentielles et de territoires.
Vivre en solo : une réalité qui progresse
La vie en solo n’est plus une situation résidentielle marginale ou atypique. D’après les derniers recensements de la population par l’Insee, 39 % des résidences principales sont occupées par une seule personne. Ce chiffre a augmenté de près de 14 % entre 2016 et 2022, contre 5 % pour les logements occupés par deux personnes, alors que dans le même temps le nombre de logements de cinq personnes et plus a reculé de 4 %.
Cette évolution traduit une transformation des manières d’habiter, moins structurées par la vie en couple ou en famille, et contribue à faire évoluer la demande de logements.
Vivre seul chez soi recouvre désormais des réalités plurielles. Ce n’est plus seulement une étape avant une vie familiale ou une situation liée à un âge avancé, mais c’est une situation qui peut accompagner les mobilités professionnelles, les séparations et recompositions conjugales.
Des profils sociaux et conjugaux variés
Si la vie en solo progresse chez les 60-74 ans, elle augmente aussi fortement chez les moins de 24 ans et les 25-59 ans. Cette dernière tranche d’âge représente 43 % des personnes vivant seules, à peine 4 % de moins que les plus de 60 ans. Vivre seul est ainsi devenu une réalité courante à l’âge adulte, et notamment parmi les personnes en emploi qui représentent 43 % des personnes seules, contre 41 % pour les retraités et 16 % pour les autres inactifs, dont les étudiants.
Autre évolution notable, le nombre d’hommes vivant seuls progresse plus rapidement que celui des femmes, notamment entre 25 et 59 ans. Celles-ci restent cependant plus nombreuses, représentant 56 % des personnes seules, en raison de leur espérance de vie plus longue et du veuvage.
Vivre en solo ne signifie pas nécessairement avoir une situation économique plus défavorable. Les personnes seules ne sont pas davantage au chômage et se retrouvent dans l’ensemble de l’espace social, avec même une légère surreprésentation des cadres et des professions intermédiaires. Leur emploi est cependant plus précaire, avec davantage de CDD, de contrats d’apprentissage, d’intérim et d’emplois aidés.
La situation conjugale des personnes seules est elle aussi diverse. Près de la moitié sont célibataires tandis qu’un quart sont veuves ou veufs et un cinquième divorcées. Mais certaines personnes vivent seules tout en étant engagées dans une relation conjugale, par exemple dans le cadre de couples non cohabitants, de décohabitations partielles ou de formes de multilocalisation résidentielle. Près d’une personne seule sur dix est mariée, pacsée ou en union libre découlant, par exemple, de choix en termes de localisation professionnelle.
Inversement, être célibataire ne signifie pas toujours vivre seul : colocation ou coliving, chambre chez l’habitant ou habitat partagé, sont des situations parfois durables qui s’étendent à tous les âges de la vie. Ces situations conduisent à relativiser l’image de la vie en solo comme simple parenthèse entre deux périodes de vie en couple.
Des conditions de logement contrastées
Les personnes seules vivent dans des logements très différents. Elles occupent l’essentiel des très petits logements : près de neuf logements sur dix de moins de 30 m2 ou d’une pièce sont occupés par une personne seule. Cette réalité nourrit l’image de l’étudiant ou du jeune actif vivant en studio. Mais elle ne concerne qu’une minorité des personnes seules : 11 % seulement vivent dans moins de 30 m2, tandis que 38 % habitent dans des logements de 60 à 100 m2 et 15 % dans des logements de plus de 100 m2.
Vivre seul signifie donc également occuper un logement de grande taille, souvent un logement toujours habité après une séparation, le départ des enfants ou le décès du conjoint.
Le type de logement témoigne de la même diversité. Si la vie seule va majoritairement de pair avec l’appartement, la maison est loin d’être marginale : près de quatre personnes seules sur dix y résident, notamment les personnes veuves, divorcées ou mariées. Elles ne sont pas non plus seulement locataires. Près de la moitié sont propriétaires de leur logement (46 %), contre 36 % de locataires du parc privé et 16 % de locataires du parc social.
Entre étape transitoire et ancrage durable
Vivre seul est souvent perçu comme une situation de transition, après le départ du domicile parental, une séparation ou une mobilité professionnelle. Les données du recensement vont en partie dans ce sens : 16 % des personnes seules occupent leur logement depuis moins de deux ans, contre 10 % des personnes vivant dans un ménage de deux personnes ou plus.
Pour certaines, vivre seul correspond donc à une période de changement, parfois opéré dans l’urgence ou avec des ressources économiques limitées. Mais la vie seule peut aussi s’installer dans la durée : 20 % des personnes seules vivent dans leur logement depuis plus de trente ans.
La vie en solo peut aussi bien s’inscrire dans un petit logement loué pour quelques années que dans une maison ou un grand appartement occupé plusieurs décennies comme propriétaire. Mais les situations intermédiaires sont également nombreuses : personnes séparées qui restent dans leur logement familial, actifs occupés durablement seuls dans un logement de taille moyenne, retraités qui adaptent progressivement leur logement ou déménagent pour plus petit, actifs occupés seuls en habitat partagé ou encore couples non cohabitants qui organisent leur vie entre deux logements périodiquement ou durablement.
Dans les centres urbains, mais pas seulement
Les personnes seules vivent aussi bien dans les espaces ruraux que dans les petites villes et les grandes agglomérations. Mais elles sont particulièrement nombreuses à habiter dans les villes de plus de 200 000 habitants, davantage dans des communes centrales que dans des communes périurbaines. C’est vrai pour les moins de 24 ans, en raison des établissements d’enseignement supérieur, des emplois, des réseaux sociaux, des équipements et des aménités urbaines, mais aussi de l’offre de petits logements et du parc locatif.
Malgré tout, les couronnes périurbaines ne sont pas seulement l’espace des couples avec enfants et des maisons familiales. C’est d’ailleurs là que la croissance du nombre de personnes seules a été la plus forte ces dernières années, aussi bien parmi les 25-59 ans que les 60-74 ans. Il s’agit d’agriculteurs, d’actifs, de personnes séparées, ou encore des propriétaires de grandes maisons. Dans les espaces ruraux, les personnes seules sont plus âgées : trois sur dix ont plus de 75 ans.
Ces constats montrent que de nouvelles formes de vie en solo émergent : personnes en couple non cohabitantes, personnes âgées seules dans les centres urbains, actifs seuls dans les espaces périurbains, personnes seules dans de grands logements, etc.
Cette diversification des manières d’habiter produit une concurrence accrue pour l’accès à des petits logements encore trop peu nombreux pour la demande, notamment en ville, mais aussi dans les espaces périurbains, royaume de la maison individuelle.
Dans un marché où l’accès au logement est difficile, il ne suffit donc plus de construire davantage, mais aussi répondre à la pluralité des situations, en adaptant le parc de logements et ses modalités d’occupation. Cela suppose de faciliter l’accès à des logements abordables pour les personnes seules ne disposant que d’un revenu de référence, de permettre le maintien à domicile des personnes âgées, d’adapter les logements au vieillissement de la population, de développer des formes d’habitat partagé ou encore de réfléchir à la sous-occupation des logements devenus trop grands pour les occupants seuls.
Cet article a été co-écrit par Laurent Proulhac, chercheur au Laboratoire Ville Mobilité Transport, Université Gustave-Eiffel, et Benjamin Pradel, docteur en sociologie, co-fondateur d’Intermède, coopérative des transitions des lieux, territoires et modes de vie.

Laurent Proulhac ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 18:05
Antisémitisme de Jordan Bardella : le RN stoppé dans sa tentative de séduction des juifs de France ?
Frédéric Strack, chercheur en sciences politiques, Sciences Po; Université de Sherbrooke
Texte intégral (2314 mots)
L’ESSENTIEL
Selon une enquête de Mediapart, Jordan Bardella, président du Rassemblement national, aurait écrit de nombreux commentaires antisémites par le passé.
En France, plusieurs enquêtes montrent que le vote des juifs autodéclarés s’est déplacé vers la droite et l’extrême droite ces dernières années.
Pour ces électeurs, La France insoumise est perçu comme plus dangereux que le RN, malgré l’histoire de ce parti d’extrême droite, profondément lié à l’antisémitisme.
Le 28 septembre dernier, le journal Mediapart livre les résultats d’une enquête retentissante : Jordan Bardella, président du Rassemblement national, aurait écrit dans le passé nombre de commentaires reprenant des poncifs antisémites. L’intéressé dément fermement.
Cette polémique réactive des accusations de longue date d’antisémitisme envers le Front national, que l’évolution en Rassemblement national visait à écarter. La polémique place ainsi ce parti dans une position inconfortable, et met en péril des années d’efforts pour apparaître comme le seul véritable défenseur des juifs de France. L’un des enjeux de cette séquence est ainsi de savoir si ces propos sont de nature à remettre en cause la stratégie souvent commentée de « dédiabolisation ».
Un soutien paradoxal au Rassemblement national
Les accusations d’antisémitisme au sein de l’extrême droite sont connues des juifs de France. L’on pense évidemment aux commentaires de Jean-Marie Le Pen, condamné, entre autres, pour contestation de crimes contre l’humanité et pour des propos antisémites. Mais l’on peut aussi évoquer la présence, dans l’orbite du parti, de personnes négationnistes ou antisémites, comme le démontrent, dans leur enquête, Judith Cohen-Solal et Jonathan Hayoun (2019). Les accusations d’antisémitisme à l’encontre d’au moins une partie du personnel politique d’extrême droite n’ont jamais disparu.
Et pourtant, cela n’a pas empêché le Rassemblement national d’engranger le soutien croissant de juifs : longtemps fidèles à la gauche non communiste, ils se sont progressivement tournés, à partir des années 1980, vers la droite et l’extrême droite.
Le tableau suivant établit ce déplacement électoral :

Aucune donnée comparable n’est disponible au-delà de 2012, mais les données de terrain collectées (cf. les Juifs orthodoxes en France, Presses universitaires de Rennes, 2025) signalent que le déplacement vers la droite et l’extrême droite se poursuit. Par exemple, à Sarcelles, lors de l’élection présidentielle de 2022, dans quatre bureaux de vote à forte présence juive, le vote pour Éric Zemmour s’est étendu de plus de 28 % à plus de 39 %, contre une moyenne de 11,55 % pour la ville. Un tel survote s’observe aussi dans les quartiers de Strasbourg à forte présence juive. Ce déplacement se retrouve dans le reste de la population, mais, dans le cas d’électeurs juifs, il est paradoxal au regard de l’histoire du Rassemblement national ex-Front national.
Comprendre l’extrême droitisation électorale des juifs de France
En 2007, Nicolas Sarkozy avait capté une part importante des votes juifs et, à nouveau en 2012 : les électeurs juifs l’ont soutenu à 45 % au premier tour, contre 27 % pour la population générale (cf. tableau ci-dessus). Mais la question migratoire et les attaques terroristes ont en partie disqualifié la droite classique et alimentent des craintes, notamment en matière d’insécurité.
La répétition de meurtres antisémites a, par exemple, fortement marqué les esprits, comme l’indique cette personne interrogée :
« Depuis le meurtre d’Ilan Halimi, on a eu l’hypercacher, on a eu Toulouse, on a eu madame Halimi, Sarah Halimi, on a eu Madame Knoll, ça commencer à chiffrer, ça commence à chiffrer. Sans compter les attaques non fatales qui ont peut-être fait moins de bruit. »
Cet argument de la sécurité va de pair avec un autre argument marqué à droite, celui de la faiblesse de l’État, comme l’exprime un témoin :
« Quand une manifestation pro-palestinienne est interdite et qu’elle a quand même lieu, l’affaiblissement du pouvoir est évident. »
À ces actes antisémites, nombre de juifs ajoutent des attaques terroristes, les associant parfois à l’immigration, qui entraînerait insécurité physique et culturelle. Ainsi, le thème du « grand remplacement » pouvait s’observer sur le terrain dès avant 2022. Des observations participantes nous ont donné accès à des conversations où ce thème étant repris sans discussion.
À ces occasions, Éric Zemmour, pas encore candidat à l’élection présidentielle, bénéficiait d’un soutien non caché. Ce soutien s’observe aussi de manière quantitative, avec toutes les précautions d’usage pour une population aussi réduite : 67 % des juifs interrogés considèrent qu’« Il y a trop d’étrangers dans notre pays ». Or, cette position peut conduire à un vote pour le Rassemblement national : 93 % de ceux qui ont voté Le Pen sont d’accord avec cette proposition, dont 84 % sont tout à fait d’accord. Or, ce sujet est depuis plusieurs années l’un des principaux thèmes de prédilection du Rassemblement national, d’autant plus que Nicolas Sarkozy, qui bénéficiait d’un large soutien (cf. tableau) n’est plus candidat à partir de 2012.
Composer avec l’antisémitisme du Rassemblement national
Ce mécontentement favorise d’autant plus le Rassemblement national que Marine Le Pen se fait fort de défendre la liberté individuelle contre « l’islamisme », y compris le droit des juifs de vivre et de pratiquer librement, sans craindre pour leur sécurité. En outre, le travail de « dédiabolisation » du parti, et d’éloignement des personnes accusées d’antisémitisme l’a rendu plus acceptable pour une partie des juifs interrogés. Une personne interrogée nous a par exemple indiqué :
« Je pense qu’elles [les filles de Jean-Marie Le Pen] ont reçu une éducation fortement antisémite, mais je pense que Marine (…) s’est sortie de ça. (…) je ne pense pas que ce soit une grande motivation chez elle. »
Dans le cadre de leur raisonnement politique, les juifs semblent ainsi, pour une partie d’entre eux tout du moins, prioriser les sujets : la perception d’une menace actuelle continue de l’emporter sur toute autre considération, y compris des accusations d’antisémitisme remontant à une dizaine d’années. Et ce, d’autant plus que, sur le plan politique, c’est La France Insoumise qui est vue comme antisémite, bien plus que le Rassemblement national.
En effet, les études disponibles (cf. la Tentation antisémite : haine des juifs dans la France d’aujourd’hui, Wieviorka, 2005 ; Français comme les autres ?, Tiberj, Brouard, 2005 ; l’An prochain à Jérusalem ? Fourquet, Manternach, 2016), considèrent souvent trois foyers d’antisémitisme : l’extrême droite, l’extrême gauche et les personnes musulmanes. Or, l’on observe un décalage partiel entre les données disponibles et les perceptions des juifs.
Par exemple, le dernier rapport de la Commission nationale consultative des droits de l’homme indique que la « proximité affichée avec le Rassemblement national et les autres partis d’extrême droite favorise les préjugés envers les juifs », alors que la proximité avec La France insoumise (LFI) n’influe pas sur l’antisémitisme.
Pourtant, ce n’est pas ce que les juifs interrogés observent : ils citent l’extrême gauche comme acteur politique responsable de l’antisémitisme, bien devant l’extrême droite : 92 % considèrent que LFI contribue à la montée de l’antisémitisme, contre 49 % pour le RN. Une controverse récente peut alimenter cette perception, lorsque Jean-Luc Mélenchon a paru, par sa prononciation, souligner la judéité de certaines personnalités.
Mais c’est de loin la question d’Israël qui est au cœur de la différence de perception de LFI et du RN. Une personne interrogée indique par exemple que :
« Dans le parti de Mélenchon, même si ce n’est pas dit officiellement (…), il y a quand même quelque chose qui [le] perturbe par rapport à [l’antisémitisme], une obsession d’Israël qu’on ne retrouve pas chez Le Pen. »
Certains reprochent à Jean-Luc Mélenchon d’avoir tardé à dénoncer l’attaque du Hamas du 7 octobre 2023 et d’avoir condamné la contre-offensive israélienne à Gaza. Mais, plus généralement, c’est le soutien apporté à la cause palestinienne qui est vu, par certains, comme hostile aux juifs. Une personne interrogée est catégorique :
« Ayant la fâcheuse manie de faire passer leur jalousie pour les juifs avant l’amour pour leur patrie, certains de nos concitoyens non juifs, commettent la plus grave erreur historique depuis la collaboration vichyste : celle de soutenir une cause qui ne les regarde en rien, et qui finira par les perdre. La seule différence est qu’à l’époque de Vichy l’extrême droite attisait la haine ouvertement (…), alors que, aujourd’hui, c’est l’extrême gauche qui a pris le dessus par son soutien aveugle et inconditionnel à la cause palestinienne. »
Dans ce contexte, il n’est pas certain que les révélations concernant Jordan Bardella privent le Rassemblement national du vote d’électeurs juifs.
Quoi qu’il en soit, les conséquences électorales ne dépendront pas des juifs. L’on ne rappellera jamais assez, en effet, que la faible taille de la population juive de France (moins de 1 %), qui plus est en déclin (les chiffres sont rares et à manier avec grande précaution, mais des estimations indiquent que la population juive de France serait passée de 600 000 à la fin des années 1990 à environ 450 000 dans les années 2020), lui retire tout poids électoral : même un repositionnement d’ampleur des juifs de France n’aurait qu’un effet négligeable sur le résultat de l’élection présidentielle de 2027. Les juifs figurent, certes, parmi les premiers concernés par cette controverse, mais les éventuelles conséquences électorales seront décidées par le reste de la population française.

Frederic Strack a reçu des financements de l'Université Paris Panthéon-Assas pour ses études doctorales.
13.10.2026 à 18:04
ICE : une chasse à l’homme contraire au droit et très lucrative pour Trump et ses amis
Anne E. Deysine, Professeur émérite juriste et américaniste, spécialiste des États-Unis, questions politiques, sociales et juridiques (Cour suprême), Université Paris Nanterre
Texte intégral (2783 mots)
L’ESSENTIEL
Les opérations de la police fédérale de l’immigration (ICE) se caractérisent, depuis le retour de Donald Trump à la Maison-Blanche en janvier 2025, par de nombreuses arrestations brutales, qui ont causé plusieurs morts, et par de multiples atteintes aux droits des migrants.
L’administration Trump s’emploie à ne pas respecter les décisions de justice, et la Cour suprême intervient régulièrement en sa faveur.
La politique d’expulsions profite à des entreprises privées de détention, de transport et de surveillance, dont certaines entretiennent des liens financiers avec Donald Trump.
Les brutalités de la police fédérale de l’immigration (ICE) et les violations des droits des personnes ciblées par l’administration Trump sont quotidiennes. Ce 8 octobre encore, un homme a été grièvement blessé par balle dans sa voiture par des agents de l’ICE à New York.
Un documentaire de Julie Peyrard et Christophe Astruc, diffusé sur France 5 le 11 octobre, fait le point sur les diverses facettes de cette « chasse à l’homme » dénoncée par les organisations des droits humains et très lucrative pour l’entourage de Donald Trump.
La chasse aux sans-papiers au mépris du droit
Le spectateur suit les équipes de l’ICE dans leurs rafles visant des sans-papiers – opérations conduites en violation aussi bien des promesses faites par Trump pendant la campagne électorale de 2024 que du droit états-unien.
Alors que durant sa campagne, le candidat avait promis de s’en prendre aux « worst of the worst » – c’est-à-dire aux pires criminels, notamment les meurtriers, les violeurs et les membres de gangs –, les troupes de l’ICE arrêtent dans la rue, près des écoles et même dans les tribunaux (avant que ce soit interdit par la justice, en juin dernier) tout individu susceptible d’être sans papiers, y compris au moins 500 citoyens états-uniens. Les critères sont l’apparence physique ou la langue parlée, ce qui facilite les arrestations au faciès, validées par la Cour suprême en septembre 2025.
Le film donne la parole aussi bien aux responsables, notamment à Greg Bovino, nommé à la tête de l’ICE après trente ans au Service de la frontière, comme aux nouvelles recrues – manifestement choisies davantage pour leur amour des armes et leur désir de « casser du sans-papiers » (sans oublier la prime de 50 000 dollars à l’embauche) que pour leur fort désir de faire respecter la loi et de protéger la sécurité à la frontière.
Les victimes sont également interrogées. Leurs témoignages – familles séparées, individus agressés… – sont d’autant plus bouleversants que, selon des données de l’ICE analysées par le Cato Institute, près de 73 % des personnes placées en détention en 2025 n’avaient pas été condamnées pénalement, et près de la moitié n’avaient même ni condamnation ni inculpation en cours – et cela, alors qu’elles sont présentes aux États-Unis depuis parfois plus de quinze ans, qu’elles ont un travail et payent des impôts.
Le spectateur comprend aussi que l’administration fait tout son possible pour agir dans l’urgence de façon à rendre les recours compliqués, voire impossibles. Certains sont arrêtés dans le Minnesota et immédiatement « expédiés » au Texas où les recours en habeas corpus (c’est-à-dire la possibilité, pour une personne détenue, d’aller devant un juge afin de contester la légalité de sa détention) sont plus difficiles.
La grande majorité sont placés en centre de rétention sans possibilité de demander une libération sous caution. Ce qui est à l’œuvre, c’est une machine qui vise à broyer, à instiller la terreur et à inciter un maximum d’immigrés de couleur (dans un contexte marqué par les déclarations hostiles de Donald Trump à l’égard de plusieurs communautés immigrées) à quitter d’eux-mêmes le pays.
Quand l’administration Trump défie les juges
Plusieurs milliers de recours ont été formés pour contester les décrets de l’administration, les arrestations illégales et les expulsions vers des pays tiers.
À ce jour, on compte plus de 40 000 poursuites actives, dont 38 000 requêtes d’habeas corpus à l’échelle nationale. La plupart des recours sont individuels et ont abouti à plus de 4 400 décisions d’illégalité de détention rendues depuis octobre 2025 par plus de 400 juges fédéraux.
Les autres sont collectifs : ils visent les arrestations « embuscades » dans les tribunaux ou le refus systématique de libération sous caution. Ces chiffres ne prennent pas en compte l’immense arriéré des tribunaux d’immigration administratifs : plus de 3 millions de dossiers en attente avec un délai d’attente moyen de 940 jours.
En règle générale, les juridictions de première instance ont fait droit aux demandes des requérants en suspendant l’application d’un décret, en s’opposant à certaines expulsions, en ordonnant à l’administration de libérer telle ou telle personne, de ne pas faire partir les avions remplis de sans-papiers vénézuéliens vers le Salvador ou encore de cesser de pratiquer des arrestations au faciès.
Mais, souvent, l’administration a voulu court-circuiter le processus normal de la justice et a demandé à la Cour suprême d’intervenir en procédure d’urgence. C’est un mécanisme qui existe, mais qui a été peu utilisé jusqu’à l’administration Trump qui, elle, en a usé et abusé durant son premier mandat et continue durant le second.
La Cour suprême n’est aucunement obligée d’accepter ces demandes, mais elle l’a fait et est intervenue à 19 reprises dans le cadre du shadow docket pour suspendre ou annuler les ordonnances émises par les juridictions dites « inférieures ».
La Cour suprême est aussi intervenue le 25 juin 2026 pour valider l’élimination par le Département de la sécurité intérieure (DHS) du statut de protection temporaire (TPS) accordé à des centaines de milliers de Syriens et d’Haïtiens ayant dû quitter leur pays en raison des conditions très difficiles dues à la guerre ou aux ouragans. Ils sont désormais la cible de l’ICE. Dans les États où ils sont ou étaient nombreux, comme l’Ohio, les entreprises de construction, de rénovation, les services de santé, les hôpitaux, par exemple, ne peuvent plus fonctionner à pleine capacité en raison de la pénurie de main-d’œuvre.
Seules deux des décisions de la Cour sont allées à l’encontre de l’administration Trump : en décembre 2025, lorsqu’elle a interdit le déploiement de La Garde nationale pour protéger la police de l’immigration ; et en juin 2026, quand elle a jugé illégal le décret présidentiel visant à supprimer le droit du sol (jus soli) pour les enfants d’immigrés en situation irrégulière.
Lorsque la Cour n’est pas intervenue, l’administration a, en de nombreuses occasions, refusé de se conformer aux décisions de justice. Ainsi, en mars 2025, alors qu’un juge avait interdit le décollage des avions vers le Salvador, l’administration a prétendu avoir eu connaissance de l’ordonnance trop tard, alors que les avions étaient déjà partis.
Dans l’affaire Kilmar Abrego García, expulsé par erreur vers le Salvador en mars 2025 (ce que l’administration avait fini par reconnaître), une décision de justice a exigé son retour immédiat sur le sol états-unien, mais les autorités ont fait preuve d’une telle mauvaise volonté pour le faire revenir qu’une juge fédérale du Maryland a dû menacer de les sanctionner pour outrage à la cour.
Un autre juge a conclu que l’administration n’avait pas accordé aux demandeurs d’asile expulsés vers des tiers pays la légalité processuelle (due process) garantie par la Constitution en expulsant des migrants vers des pays tiers sans leur accorder un préavis suffisant ni une possibilité effective de contester leur renvoi.
Selon un rapport de l’Associated Press publié en mai 2026, l’administration Trump a désobéi aux décisions de justice dans au moins 31 affaires distinctes. À ces manquements s’ajoutent des centaines de cas individuels dans lesquels des ordonnances judiciaires n’auraient pas été respectées. La stratégie de l’administration consiste à contester les décisions de justice pour des motifs de procédure de façon à retarder leur application.
Les profits de l’industrie des expulsions
La politique de renvoi systématique des migrants est un scandale en soi en raison de la violence, de la privation des droits et des nombreux refus de l’administration de se conformer aux décisions rendues par les juges. Mais il existe un autre aspect bien mis en lumière par le film : le développement d’entreprises qui profitent de cette politique d’arrestations, de détentions massives et d’expulsions vers le pays d’origine ou vers un pays tiers.
C’est un bel exemple de la corruption généralisée qui bénéficie à plusieurs entreprises de la détention privée, du transport aérien et de la surveillance électronique ainsi qu’à leurs actionnaires. Parmi les bénéficiaires, trois acteurs du transport aérien, CSI Aviation, MVM Inc. et Aveli Airlines, ont chacun décroché des contrats de plusieurs dizaines, voire centaines de millions de dollars – 673 millions (soit 601,7 millions d’euros) pour CSI Aviation, par exemple.
Parmi les géants de la détention privée, le groupe Geo est le grand gagnant : il a engrangé 710 millions de dollars (soit 634,8 millions d’euros) de revenus liés à l’immigration. Sa filiale BI Incorporated détient le monopole de la surveillance des migrants contraints de porter un bracelet électronique.
Autre géant de la détention privée, CoreCivic est régulièrement mis en cause pour les conditions sanitaires dans ses centres. Une enquête de WIRED, publiée en juin 2025, a recensé de nombreux appels aux services d’urgence depuis des centres de détention de l’immigration gérés par CoreCivic. Les incidents signalés vont des crises médicales aux blessures, en passant par les tentatives de suicide, dans un contexte marqué par des accusations de retards de soins et de négligence médicale.
Fondée en 2003 dans le sillage des attentats du 11 septembre 2001, avec l’ambition de mettre l’analyse des données au service du renseignement et de la lutte antiterroriste, Palantir Technologies est aujourd’hui un prestataire majeur de l’ICE. Ses logiciels permettent notamment de croiser des données afin d’identifier les personnes ciblées par les opérations d’arrestation et d’expulsion.
Toutes ces entreprises, ainsi que celles qui construisent le mur à la frontière du Mexique, ont pour point commun d’avoir obtenu ces contrats lucratifs parce qu’elles ont financé de façon massive les campagnes de Donald Trump. Le groupe Geo a par exemple, selon les données de la commission électorale fédérale (FEC), versé plus de 4 millions de dollars au principal superPac (MAGA Inc.) ainsi qu’à divers comités à statuts divers qui financent les frais d’avocats de Donald Trump.
Si l’on est tenté de leur accorder le bénéfice du doute et de la « coïncidence », Geo a versé un autre million de dollars juste après avoir obtenu un contrat fédéral de 529 millions de dollars pour l’ouverture d’un centre de rétention dans le Colorado. Et, pour boucler la boucle, Donald Trump est actionnaire de ces entreprises dont les bénéfices ont augmenté de façon exponentielle : selon une enquête de CREW publiée en juillet 2026, ses courtiers ont effectué 29 opérations sur les actions de ces deux entreprises depuis son retour au pouvoir, alors même que leurs résultats financiers progressaient fortement.
Un effet sur les midterms ?
De ce panorama terrible émerge néanmoins un rayon de lumière : la solidarité que l’on voit à l’œuvre à Minneapolis, quand les habitants se mobilisent pour aider les sans-papiers et patrouillent pour alerter de l’arrivée de la police de l’immigration ; mais aussi, plus largement, le fait est que dans leur majorité, les Américains sont choqués que l’on arrête leurs voisins, la nounou de leurs enfants, leur jardinier ou l’aide-soignante qui s’occupe de leurs parents.
On ne saura sans doute jamais quel aura été le poids exact de ce sentiment dans les résultats des midterms du 3 novembre prochain, mais la brutalité de l’administration, si contraire à l’image que les Américains aiment à avoir d’eux-mêmes, aura sans doute joué un rôle. Si la victoire démocrate annoncée par les sondages se matérialise, elle sera en partie due à la réaction de l’électorat contre la brutalité des troupes de l’ICE et contre la corruption de Donald Trump et de son administration.

Anne E. Deysine ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 18:03
Europe, Chine, États-Unis : trois manières différentes de réguler l’IA
Jingyan Wu, Doctorante en sciences économiques, Université Côte d’Azur
Texte intégral (2216 mots)
L’ESSENTIEL
En matière d’IA, l’Union européenne, les États-Unis et la Chine combinent tous trois régulation, innovation et politique industrielle, malgré des approches institutionnelles distinctes.
Les trois puissances investissent dans les infrastructures, les compétences et l’industrie de l’IA, tout en cherchant à maîtriser les risques.
L’UE privilégie des obligations communes, les États-Unis des cadres de gestion des risques, et la Chine des obligations directes imposées aux fournisseurs.
Ces dernières années, les débats sur la régulation du numérique, et notamment de l’intelligence artificielle, sont souvent résumés à une opposition simple : faut-il réguler ou innover ? Une formule revient souvent pour résumer les approches de l’Union européenne (UE), des États-Unis et de la Chine : l’UE régule, les États-Unis innovent, et la Chine contrôle.
Cette formule est efficace, mais elle simplifie à l’excès. En apparence, les trois acteurs ont choisi des voies différentes. En réalité, ils font face à des dilemmes très proches : comment soutenir l’innovation tout en maîtrisant les risques sociaux liés à l’IA ? Comment développer leur propre industrie de l’IA et des infrastructures technologiques critiques, tout en pesant davantage sur les règles du jeu à l’échelle mondiale ?
La comparaison ne devrait donc pas porter seulement sur la question de savoir qui régule le plus. Il faut aussi regarder qui régule, quoi, pourquoi, et comment ces règles s’articulent avec l’industrie, les institutions et les priorités économiques de chacun.
Les trois modèles sont-ils vraiment si différents ?
Cette lecture en trois modèles n’est pas sans fondement. Au cours des vingt dernières années, les États-Unis, l’Union européenne et la Chine ont développé des traditions différentes en matière de gouvernance numérique.
Les États-Unis ont longtemps privilégié une approche relativement décentralisée et orientée vers le marché : il n’existe toujours pas de loi fédérale générale sur la protection des données personnelles, et l’encadrement des entreprises technologiques repose largement sur des outils juridiques existants, comme le droit de la concurrence ou la protection des consommateurs, mobilisés par différentes autorités de régulation.
L’Union européenne, à l’inverse, est intervenue plus tôt et de manière plus systématique sur les marchés numériques, à travers la protection des données, le droit de la concurrence et la régulation des plates-formes. Les droits fondamentaux, la protection des consommateurs et la concurrence équitable occupent une place centrale dans cette approche. Ces différences restent visibles dans la gouvernance de l’IA. L’approche américaine est généralement décrite comme plus sectorielle et fondée sur les risques, tandis que l’UE accorde davantage de place à l’éthique, à la protection des consommateurs et aux droits fondamentaux.
La Chine semble avoir suivi une autre voie. Depuis 2021, elle a adopté des règles spécifiques sur les algorithmes de recommandation, la synthèse profonde et l’IA générative, devenant ainsi l’un des premiers pays à instaurer des règles contraignantes pour certaines applications de l’IA. L’enregistrement des algorithmes, les obligations d’étiquetage des contenus générés par l’IA et les règles encadrant les systèmes de recommandation font de l’intervention de l’État l’un des traits les plus visibles de la gouvernance chinoise de l’IA.
Mais c’est précisément là que les étiquettes deviennent trompeuses : on risque de prendre la caractéristique la plus visible d’un système pour l’ensemble de sa logique. Des recherches détaillées sur l’élaboration de la réglementation chinoise de l’IA montrent que ces règles n’ont pas simplement été conçues au sommet puis appliquées telles quelles. Elles sont plutôt le résultat d’un processus progressif et itératif, auquel participent des fonctionnaires, des universitaires, des experts techniques, des journalistes et des entreprises technologiques.
Le débat public peut aussi contribuer à faire entrer certains sujets dans l’agenda réglementaire. En outre, les régulateurs chinois suivent de près les débats menés à l’étranger et en adaptent certaines idées. De la même manière, réduire l’UE au rôle de « régulateur » ou les États-Unis à celui d’« innovateur » revient à négliger d’autres objectifs présents dans leurs politiques respectives.
La formule « les États-Unis innovent, l’Union européenne régule, la Chine contrôle » peut donc constituer un bon point de départ, mais elle ne suffit pas. Elle met en lumière certains traits saillants, tout en risquant de transformer des priorités politiques en identités figées. Pour comprendre la gouvernance de l’IA aujourd’hui, il est plus utile de regarder comment chaque système combine ses institutions et ses instruments de politique publique.
De la régulation à la politique industrielle
« Plus on régule, moins on innove » : c’est l’une des idées les plus répandues dans les débats sur les politiques de l’IA. Pourtant, la relation entre régulation et innovation est loin d’être aussi simple. Anu Bradford (2024) rappelle que le succès du secteur technologique américain ne s’explique pas uniquement par un environnement réglementaire relativement souple, pas plus que la position plus fragile de l’Europe dans l’économie numérique ne peut être réduite à un excès de régulation. La profondeur des marchés de capitaux, la taille du marché, la mobilité des talents ou encore l’environnement entrepreneurial jouent eux aussi un rôle dans la capacité d’une économie à innover.
Surtout, les États-Unis, l’UE et la Chine ne choisissent pas simplement entre « régulation » et « innovation ». Tous trois cherchent activement à façonner leur industrie de l’IA, mais par des moyens différents. L’UE met en œuvre l’AI Act tout en investissant dans les infrastructures de calcul, les « AI factories » et les compétences, notamment à travers son plan d’action de 2025 pour un continent de l’IA, avec pour objectif explicite de renforcer la compétitivité européenne dans ce domaine.
Aux États-Unis, l’approche actuelle met davantage l’accent sur la réduction des obstacles réglementaires et sur l’innovation portée par le secteur privé. Mais le plan d’action américain sur l’IA de 2025 fait également des infrastructures d’IA et de la diffusion internationale des technologies et normes américains deux axes importants de l’action publique.
La Chine, de son côté, continue de renforcer les règles encadrant les algorithmes et l’IA générative, tout en lançant en 2025 l’initiative « AI Plus », destinée à accélérer l’intégration de l’IA dans la science et la technologie, l’industrie, la consommation et la gouvernance publique.
La différence ne tient donc pas au fait que certains « régulent » tandis que d’autres « innovent ». Régulation, investissement public, infrastructures, soutien industriel et stratégie internationale sont de plus en plus étroitement liés. Ce qui compte davantage, c’est la manière dont chacun combine ces instruments et arbitre entre innovation, gestion des risques et concurrence industrielle.
Des objectifs similaires, des outils différents
Dès que l’on quitte les grands slogans pour regarder les règles concrètes, les différences entre les trois approches apparaissent beaucoup plus clairement. Prenons l’exemple des modèles d’IA à usage général et de l’IA générative.
L’UE a choisi une approche relativement classique de régulation ex ante. Dans le cadre de l’AI Act, les fournisseurs de modèles d’IA à usage général doivent notamment préparer une documentation technique, mettre en place une politique en matière de droit d’auteur et publier un résumé du contenu utilisé pour l’entraînement, même si certains modèles open source bénéficient d’exemptions partielles en matière de documentation.
Les fournisseurs de modèles considérés comme présentant un risque systémique sont soumis à des obligations supplémentaires, notamment en matière d’évaluation et de réduction des risques, de signalement des incidents graves et de cybersécurité.
Les États-Unis partent d’une logique différente. Contrairement à l’UE, qui s’appuie sur une législation transversale pour imposer des obligations communes aux fournisseurs de modèles, les États-Unis continuent de s’appuyer largement sur des standards de gestion des risques et sur des instruments juridiques et réglementaires sectoriels déjà existants.
Le cadre de gestion des risques liés à l’IA élaboré par le National Institute of Standards and Technology (NIST) n’est pas juridiquement contraignant. Son profil consacré à l’IA générative vise surtout à aider les organisations à identifier les risques et à intégrer leur gestion dans la conception, le développement, l’utilisation et l’évaluation des systèmes d’IA. Autrement dit, il s’agit davantage d’indiquer comment les organisations devraient gérer les risques que d’imposer un ensemble unique d’obligations contraignantes à tous les fournisseurs de modèles d’IA à usage général.
La Chine fait davantage peser les responsabilités directement sur les fournisseurs de services d’IA destinés au grand public. Les mesures provisoires sur les services d’IA générative leur imposent notamment de traiter les contenus illicites et prévoient des obligations concernant les données d’entraînement, les informations personnelles, la propriété intellectuelle et l’étiquetage des contenus générés. Une nouvelle réglementation adoptée en 2025 est allée plus loin en instaurant des obligations de marquage explicite et implicite pour les contenus générés ou synthétiques par l’IA. Des règles antérieures sur les algorithmes de recommandation et les services de synthèse profonde avaient déjà instauré des obligations d’enregistrement ainsi que d’autres exigences pour les fournisseurs concernés.
Les différences ne se résument donc pas à une opposition entre régulation « stricte » et approche « souple ». Elles tiennent surtout au point d’entrée de la régulation et à la manière dont les responsabilités sont réparties : l’UE privilégie des obligations communes au niveau des fournisseurs de modèles ; les États-Unis s’appuient sur des cadres non contraignant de gestion des risques et sur les autorités sectorielles existantes ; la Chine impose plus directement des obligations aux fournisseurs de services algorithmiques et numériques, ainsi qu’aux contenus qu’ils diffusent.
Aux États-Unis, dans l’UE comme en Chine, les pouvoirs publics cherchent à développer leur industrie de l’IA, à maîtriser les risques technologiques et à peser sur les règles qui encadreront l’IA à l’avenir. Ce qui les distingue, ce sont surtout les trajectoires institutionnelles qu’ils empruntent et les instruments de politique publique qu’ils mobilisent.
Ce qui compte, dès lors, c’est la manière dont ces règles s’articulent avec les politiques industrielles, la structure des marchés et les institutions existantes, et comment cet ensemble façonne, au bout du compte, le développement et l’adoption de l’IA.
À mesure que l’intelligence artificielle s’intègre plus profondément dans la vie économique et sociale, la compétition pourrait ne plus se jouer seulement sur la capacité à développer les modèles les plus avancés. Elle portera aussi sur la capacité à construire un cadre de gouvernance qui soutienne le progrès technologique tout en restant socialement acceptable.

Jingyan Wu ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 18:02
Connaissez-vous le blé poulard ? Les leçons d’agronomie d’un blé ancien pourtant très moderne
Marie-Hélène Robin, Maitre de conférences, protection des cultures et agronomie, Ecole d'Ingénieurs de Purpan, Inrae
Texte intégral (2984 mots)
L’ESSENTIEL
Le blé poulard, proche du blé dur, est une espèce de blé ancien intéressante pour sa résistance face aux ravageurs et aux mauvaises conditions climatiques et pour sa diversité génétique.
Un projet de recherche participative, mené en Occitanie en collaboration avec des agriculteurs, s’est penché sur son potentiel en agriculture biologique.
Le blé poulard présente un potentiel particulièrement prometteur dans la production de pâtes alimentaires plus digestes.
Le blé constitue aujourd’hui un élément composant central de l’alimentation humaine. C’est une des cultures de base, avec l’orge, le maïs, le colza et le tournesol. Ces cinq cultures dominent aujourd’hui notre régime alimentaire, et représentent 83 % des surfaces de grandes cultures en France.
Il existe pourtant une autre catégorie, celle des cultures mineures, négligées ou sous-utilisées. Elles occupent moins de 20 000 hectares avec des productions inférieures à 40 000 tonnes par an. Utilisées pendant des siècles pour l’alimentation humaine, elles ont progressivement été délaissées pour des raisons agronomiques, génétiques, technologiques, économiques, culturelles ou politiques.
Dans un contexte marqué par le changement climatique et la dépendance aux pesticides, ces cultures mineures connaissent un regain d’intérêt. En tant que culture de diversification, leur intégration dans les rotations permet de rompre le cycle des bioagresseurs, contribuant à une diminution de l’usage de pesticides. Par ailleurs, ces cultures sont souvent peu exigeantes en nutriments, ce qui limite les besoins en engrais.
Majoritairement constituées de populations hétérogènes, elles offrent en effet une plus grande diversité de réponses face aux environnements changeants et une meilleure résistance aux stress biotiques (maladies, ravageurs, adventices) et abiotiques (météo, conditions des sols…). Malgré des rendements plus faibles et limitants, elles peuvent être plus stables dans les milieux défavorables et plus durables et résistantes face au changement climatique.
Dans le cadre du projet DIVINFOOD, qui s’inscrit dans une démarche de recherche participative visant à promouvoir des régimes alimentaires diversifiés et sains et des systèmes agricoles durables, nous nous sommes notamment intéressés, en Occitanie, au petit épeautre et au blé poulard (Triticum turgidum L. subsp. turgidum). Ce dernier, proche du blé dur, présente un potentiel prometteur, en particulier pour la production de pâtes.
Tendre, dur ou ancien ? La grande famille du blé
Le blé dur, à cassure vitreuse (caractéristique physique décrivant l’intérieur du grain) riche en protéines, est utilisé pour les pâtes et la semoule. Au contraire, le froment (blé tendre), à cassure farineuse, est plutôt destiné au pain et aux biscuits. De nombreuses variétés existent même si seules quelques variétés de blé tendre, très proches génétiquement les unes des autres, couvrent 80 % de l’assolement annuel.
Ces blés ont connu une sélection génétique intense après la seconde guerre mondiale pour obtenir des variétés à plus haut rendement : taille réduite, meilleure résistance aux maladies et à la verse (c’est-à-dire, lorsque les cultures se trouvent couchées au sol), grains plus gros et ne tombant plus au sol, enveloppes faciles à éliminer lors du battage, ou encore l’aptitude au pétrissage mécanique.

Les blés anciens correspondent à des céréales historiquement cultivées, peu sélectionnées génétiquement et conservant une forte diversité génétique. Ils regroupent notamment l’amidonnier, le blé poulard, le blé Khorasan ou encore le petit épeautre. Ils ont été cultivés pendant plusieurs siècles avant l’essor des variétés modernes au XIXᵉ siècle.
Les variétés anciennes ou paysannes sont issues de populations dynamiques présentant une grande variabilité génétique, ce qui les rend plus résistantes. Leur abandon progressif s’explique notamment par des rendements faibles, des pailles hautes favorisant la verse, un grain vêtu impliquant un décorticage ou encore des qualités technologiques inadaptées à l’industrie agroalimentaire (gluten peu panifiable, teneur en protéines variable…).
Toutefois, leur hétérogénéité génétique leur confère des atouts essentiels dans les contextes de changement climatique ou de crise énergétique. Elles présentent une meilleure tolérance aux maladies et aux stress abiotiques et exigences faibles en intrants, justifiant leur intérêt en agriculture biologique. Leur qualité nutritionnelle, notamment leur richesse en protéines, antioxydants et minéraux, contribue également au renouvellement d’intérêt pour ces ressources, dont la valorisation constitue aujourd’hui un axe de recherche pertinent.
À lire aussi : Les céréales existaient deux millions d’années avant l’invention de l’agriculture
Le blé poulard, un blé adapté aux sols pauvres
Le blé poulard, proche du blé dur, possède un grain nu. Cultivé en Europe au début du XIXᵉ dans les régions froides et montagneuses, il est adapté aux sols pauvres et présente une bonne résistance à certaines contraintes environnementales. La dureté de son grain explique son utilisation traditionnelle en biscuiterie ou pour la fabrication de pâtes.

Ses caractéristiques rustiques sont inadaptées pour l’agriculture industrialisée et expliquent son abandon, en particulier lorsque les blés durs plus productifs semés en Afrique du Nord coloniale sont arrivés et ont sonné la fin du blé poulard en métropole.
En effet, ses longues barbes sont contraignantes pour le battage, ses pailles hautes sensibles à la verse sur les sols riches, son rendement modeste (2 à 2,5 tonnes par hectare) et sa force boulangère est faible, ce qui le rend inadapté au pétrissage mécanique.
Malgré tout, son regain d’intérêt repose aujourd’hui sur ses bonnes performances agronomiques en agriculture biologique, ses qualités nutritionnelles et sur ses potentialités de transformations en pâtes dans les filières courtes et artisanales.
À lire aussi : « Industriel » ou « paysan » : quels pains et pâtes privilégier pour les hypersensibles au gluten ?
Des pâtes et même du pain plus digestes
Les blés anciens sont souvent valorisés dans des filières artisanales associant mouture sur meule de pierre, fermentation au levain et pétrissage lent, voire manuel. Leurs propriétés technologiques diffèrent de celles des blés modernes : un réseau de gluten plus fragile produisant des pâtes moins élastiques et plus délicates à travailler mécaniquement. Certaines céréales mineures présentent toutefois des caractéristiques de digestibilité des protéines (en particulier le gluten) qui suscitent un intérêt croissant.
Pour le poulard, proche du blé dur, les produits issus des farines sont principalement des pâtes, même si certains boulangers proposent des pains 100 % poulard. Les pâtes au blé poulard sont fabriquées à base de farine fraîche, avec extrusion et séchage à basse température.
Ainsi, à la différence des filières industrielles utilisant des blés modernes, les pâtes artisanales sont souvent fabriquées avec de la farine directement – et non de la semoule – à cause d’une dureté du grain insuffisante pour donner de la semoule après écrasement, en lien avec le moindre apport d’azote en agriculture biologique. Ce process de fabrication, avec extrusion non contrôlée et séchage à température ambiante, favorise la présence de protéines plus facilement solubilisées, et donc plus digestes.
Dans le cadre du projet de recherche DIVINFOOD, un partenariat a été noué avec L’Odyssée d’engrain, une société coopérative d’intérêt collectif (Scic) réunissant des paysans et des consommateurs, avec la volonté de remettre en culture d’anciennes variétés de céréales, grâce à la fabrication de pâtes sèches locales, artisanales et biologiques.
À lire aussi : La lutte pour une agriculture libre : bricoler et partager pour s’émanciper
Une démarche qui valorise les connaissances des agriculteurs
Les paysans pratiquant l’agriculture biologique s’intéressent de plus en plus à la diversité génétique présente dans les variétés anciennes. Leurs connaissances approfondies des systèmes de culture – et notamment des variétés qui conviennent le mieux à leur terroir – sont complémentaires des compétences des chercheurs et des sélectionneurs.
Développer des modèles de collaboration entre réseaux de paysans et de chercheurs est donc un enjeu important, dans cette démarche d’innovation variétale pour l’agriculture biologique et l’agriculture à faible niveau d’intrants.
Cette démarche collaborative a été retenue dans DIVINFOOD pour évaluer les performances de différentes variétés de blé poulard avec des échanges réguliers entre parcelles agricoles et plateforme expérimentale.

Nos travaux de recherche poursuivent actuellement cette démarche participative. Celle-ci a plusieurs dimensions :
dimension agronomique et sanitaire : suivre les paysans pour évaluer et donner des préconisations. L’enjeu est d’améliorer les performances et la qualité des blés poulard produits et de contribuer à proposer une variété ou un mélange les plus adaptés ;
dimension nutritionnelle : développer une méthode d’analyse pour déterminer les profils protéiques des blés et la taille des protéines impliquées dans la formation du réseau de gluten. Autrement dit, d’identifier les profils de blés les plus adaptés pour personnes hypersensibles au gluten ;
dimension technologique : identifier les variétés les plus aptes à la transformation en pâtes alimentaires ;
dimension sensorielle : discriminer les différences de qualité organoleptique des produits finis afin d’obtenir des produits non seulement vertueux mais gustativement bons.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

DIVINFOOD a été financé par le programme de recherche et d’innovation Horizon 2020 de l’Union européenne dans le cadre de l’accord de subvention n°101000383
13.10.2026 à 18:02
Sciences ou entrepreneuriat ? Comment les témoignages vidéo de professionnels influencent les choix d’orientation des jeunes
Thomas Astebro, Professeur économie et science de la décision, HEC Paris Business School
Mathis Schulte, Professeur associé - Management et ressources humaines, HEC Paris Business School
Texte intégral (1834 mots)
L’ESSENTIEL
Les témoignages de professionnels et la rencontre avec des « role models » influencent les choix d’orientation des jeunes.
Mais les effets ne vont pas toujours dans le sens escompté.
Une vaste étude dans des lycées équatoriens explore ces enjeux pour les sciences et l’entrepreneuriat.
Quels moyens les lycées peuvent-ils mobiliser pour élargir les horizons professionnels des élèves lorsqu’ils doivent toucher des milliers d’adolescents, aux centres d’intérêt très différents ? Leur présenter des modèles inspirants semble être l’une des réponses possibles. Et une vaste étude publiée dans Nature Human Behaviour montre qu’effectivement, les vidéos présentant des parcours professionnels peuvent influencer les choix réels d’orientation dans l’enseignement supérieur.
Mais le résultat en est contre-intuitif : après avoir vu des vidéos présentant à la fois des scientifiques et des entrepreneurs à succès, les élèves se sont détournés des filières STEM – sciences, technologies, ingénierie et mathématiques.
Cette conclusion, issue d’une étude menée sur neuf ans dans 813 établissements en Équateur, dépasse le seul cas de ce pays. Elle concerne aussi d’autres pays en développement confrontés aux défis du capital humain, du financement de l’éducation et du déploiement des technologies d’apprentissage à grande échelle. À notre connaissance, c’est la première fois qu’un tel effet est observé.
Une expérimentation nationale intégrée à la politique scolaire
L’expérimentation faisait partie de « Showing Life Opportunities », une collaboration plus large avec le ministère équatorien de l’éducation, conçue pour promouvoir l’apprentissage des sciences et de l’entrepreneuriat. Elle a été intégrée à l’enseignement à distance pendant la pandémie, auprès d’élèves en dernière année de lycée technique. En incluant un pré-test, le programme de recherche dans son ensemble a concerné près de 35 000 élèves.
Le cœur de l’essai a porté sur 29 243 élèves dans 813 lycées. La moitié des établissements a reçu des vidéos de modèles inspirants ; l’autre moitié a regardé des contenus éducatifs classiques diffusés par la chaîne EducaTV du ministère, sur des thèmes comme l’amour ou la musique. Les élèves du premier groupe exposé ont suivi deux séances de 30 minutes, composées d’extraits d’entretiens avec dix scientifiques équatoriens et dix entrepreneurs équatoriens.
Les vidéos avaient été conçues pour dépasser le récit héroïque d’une seule réussite individuelle. Parmi les scientifiques figuraient notamment une ingénieure électricienne ayant développé un dispositif pour aider les personnes malvoyantes, une scientifique de l’environnement titulaire d’un brevet utilisant des déchets de crabe pour la remédiation environnementale, ainsi qu’une biologiste moléculaire travaillant sur le cancer. Parmi les entrepreneurs, il y avait des dirigeants d’entreprises dans le café durable, le tourisme et les vêtements créatifs pour bébés. Les modèles présentés étaient de jeunes Équatoriens, sélectionnés de manière à refléter une diversité de genre, de région et d’origine ethnique.
Un résultat contraire à l’objectif initial
L’intervention visait à informer et à inspirer les élèves, afin de les encourager à envisager des carrières dans les sciences et technologies ou dans l’entrepreneuriat à forte croissance. Mais les résultats ont dessiné d’autres perspectives.
Chez les filles entrées dans l’enseignement supérieur, l’exposition aux vidéos a réduit les inscriptions dans les filières STEM (sciences, technologies, ingénierie et mathématiques) de 5,0 points de pourcentage, soit une baisse de 18 % par rapport à la moyenne du groupe témoin. Elle a parallèlement augmenté les inscriptions dans les filières business de 5,7 points de pourcentage. Ces filières étaient déjà majoritairement féminines, et l’intervention a accentué cette tendance.
Chez les garçons entrés dans l’enseignement supérieur, les vidéos ont réduit les inscriptions en STEM de 4,9 points de pourcentage, soit une baisse de 7 % par rapport à la moyenne du groupe témoin. Les garçons se sont principalement réorientés vers d’autres domaines, l’étude identifiant des hausses dans l’agriculture, les sciences humaines et les arts, à partir de niveaux initiaux faibles.
Dans l’échantillon, un tiers des élèves se sont inscrits dans l’enseignement supérieur. Parmi les élèves du groupe témoin ayant poursuivi des études supérieures, 68,6 % des garçons ont choisi des filières STEM, contre 28,5 % des filles.
Ce que les élèves ont semblé comparer
Dans les vidéos, les élèves ont vu des personnes ayant réussi dans deux grands domaines, ce qui leur a permis de les comparer. Une évaluation ultérieure a demandé à 110 élèves de regarder les vidéos et de noter les modèles inspirants selon sept critères : passion, charisme, similarité perçue, renforcement des stéréotypes de genre, difficulté apparente du domaine, quantité d’informations pertinentes fournies par la vidéo et stigmatisation.
Ces dimensions aident à comprendre les effets observés. Les élèves ont perçu les modèles scientifiques comme rendant leur domaine plus difficile que l’entrepreneuriat. Ils ont également considéré la voie scientifique comme plus masculine et plus stigmatisée. Les modèles scientifiques ont aussi été moins bien notés en termes de pertinence, de passion, de charisme et de similarité avec les élèves eux-mêmes.
Nous pensons que le contraste entre les domaines a contribué à détourner les élèves de la voie perçue comme la plus difficile. Les résultats suggèrent également que l’exposition à de nombreux modèles peut conduire les élèves à comparer les points communs et les différences entre plusieurs domaines, plutôt qu’à s’identifier à une histoire individuelle particulièrement inspirante.
Par rapport aux études antérieures sur les modèles inspirants, qui portaient généralement sur la rencontre avec un seul modèle, le fait de voir plusieurs modèles a probablement amené les élèves à comparer leurs caractéristiques communes et distinctives – ce qui, au final, a pu rendre certains d’entre eux plus susceptibles de s’éloigner des STEM.
Le genre des modèles a peu modifié les résultats
L’étude a également testé l’effet de la composition genrée des modèles inspirants. En moyenne, les élèves voyaient un ensemble équilibré, mais l’assignation aléatoire faisait que certains voyaient davantage de femmes ou davantage d’hommes dans une catégorie donnée.
Les choix de filière ont peu varié en fonction de cette composition. Voir principalement des femmes scientifiques n’a pas significativement atténué l’effet principal.
Pour les décideurs publics, l’impact de l’étude tient à deux résultats qu’il faut considérer conjointement. Les modèles inspirants digitaux peuvent être diffusés à grande échelle, à faible coût et avec un taux élevé de complétion ; ils peuvent aussi modifier les comportements réels d’inscription dans l’enseignement supérieur. Mais lorsque les élèves observent plusieurs domaines successivement, leurs choix peuvent évoluer dans des directions que les responsables politiques n’avaient pas anticipées.
Notre article ne dit pas si les changements d’orientation observés ont été bénéfiques ou préjudiciables pour les élèves. Pour le savoir, il faudrait les suivre pendant plusieurs années afin de mesurer leurs revenus, leur satisfaction et leurs trajectoires sur le marché du travail. Ce que nous pouvons affirmer, c’est que ce qui est préférable pour un élève à titre individuel peut différer des priorités collectives.
L’enseignement pratique est donc clair : l’exposition fonctionne, le passage à l’échelle est possible, et la combinaison des contenus façonne la direction des choix.
L’étude a été coécrite par Igor Asanov, Thomas Åstebro, Guido Buenstorf, Bruno Crépon, Francisco P. Flores-Taipe, David McKenzie, Mona Mensmann et Mathis Schulte. Une version en anglais de l’article est à retrouver ici.

Thomas Astebro a reçu des financements: the World Bank’s Strategic Impact Evaluation Fund funding Nimble Evaluations—received by I.A., T.A., G.B., B.C., D.M. and M.M.; the funding call COVID-19 Emergency Window received by I.A., B.C., D.M., M.M., and M.S.; the Innovations for Poverty Action ‘Path-to-Scale’ award (TEM0280-X1)—recevied by I.A., T.Å., G.B., B.C., F.P.F.T., D.M., M.M., and M.S.; the Laboratory of Excellence in Economics and Decision Sciences, Ecole Nationale de la Statistique (Labex ECODEC–ENSAE) Paris, the HEC Foundation—recevied by T.Å. and B.C.; the International Center for Higher Education Research (Kassel) Innovation Fund-2018—received by I.A., G.B. and F.P.F.T.; and the Innovation Growth Lab—received by I.A.,T.Å., G.B., F.P.F.T., D.M. and M.S. M.M.’s work was funded by the Deutsche Forschungsgemeinschaft (German Research Foundation) under Germany’s Excellence Strategy—EXC 2126/1–390838866. A.-M. Noha provided excellent research assistance. The funders had no role in study design, data collection and analysis, decision to publish or preparation of the manuscript.
Mathis Schulte ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 18:01
Ruée anticipative début mars puis effondrement en septembre : comment expliquer la consommation de carburant en France en 2026 ?
Solène Collot, Assistant Professor of Finance, IÉSEG School of Management
Texte intégral (1796 mots)
L’ESSENTIEL :
En mars 2026, les consommateurs se précipitent à la pompe avant la hausse des prix. Une véritable ruée bancaire.
En septembre, face à un gazole à 2,41 euros le litre, la consommation chute de 30 % en dix jours.
Les deux comportements renvoient à des mécanismes opposés : en mars, les ménages anticipent une hausse à venir ; en septembre, ils réagissent à un prix déjà élevé.
Si, en mars 2026, chaque consommateur français achète de l’essence en craignant que les autres ne le fassent avant lui et que le prix du carburant augmente, en septembre, c’est une tout autre histoire. Ils ne veulent plus payer un prix exorbitant. Une étude rappelle que quand le prix monte de 1 %, les volumes achetés par les consommateurs baissent de 0,21 % à 0,40 % à court terme.
Afin de mieux comprendre les variations de la consommation de carburant en France en 2026, penchons-nous sur les études de l’Insee.
Une première étude de l’Insee de juillet 2023, réalisée à partir de la flambée des cours du pétrole en 2022 et des remises à la pompe suite à la guerre en Ukraine, a mesuré la manière dont les automobilistes réagissent quand le prix du carburant augmente. Nous la complétons avec les données récentes de l’Insee de mars 2026.
La conclusion ? Le choc pétrolier de 2026 offre un cas d’école rare : la même population – française – face au même bien – le carburant – adopte en l’espace de six mois deux comportements que l’analyse économique classique décrit séparément. Un phénomène comparable à la ruée bancaire d’une part, puis un ajustement rationnel de la demande à un prix devenu dissuasif d’autre part.
Entre les deux, un État qui n’intervient pas davantage à cause d’un déficit public important.
En mars, ruée anticipative sur le plein
Le 28 février 2026, les États-Unis et Israël déclenchent une opération militaire contre l’Iran. Téhéran bloque le détroit d’Ormuz, par lequel transite environ un cinquième du pétrole et du gaz mondiaux. Le baril de pétrole brut, qui valait 71 dollars états-uniens (plus de 63 euros) le 26 février 2026, dépasse 112 dollars (plus de 100 euros) trois semaines plus tard, le 20 mars 2026.
Le choc se transmet à la pompe française : les prix augmentent en moyenne de 17 % sur le mois de mars 2026, et de 25 % fin mars par rapport à fin février 2026.
Les paiements par carte bancaire dans les stations-service doublent en quarante-huit heures. Plus de 6 millions de demandes d’autorisations de paiement sont enregistrées les lundi 2 et mardi 3 mars 2026, soit deux fois plus qu’un jour de semaine ordinaire. Les consommateurs se précipitent à la pompe afin de devancer la hausse.

Les ménages interrogés par l’Insee anticipent début mars 2026 une hausse générale des prix. L’inflation attendue à un an passe de 3 % à 5 % (médiane).
Ruée bancaire
Ce réflexe ressemble à une « ruée bancaire », dit bank run en anglais, telle que décrite en 1983 par les économistes Douglas Diamond et Philip Dybvig, Prix de la Banque de Suède en sciences économiques en mémoire d’Alfred Nobel en 2022.
Un épargnant retire son argent de la banque, non pas parce que l’établissement de crédit va mal, mais de peur que les autres épargnants retirent le leur avant lui. Sa peur et l’anticipation qui en résulte provoquent ce que l’épargnant redoutait tant : la banque ne peut pas le rembourser quand un grand nombre d’épargnants retirent leurs fonds en même temps. La prophétie devient autoréalisatrice.
Le consommateur d’essence ne craint pas pour son argent sur son compte en banque, mais il redoute l’augmentation du prix du carburant. Il fait le plein avant une potentielle « ruée bancaire ».
L’« élasticité-prix »
Six mois plus tard, les tensions reprennent au Moyen-Orient et le prix du gazole remonte pour atteindre un record de 2,41 euros le litre en moyenne nationale le 20 septembre 2026. La consommation de carburant baisse de 30 % en dix jours entre le 11 et le 20 septembre 2026.
Cette chute n’a rien de surprenant. Afin d’analyser la sensibilité de la demande de carburant aux prix, l’étude de l’Insee de juillet 2023 mesure ce que les économistes appellent l’ « élasticité-prix ». Quand le prix augmente de 1 %, de combien baissent les quantités achetées ?
À lire aussi : Pourquoi le prix de l’essence à la pompe ne baisse pas aussi vite qu’il monte
Quand les consommateurs savent qu’un prix va changer, ils décalent leurs achats ; ils remplissent leur réservoir juste avant une hausse annoncée ou attendent à l’inverse une remise commerciale pour remplir leur réservoir.
De l’importance des données bancaires
C’est ainsi que l’anticipation d’une baisse ou d’une hausse d’un prix affecte le timing de la demande – ici de carburant. Le modèle décrit dans l’étude de l’Insee de juillet 2023 se fonde sur une « fenêtre d’anticipation », afin que seul le prix du carburant affecte sa quantité demandée sur la période. Concrètement, l’élasticité-prix de la demande obtenue reflète la réaction des consommateurs aux variations du prix, et non aux anticipations de ce prix.
Les données bancaires sont enregistrées à une fréquence transactionnelle, c’est-à-dire à chaque paiement, offrant alors une granularité journalière. Elles isolent les caractéristiques de l’anticipation : le pic – ou le creux – de consommation avant une nouvelle hausse – ou baisse – de prix et le creux – ou le pic – juste après.
Ces variations soudaines de consommation ne seraient pas identifiables avec des données hebdomadaires ou mensuelles, car elles se compenseraient en partie dans la moyenne.
Une fois l’effet des anticipations neutralisé, il reste la réaction des consommateurs au prix modélisée par l’élasticité-prix. Elle est comprise entre – 0,40 et – 0,21, ce qui signifie que lorsque le prix monte de 1 % les volumes de carburants achetés baissent de 0,21 % à 0,40 % à court terme.
L’élasticité-prix moyenne varie sensiblement avec la consommation de carburant, mais elle dépend peu du revenu ou du type d’habitat. Les « petits rouleurs », ceux qui parcourent peu de kilomètres, peuvent davantage se permettre de réduire leur consommation en cas de hausse des prix que les « gros rouleurs ».
Ce que fait l’État
L’État subit les effets de la baisse de consommation de carburant. Au 30 septembre 2026, les recettes de carburant de l’État affichent une moins-value de 383 millions d’euros par rapport à la même période l’an dernier. Bien que la TVA rapporte 798 millions d’euros de plus, les recettes de la taxe sur les carburants, les accises, reculent de 1,18 milliard d’euros par rapport à l’an dernier. Le gouvernement écarte la prise de mesure comme la baisse des taxes ou le blocage des prix en raison du déficit public.
Si les prix montaient encore, quelle serait alors la réaction des consommateurs ? Feraient-ils une nouvelle ruée par peur d’une hausse suivante ? ou réduiraient-ils encore leur consommation ? Sur la base des deux réactions opposées observées en 2026, nous ne pouvons pas savoir ce qui l’emporterait.

Solène Collot ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 17:59
Au château de Chambord, cinq siècles de plaisirs gastronomiques
Loïc Bienassis, Historien du culinaire et des pratiques alimentaires, Université de Tours
Texte intégral (4318 mots)
L’ESSENTIEL
Retracer l’histoire du boire et du manger au château de Chambord, dans le Loir-et-Cher, c’est croiser François Ier, Louis XIV, le maréchal de Saxe et Lady Diana.
L’exposition « Les festins de Chambord », qui se tient jusqu’au 24 janvier 2027, restitue l’histoire gourmande du château, de la Renaissance à nos jours, à travers la reconstitution de quatre tablées correspondant à des repas emblématiques.
Pour construire une telle exposition, les commissaires se sont heurtés aux lacunes des archives. Loïc Bienassis, co-commissaire de l’exposition, nous livre quelques-uns des indices historiques qui permettent de raconter au plus près l’évolution des goûts, des usages et des arts de la table à Chambord.
C’est en septembre 1519 que François Ier lance le chantier de Chambord. Le donjon cantonné de quatre tours rondes, aujourd’hui célèbre dans le monde entier et cœur de l’édifice, est pour l’essentiel achevé vingt ans plus tard. Pour autant, entre 1519 et sa mort, en 1547, François Ier ne séjourne qu’à quinze reprises en son domaine solognot, soit 85 jours au total.
À moins de trouvailles futures, aucun document ne nous renseigne sur ce que le souverain a pu manger à Chambord, qu’il s’agisse de ses repas ordinaires ou de ses festins. Certains ouvrages reproduisent bien un menu de 16 plats qui aurait été servi au roi à la Mi-Carême 1545 : du cerf en potage, des huîtres rôties, des grenouilles frites au persil… Il s’agit hélas d’une pure fabrication, forgée de toutes pièces au début des années 1990 par un auteur dont nous tairons le nom, et maintes fois reprise depuis.
On ignore même où François Ier prenait ses repas. Tout au plus peut-on supposer que, après 1545, selon les usages du temps, il se faisait servir dans son logis alors tout juste achevé, dans sa chambre ou dans la grande salle, qui, avec ses 250 mètres carrés, pouvait accueillir de grands banquets.
Belle illustration de ce silence des sources, le passage de Charles Quint à Chambord, le 18 décembre 1539, n’a guère laissé de traces. Le château se résume alors au donjon, tout juste achevé, et l’élévation des ailes ne fait que commencer. L’empereur passe la nuit dans l’une des tours de ce corps central. « Dîner à la chasse, coucher à Chambord », se contente de noter son secrétaire.

Plus largement, c’est la cuisine française de la Renaissance dans son ensemble qui reste mal connue : le Livre de cuysine tres utille et prouffitable (vers 1540) est en effet le seul livre de cuisine véritablement nouveau publié dans le royaume au XVIᵉ siècle. La cuisine aristocratique qu’il expose s’inscrit d’abord dans la continuité du Moyen Âge : sauces sans matière grasse, liées au pain grillé ou aux jaunes d’œufs, goût prononcé pour l’acidité, omniprésence des épices. On y relève cependant deux inflexions notables. Le sucre, alors considéré comme une épice, entre dans un très grand nombre de recettes, et le beurre s’impose comme la première des matières grasses.

Louis XIV à table avec ces dames
Revenons à Chambord, en enjambant les décennies : il faut attendre Gaston d’Orléans, frère de Louis XIII, qui vit à Blois une petite vingtaine d’années (de 1634 à 1643 puis de 1652 à 1660), pour qu’une personnalité de premier plan fréquente régulièrement ce glorieux palais.
Louis XIV se montre lui aussi sensible aux charmes du monument : il y prend ses quartiers à plusieurs reprises (en 1668, en 1669, en 1670, en 1682, en 1684 et en 1685), pour des séjours de trois semaines en moyenne, saison de la chasse oblige. En 1684 et en 1685, les repas se tiennent chez la Dauphine, dans la première antichambre de son appartement, désignée comme la « salle où le roi mange », au premier étage du donjon. « On mange toujours avec le Roi et cela fait une familiarité très agréable », écrit Madame de Maintenon en 1684. Et le marquis de Dangeau de préciser en 1685 :
« Le roi donne à manger à toutes les dames qui ont suivi la cour, et la table est de 25 couverts. »
Un document exceptionnel, conservé à la Bibliothèque nationale de France, nous fait entrer dans cette salle : un plan de table annoté « pour Chambord en 1685 ». Il représente une grande table ovale de « 20 pieds de long » sur « 8 pieds de large », soit 6,50 m sur 2,60 m, prévue pour 28 convives au côté du roi et de la Dauphine. Le dessin indique la disposition des plats pour le premier service d’un repas de la mi-journée, alors appelé « dîner ». Les assiettes occupent le bord de la table. Juste devant elles court une première rangée de 21 « petites entrées », parmi lesquelles s’intercalent à intervalles réguliers quatre plats de figues et quatre plats de melons. Plus près du centre, une seconde rangée fait se succéder, un à un, 14 potages et 14 entrées.
Ce plan illustre à merveille ce que les historiens appellent le « service à la française ». Chaque mets y reçoit un emplacement précis, selon une symétrie rigoureuse, et lorsque vient le service suivant, chaque plat est « relevé », c’est-à-dire remplacé par un autre posé exactement au même endroit.
Un autre document rare, aujourd’hui conservé dans une collection particulière, complète ce tableau. Intitulé « Pour les disners que doibt donner Sa Majesté au voyage de Chambor, en Septembre 1684 », il récapitule les repas prévus pour les occupants des différentes voitures du cortège royal en route vers la Sologne. Les sept passagers du carrosse du roi doivent ainsi recevoir « quatre petits potages, une grande entrée et quatre petites, un plat de rôt, quatre petits plats d’entremets, deux salades, deux plats de fruit et quatre compotes ». À l’autre extrémité de la liste, les officiers des gardes du corps ont droit à « du pain et du vin », mais aussi à « la desserte de la table du roi », c’est-à-dire aux plats qui en ont été retirés.
Le maréchal de Saxe et ses breuvages
Quarante ans plus tard, une autre tête couronnée, déchue celle-là, honore le château de sa présence. Stanislas Leszczynski, roi de Pologne en exil et beau-père de Louis XV, réside à Chambord de 1725 à 1733. Se fit-il préparer des babas en Sologne, lui que l’on crédite souvent, sans preuve véritable, d’avoir importé ce gâteau en France ?
Maurice de Saxe se retire en ces terres en 1748, après une glorieuse carrière militaire au service du roi de France. Il fait du domaine « un second Versailles », aux dires du mémorialiste Dufort de Cheverny. Une lettre anonyme publiée peu après sa mort évoque son régiment de dragons, ses uhlans, ses « 400 chevaux de chasse, de monture & de carrosse », son théâtre et… ses 35 cuisiniers, sans compter leurs aides. Rotisset, son prétendu maître-queux et supposé inventeur de la carpe à la Chambord, n’a en revanche jamais existé.
Avec le maréchal de Saxe, que le duc de Croÿ qualifie d’« extrêmement gourmand », la localisation des repas ne fait plus de doute. L’ancienne première antichambre de Louis XIV, où il expose ses trophées, la « salle des drapeaux », sert de « salle à manger » – une pièce nouvelle qui s’impose dans les riches demeures au cours du XVIIIᵉ siècle. Contiguë, une « salle du caffé » accueille les convives pour les boissons d’après-repas. La consommation des « liqueurs chaudes » – café, thé et chocolat – est alors en plein essor : « C’est une mode presque générale à Paris, que de prendre une tasse de café après le dîner », constatait vingt ans plus tôt le voyageur allemand Joachim Christoph Nemeitz.

Les inventaires dressés après la mort de l’homme de guerre, en 1750, apportent une foule de renseignements sur la vie matérielle du temps. Pour ne donner qu’un exemple, on recense dans ses caves 472 bouteilles de champagne. En devenant mousseux quelques décennies auparavant, le champagne s’est en effet imposé comme le vin par excellence de la fête aristocratique. Un noceur de l’acabit du maréchal de Saxe se devait d’être prévoyant. La cave compte également 175 bouteilles de chablis blanc, 12 de ratafia de fleurs d’orange, neuf de ratafia rouge, du vin d’Issoudun et des vins d’office et de cuisine pour la domesticité.
Fêtes du XIXᵉ siècle
Après le départ des Polignac, émigrés dès 1789, et jusqu’à la fin du XIXᵉ siècle, plus aucun hôte de marque n’élira domicile à Chambord. Le château n’est pas pour autant tout à fait déserté, et quelques réjouissances le sortent parfois de sa torpeur.
Le 12 mai 1830, la duchesse de Berry, belle-fille de Charles X, y reçoit ses parents, le roi et la reine des Deux-Siciles. Les curieux se pressent, comme le relate le préfet de Loir-et-Cher :
« Un superbe déjeuner, servi par Chevet, avait été préparé pour les augustes voyageurs. On permit au public, selon un ancien usage princier, de circuler autour de la table et de se donner le singulier plaisir de convoiter des yeux et humer les vapeurs des mets savoureux dont les convives se repaissaient très substantiellement. »
Chevet, fournisseur officiel de Charles X, comptait parmi les « maisons de comestibles » parisiennes les plus réputées.
Le 29 septembre 1879, les légitimistes fêtent au château les 59 ans du comte de Chambord, prétendant au trône toujours en exil. Plus de 1 200 convives se retrouvent sous une immense tente, et Potel et Chabot affrète trois wagons pour acheminer le matériel et les produits. Au menu : potage à la royale, pâtés de gibier truffés, gâteaux au rhum, champagne.
En 1883, le domaine revient aux princes de Bourbon-Parme, qui n’y font que de brefs séjours, deux semaines tout au plus. Chose nouvelle, ils ouvrent le château au monde extérieur. Ainsi, exemple parmi d’autres, le 13 juin 1899, le septième congrès de la Loire navigable se tient au château. Et le comité blésois régale ses invités :
Hors d’œuvres variés
Petits pâtés à l’alsacienne
Saumon sauce crevette
Filet de bœuf renaissance
Petits pois nouveaux à la française
Poularde du Mans rôtie
Salade de saison
Savarin au rhum
Fruits et petits gâteaux.
Et pour escorter ces plats : saint-émilion, vouvray mousseux, café, cognac.
Quand la République reçoit
Devenu propriété de l’État en 1930, Chambord a accueilli, au fil des décennies, chefs d’État et réceptions. Le 28 mars 1987, le président Mitterrand et le chancelier Helmut Kohl y déjeunent de paupiette de saumon de Loire à la mousse de sandre. Ils boivent du puligny-montrachet, du château batailley et du Krug – mais pas de vin de Loire ! De 1965 au milieu des années 1990, les chasses présidentielles réunissent à Chambord décideurs et diplomates autour de menus simples, servis à l’hôtel Saint-Michel : crème Saint-Germain, turbot sauce hollandaise, tarte Tatin, bourgueil.
Reste le plus mémorable des repas contemporains. Le 9 novembre 1988, le prince Charles et Lady Diana visitent le château avec le ministre de la culture Jack Lang. Le soir, un dîner de gala réunit 46 personnes au second étage du donjon, dont Caroline de Monaco et Isabelle Huppert. Le chef Bernard Robin, du Relais de Bracieux, est aux fourneaux.
Henri Gault note chaque plat dans Paris-Match. Il donne 8,5 sur 10 aux saint-jacques au foie gras et aux petits cèpes de Sologne, et 9,5 sur 10, « un grand moment », aux filets de pigeonneau et à leur millefeuille de halicot. Le gratin d’oranges au Grand Marnier n’obtient que 7 sur 10. Côté vins, vouvray pétillant, pouilly fumé, chinon « Clos de l’Écho » 1976 et coteaux du layon : cette fois, la Loire est à l’honneur. Moyenne générale : 8,5 sur 10.
Entre la mention laconique du secrétaire de Charles Quint et les notes d’Henri Gault, les sources font, on l’aura compris, régulièrement défaut pour retracer l’histoire gourmande de Chambord. Souvent, ce sont les découvertes archéologiques qui se chargent d’apporter les éclairages les plus précieux, à l’image des nombreuses coquilles d’huîtres exhumées des fosses du XVIIIᵉ siècle.
Quant aux légendes – menu imaginaire de François Ier, babas de Stanislas ou carpe de l’introuvable Rotisset –, l’historien de la gastronomie doit, comme toujours, tenter de démêler le vrai du faux, tout en sachant qu’elles offrent d’attrayantes réponses là où lui aime à poser des questions.
__
Loïc Bienassis est l’auteur d’À la table du château de Chambord, paru en 2024 aux éditions PUFR. Il est également – avec l’historienne et chargée de recherches au Domaine national de Chambord Virginie Berdal – co-commissaire de l’exposition « Les festins de Chambord ».
Cet article est publié dans le cadre de la Fête de la science (qui a eu lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Loïc Bienassis ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 17:25
Quiz – Connaissez-vous vraiment l’histoire du riz ?
Cécile Vangrevenynge, Chargée de marketing digital et des partenariats, The Conversation
Lire + (267 mots)
Le riz accompagne l’humanité depuis des milliers d’années. De ses origines préhistoriques à sa diffusion sur tous les continents, cette céréale a façonné les cultures, les échanges commerciaux et les habitudes alimentaires de nombreuses populations.
Mais que savons-nous vraiment de son histoire, de son voyage à travers le monde et des défis environnementaux liés à sa culture ?
À vous de tester vos connaissances !
Avant de jouer, prenez quelques minutes pour lire l’article « Le long voyage du riz, de la préhistoire aux rizières du monde entier ».
3, 2, 1… À vous !
Pour recevoir le quiz chaque semaine dans votre boîte mail, abonnez-vous à notre newsletter hebdomadaire le Débrief.
Chaque samedi, un pas de côté sur l’actu pour mieux comprendre le monde qui nous entoure.

13.10.2026 à 16:57
Navi Pillay’s Nobel Peace Prize is an example of how international law trumps the law of the jungle
Chloé Maurel, SIRICE (Université Paris 1/Paris IV), Université Paris 1 Panthéon-Sorbonne
Texte intégral (2073 mots)
KEY TAKEAWAYS
In awarding the honour to Navi Pillay, a former UN High Commissioner for Human Rights and a leading figure in international criminal justice, the Nobel Committee places defending victims and the responsibility of states at the heart of building peace.
The choice is particularly significant at a time when multilateral institutions are weakened and international crimes go largely unpunished.
The decision can also be read as a repudiation inflicted on Donald Trump, who asserted (as he did the year before) that the prize should go to him.
On October 9, 2026, in Oslo, the Norwegian Nobel Committee awarded its Peace Prize to Navanethem “Navi” Pillay, an 85-year-old South African jurist, for her commitment to peace and international law. The committee chair, Jørgen Watne Frydnes, honoured a career dedicated to holding states and their leaders accountable for their actions, as well as giving hope to the victims of violence and conflict. The committee placed particular emphasis on the laureate’s contribution to the consolidation of an international legal order capable of prosecuting war crimes, crimes against humanity, and genocide.
This distinction goes far beyond the consecration of an individual career. It poses a central question of political science: how to build peace when the military balance of power, national interests, and the calculations of great powers tend to prevail over common rules?
In honouring Navi Pillay, the committee recalls that peace is not reduced to a truce in fighting or deals struck between leaders. It also alludes to justice, the recognition of victims and the existence of mechanisms for punishing those responsible for crimes. In doing so the Nobel Committee highlights the principles of international law upheld by the UN, which did not miss the opportunity to promptly congratulate itself, taking credit for the prize that was awarded to one of its former officials.
A lawyer born under apartheid and figurehead of international justice
Born on September 23 1941, in Durban, to a South African family of Indian Tamil origin, Navi Pillay grew up under the apartheid regime institutionalised from 1948. Racial segregation dictated access to housing, education, employment and political representation. Despite coming from a community that was subject to multiple discriminations, she managed to study law and become a lawyer.
In 1967, she opened the first female-led law firm in Natal Province. Her duties included defending opponents of apartheid, in a context where political activists, resistance organisations and their supporters were exposed to repression. She was committed to both women’s rights to male-dominated legal professions and defending citizens’ rights against a racist and segregationist state.
South Africa’s transition to democracy, which began in the early 1990s and culminated in the multi-racial elections of 1994, opened up a new chapter. In 1995, Pillay was the first woman of colour to sit on the South African High Court. And in May 1995, she became a judge at the International Criminal Tribunal for Rwanda (ICTR), created by the UN Security Council in November 1994, after the genocide against the Tutsi that killed about 800,000 people. Through the legal proceedings that she initiated, she contributed to making rape recognised as a war crime that is a potential weapon of mass destruction.
Pillay then chaired the ICTR from 1999 to 2003. She joined the International Criminal Court (ICC) in The Hague in 2003, before being appointed UN High Commissioner for Human Rights in 2008. She held this position until 2014. In this role, she defended the universality of human rights, including cases when protecting these rights involved challenging powerful governments.
Such a career path adds particular coherence to the 2026 edition of the honour: from the struggle against apartheid to international courts, with this distinction, justice appears as a condition for lasting peace, in accordance with the principles of the UN.
The Nobel Prize in Paix: an independent procedure, not a popularity contest
Awarded since 1901, the Nobel Peace Prize sets out to follow a particular logic. In his will of 1895, Alfred Nobel entrusted the appointment of the laureate to a committee of five people chosen by the Norwegian Parliament, the Storting. This Norwegian Nobel Committee sits apart from the Swedish institutions who are in charge of the other Nobel prizes.
The selection process takes several months. Applications must be submitted by January 31st. Only certain categories of people are entitled to put forward nominees: parliamentarians and ministers, heads of state, academics who meet the criteria, former laureates or committee members, in particular. Self-nomination is not permitted. In 2026, the committee registered 287 candidates: 208 people and 79 organisations. The recent and commendable trend is indeed to award the prize to organisations rather than a single person, in order to value collective commitment. For instance, the prize was recently awarded in 2017 to the International Campaign to Abolish Nuclear Weapons, in 2020 to the World Food Program (WFP) and in 2022 to two NGOs (one Ukrainian and one Russian), as well as the imprisoned head of a third Belarusian NGO.
After verification of their validity, the proposals are reviewed by the five committee members, who draw up a shortlist. Norwegian and international experts may be called upon to provide background information. Deliberations then continue until a final decision is reached, usually between late summer and early autumn. Consensus is sought, but a simple majority is sufficient. The names of candidates and documents relating to the proceedings remain confidential for 50 years.
Pillay and the report on the genocide in Gaza: a commitment with immediate geopolitical implications
The history of the Nobel Peace Prize shows that its choices are not exempt from controversy. When Henry Kissinger was awarded the prize in 1973, it provoked strong criticism. There were also polemics surrounding the choices of Barack Obama in 2009, the European Union in 2012, Ethiopian Prime Minister Abyi Ahmed in 2019 or Venezuelan Corina Machado last year, a far-right and ultraliberal opponent (who dedicated her prize to Donald Trump – a non-exhaustive list.
The appointment of Navi Pillay, too, will certainly make the most reactionaries cringe. Donald Trump, a long-standing enemy of the institutions of international justice, had made obtaining the Nobel Peace Prize a clear political goal, boasting again on October 7 2026, that he had “put an end to eight wars”. But by increasing the number of fundamental rights violations in the United States, while internationally defending a unilateral power policy that runs counter to international law, whether in relation to Venezuela or Iran, reason tells us that he could not claim the Nobel Peace Prize.
The awarding of this year’s prize has already triggered a strong reaction from Binyamin Netanyahu’s government.
From 2021 to November 2025, Navi Pillay admittedly chaired the United Nations Independent International Commission of Inquiry on the Occupied Palestinian Territory, which published a report in September 2025 (immediately rejected by Tel-Aviv, but also by Washington) concluding that genocide had been committed in Gaza, and holding some senior Israeli officials responsible.
In any case, the Nobel Prize awarded to the woman who was, for four years, president of this commission (now headed by the Indian jurist Srinivasan Muralidhar) gives additional visibility to the fact-finding work and the protection of civilians in Gaza. It aims to recall that international humanitarian law and the 1948 Convention on the Prevention and Punishment of the Crime of Genocide cannot be applied to variable geometry depending on the identity of the alleged perpetrators or their strategic alliances.
A signal to the great powers and multilateral institutions
The choice of Navi Pillay is part of a wider crisis in the international order. Her journey reminds us that international legal institutions, particularly those of the UN, are spaces where victims’ rights are recognised, facts are recorded and leaders may face obligations that go beyond their immediate interests.
It should also be noted that this award, the fourth for South Africa after Albert John Luthuli (1960), Desmond Tutu (1984) and the “duo” Nelson Mandela/Frederik De Klerk (1993), is the 21st prize awarded to a woman, out of 113 winners, which is less than one fifth.
By awarding this distinction to a jurist who devoted her life to the fight against apartheid, the prosecution of international crimes and defending of human rights, in a world where leaders, often authoritarian and unilateralist, willingly claim credit for agreements reached by force, the Nobel Committee recalls that peace is also measured by the collective ability of societies to enforce common and democratic rules, in accordance with international law – even though this concept and its interpretations remain sometimes controversial, as shown by some of the initial reactions to the announcement of the winner’s identity…
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Chloé Maurel ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
13.10.2026 à 14:12
Les secondes intercalaires synchronisent nos horloges avec la rotation de la Terre depuis des décennies, mais elles pourraient disparaître
Vahe Peroomian, Professor of Physics and Astronomy, USC Dornsife College of Letters, Arts and Sciences
Texte intégral (2792 mots)
L’ESSENTIEL
Nos horloges atomiques sont plus régulières que la rotation de la Terre : depuis 1972, il a fallu leur ajouter 27 secondes pour suivre l’irrégularité de la rotation terrestre.
Ces secondes supplémentaires peuvent provoquer des bugs ou des pannes informatiques.
Le projet de réforme à l’étude ce mois-ci autoriserait un décalage d’une heure entre nos horloges et la rotation terrestre. S'il faudrait plusieurs siècles pour atteindre cet écart, certains utilisateurs devraient suivre la dérive entre le temps astronomique et le temps des horloges plus précisément.
Tous les quatre ans, février gagne un jour à la faveur d’une année bissextile. La raison est astronomique : la Terre met environ 365 jours un quart à faire le tour du Soleil. Ajouter un 29 février tous les quatre ans compense le décalage. Sans cet ajustement, les équinoxes et les solstices glisseraient de plus en plus tard dans le calendrier, entraînant avec eux le jour marquant le début de chaque saisons.
Car pendant des millénaires, le jour a été défini comme la durée d’une rotation complète de la Terre sur elle-même. Mais cette rotation n’est pas toujours parfaitement régulière. Pour gagner en précision, les systèmes modernes de mesure du temps ont cessé de s’appuyer sur elle.
Ce changement a créé un décalage entre l’ancienne définition de la seconde et celle utilisée aujourd’hui. En effet, au fil des années, les systèmes modernes de mesure du temps peuvent se décaler de quelques secondes par rapport au mouvement de la Terre. Pour corriger cet écart, les spécialistes de la mesure du temps ont recours à ce qu’on appelle une « seconde intercalaire ». De la même manière que les années bissextiles maintiennent nos calendriers en phase avec la révolution de la Terre autour du Soleil, les secondes intercalaires maintiennent nos horloges en phase avec sa rotation quotidienne.
Mais en octobre 2026, l’organisation internationale chargée de la mesure du temps pourrait revoir les règles d’ajout des secondes intercalaires.
En tant que chercheur en sciences spatiales, je sais à quel point la mesure du temps est fondamentale pour la recherche en physique. La précision de nos mesures s'est améliorée avec nos manière de mesurer le temps.
Histoire de la seconde
En effet, les systèmes utilisés pour mesurer le temps ont évolué au cours des derniers siècles. La journée de 24 heures trouve son origine au deuxième millénaire avant notre ère, lorsque les Égyptiens de l’Antiquité ont divisé le jour et la nuit en 12 parties chacun. Comme la durée du jour et de la nuit varie au fil de l’année, celle de chaque heure diurne et nocturne variait elle aussi.

L’astronome grec Hipparque, qui vivait au IIe siècle avant notre ère, a ensuite adopté un système de 24 heures de durée égale pour ses calculs astronomiques.
La division d’une heure en 60 minutes de 60 secondes chacune trouve elle aussi ses racines dans l’astronomie. Ce découpage, fondé sur un système en base 60, remonte aux civilisations sumérienne et babylonienne de Mésopotamie. Le nombre 60 est particulièrement commode, car il possède de nombreux diviseurs, ce qui facilite le découpage du temps.
Vers l’an 150 de notre ère, l’astronome grec Claude Ptolémée a adopté le système en base 60 pour mesurer le mouvement des planètes. Il a divisé chaque degré d’angle en 60 parties, puis chacune d’elles en 60 parties plus petites. Ces subdivisions ont ensuite été appelées en latin partes minutae primae, soit « premières petites parties », et partes minutae secundae, « secondes petites parties ». C’est de ces expressions que viennent les mots « minute » et « seconde ».
Des siècles plus tard, à mesure que les horloges mécaniques gagnaient en précision, ces subdivisions astronomiques ont aussi été adoptées pour mesurer le temps. À partir des systèmes conçus par Ptolémée et ses successeurs, le jour solaire moyen a été divisé en 24 heures de 60 minutes, comptant chacune 60 secondes, soit 86 400 secondes.
Mais il a fallu attendre que Christiaan Huygens invente son horloge, le pendule de Huygens, en 1657 pour pouvoir réellement mesurer le temps à la seconde près. Dans une telle horloge, une masse suspendue oscille à un rythme régulier. À condition de tenir compte des variations de la gravité terrestre, tous les pendules de même longueur mettent le même temps à effectuer une oscillation. Cette régularité a fourni une référence commune pour mesurer le temps.
Le jour et la seconde intercalaires
Dans le prolongement du pendule de Huygens, les scientifiques ont consacré trois siècles supplémentaires à mettre au point des systèmes de mesure du temps précis et normalisés, afin que toutes les horloges du monde puissent indiquer la même heure. Au cours de ces recherches, la définition de la seconde a changé à plusieurs reprises. Ils ont finalement trouvé une solution dans l’atome de césium.
En 1967, la Conférence générale des poids et mesures – une organisation intergouvernementale qui fixe les normes de mesure et rassemble aujourd’hui plus de 100 pays – a adopté une nouvelle définition fondée sur l’atome de césium 133.
Les atomes de césium 133 se comportent comme des horloges d’une précision exceptionnelle. Lorsque l’atome passe d’un état d’énergie particulier à un autre, il émet un rayonnement qui oscille, comme un pendule, à un rythme remarquablement stable. Les scientifiques ont défini la seconde comme la durée exacte de 9 192 631 770 de ces oscillations.
Le temps universel coordonné, ou UTC, repose sur des horloges atomiques utilisant le césium 133. L’UT1, l’échelle de temps fondée sur la rotation terrestre, peut donc se décaler par rapport à l’UTC.
Cet écart reflète à la fois les irrégularités à court terme de la vitesse de rotation de la Terre et son ralentissement très progressif à long terme, principalement causé par l’attraction gravitationnelle de la Lune sur les océans terrestres.
L’écart entre une journée de 86 400 secondes atomiques et une journée mesurée à partir de la rotation terrestre est inférieur à 4 millisecondes. Ce décalage peut sembler minime, mais, en s’accumulant sur une année, il peut représenter une fraction non négligeable de seconde.
C'ets pourquoi, depuis 1972, les spécialistes de la mesure du temps ont ajouté 27 secondes intercalaires à l’UTC, à des intervalles très irréguliers. L’objectif était de maintenir l’écart entre l’UTC et l’UT1 en dessous de 0,9 seconde. La dernière seconde intercalaire a été ajoutée fin 2016.
La fin de la seconde intercalaire
Ajouter de temps à autre une seconde aux horloges peut perturber les systèmes informatiques qui exigent une grande précision. De nombreux systèmes d’exploitation partent du principe qu’une journée dure 86 400 secondes et que le temps s’écoule de manière prévisible, sans jamais revenir en arrière. L’ajout d’une seconde intercalaire remet en cause ces deux principes. À la date prévue, les horloges sont décalées d’une seconde et la journée dure alors 86 401 secondes.
En 2012, par exemple, Reddit a subi une panne après l’ajout d’une seconde intercalaire le 30 juin. D’autres systèmes, dont le noyau Linux et certaines applications développées en Java, ont également été touchés.
Pour éviter ce type d’incident, de grandes entreprises technologiques, dont Google et Meta, pratiquent le « lissage » : elles répartissent progressivement la seconde supplémentaire sur une longue période, au lieu de l’ajouter d’un seul coup. Cette opération est complexe, et ces entreprises plaident avec insistance pour la suppression de la seconde intercalaire.
En 2022, la Conférence générale des poids et mesures a décidé d’augmenter, au plus tard en 2035, l’écart maximal autorisé entre l’UTC et l’UT1. Elle prévoyait de fixer cette nouvelle limite lors de sa réunion de 2026.
Un phénomène les pousse à accélérer leur décision : la Terre connaît une période de rotation inhabituellement rapide depuis environ 2015. En 2020, les spécialistes de la mesure du temps ont recensé 28 jours durant lesquels la Terre a effectué une rotation complète en moins de 86 400 secondes atomiques. La journée la plus courte mesurée depuis l’avènement des horloges atomiques a été enregistrée le 29 juin 2022 : la Terre a alors bouclé sa rotation avec 1,59 milliseconde d’avance sur cette durée de référence.
Si la Terre continue de tourner à ce rythme accéléré, il faudra peut-être, pour la première fois, retrancher une seconde au lieu d’en ajouter une : ce serait une seconde intercalaire négative. Une telle opération n’a jamais été réalisée à grande échelle sur les systèmes informatiques, et l’on ignore comment ils réagiraient. C’est ce qui rend la question plus urgente.
La Conférence générale des poids et mesures se réunira du 13 au 15 octobre 2026. Elle examinera un projet de résolution qui ferait de l’UTC une échelle de temps continue, sans ajout brusque de secondes intercalaires, à compter du 20 mai 2027.
Ce texte autoriserait l’écart entre l’UTC et l’UT1 à atteindre 3 600 secondes, soit une heure. Cela reviendrait à remplacer la seconde intercalaire par une « heure intercalaire ». La résolution ne fixe toutefois aucun calendrier pour procéder à des corrections ponctuelles d’une heure. Une telle correction ne serait pas nécessaire avant plusieurs siècles.
Ce changement sera-t-il perceptible ?
Les horloges de vos smartphones, ordinateurs portables et autres appareils électroniques affichent rarement les secondes, voire jamais. L’ajout de secondes intercalaires est donc généralement passé inaperçu, sauf pour les métrologues chargés des différents systèmes de mesure du temps.
À mesure que l’écart autorisé entre l’UTC et l’UT1 se creusera, les astronomes, les spécialistes des sciences de la Terre et les autres utilisateurs de données sur l’orientation terrestre devront tenir compte de ce décalage croissant pour faire correspondre leurs observations et leurs mesures à l’heure civile.
Pour se repérer à partir de la position du Soleil, de la Lune et des étoiles, il faut connaître l’heure précise des observations. Ceux qui pratiquent cette navigation astronomique devront tenir compte de l’écart croissant entre l’UTC et l’UT1 pour déterminer leur position exacte sur Terre.
De même, lorsqu’on s’oriente avec une boussole, il faut tenir compte du décalage entre les pôles magnétiques et géographiques de la Terre. Pour cela, on utilise la déclinaison magnétique du lieu où l’on se trouve, c’est-à-dire l’angle entre la direction indiquée par la boussole et le nord géographique. Les logiciels des smartphones peuvent effectuer cette correction automatiquement.
Une méthode similaire existe déjà pour passer de l’UTC à l’UT1 et aux autres échelles de temps utilisées aujourd’hui. Si le projet de résolution est adopté en octobre, le suivi des écarts entre ces échelles, en particulier le décalage progressif entre l’UTC et l’UT1, prendra une place plus importante dans la mesure du temps de haute précision.
D’ici la mi-octobre, la seconde intercalaire pourrait appartenir au passé. Mais, compte tenu de l’importance que nous accordons au rythme des saisons, les années bissextiles, elles, ont encore de beaux jours devant elles.

Vahe Peroomian a reçu des financements de la National Science Foundation (NSF) et de la National Aeronautics and Space Administration (NASA) pour ses travaux sur la météorologie spatiale et les tempêtes géomagnétiques.
13.10.2026 à 12:01
La ménopause est une transition physiologique, elle devient aussi un marché lucratif
Jennifer Takhar, Associate Professor of Consumer Culture, SKEMA Business School
Anna Schneider-Kamp, Associate Professor, SDU Business School, University of Southern Denmark
Texte intégral (2268 mots)
L’ESSENTIEL
La médiatisation croissante de la ménopause aide à lever les tabous et à favoriser l’accompagnement des femmes concernées.
Compléments alimentaires, livres, coachings… la ménopause devient aussi un marché lucratif porté par des acteurs qui influencent le regard sur cette transition.
Les réseaux sociaux, au sein desquels des femmes partagent expériences et conseils, amplifient ce phénomène.
Longtemps reléguée à la sphère privée, la ménopause fait aujourd’hui l’objet d’une visibilité médiatique et commerciale inédite avec une valeur de marché de 535 milliards d’euros (600 milliards de dollars US).
Livres, podcasts, documentaires, applications numériques, compléments alimentaires et programmes de coaching se multiplient pour accompagner les femmes dans cette étape de la vie. Ce qui était autrefois un sujet tabou est ainsi devenu un secteur économique en pleine expansion.
Cette évolution constitue une avancée importante : la ménopause est davantage discutée, mieux comprise et progressivement reconnue comme un enjeu de santé publique. Mais cette visibilité s’accompagne aussi d’une forte commercialisation. À mesure que le sujet entre dans l’espace public, il devient également une opportunité de marché.
Cette transformation soulève une question au centre de l’analyse de notre ouvrage All Change! Marketing and Consuming the Menopause Transition (en français, Tout change ! Le marketing et la perception de la transition vers la ménopause) : répond-elle réellement aux besoins des femmes ou contribue-t-elle à créer un nouveau marché fondé sur leurs inquiétudes, leurs symptômes et leur désir de mieux-être ?
Une commercialisation qui influence le regard sur la ménopause
Dans cet ouvrage, est conceptualisée l’émergence de la ménopause comme un marché de consommation à part entière. Ce dernier est caractérisé par une « prise de conscience du marché climatérique » croissante et par la transformation progressive de la ménopause en espace d’opportunités commerciales, d’interventions sur le corps et d’optimisation de soi. (La philosophe Gloria Origgi explique que « climatere » viendrait du mot grec « klimax » qui signifie degré ou échelle. Ce terme indiquait, au moins du temps de Pythagore, un des « âges critiques de la vie » marqués par une vulnérabilité, ndlr).
Prolongeant cette perspective, une étude montre que les « marchés de la ménopause » (menomarkets) ne se contentent pas de répondre à des besoins préexistants : ils contribuent activement à façonner la manière dont la ménopause est comprise, vécue et prise en charge, en influençant notamment ce qui est défini comme un problème ménopausique et les formes de savoir, de soins et de consommation considérées comme appropriées.
Ensemble, ces perspectives invitent à concevoir la marchandisation, non pas uniquement comme l’expansion commerciale des produits et des services liés à la ménopause, mais comme un processus par lequel les marchés participent à la production des significations, des besoins et des subjectivités associés à la ménopause.
Un nouveau marché en pleine expansion
L’intérêt économique pour la ménopause s’explique en partie par des évolutions démographiques. Les femmes vivent plus longtemps et passent désormais plusieurs décennies en période post-ménopausique. Selon certaines estimations, plus d’un milliard de femmes seront ménopausées dans le monde d’ici à 2030.
Face à cette réalité, les entreprises ont identifié un segment de consommatrices longtemps négligé. L’industrie de la ménopause comprend aujourd’hui des compléments alimentaires, cosmétiques, vêtements contre l’inconfort des bouffées de chaleur, applications de suivi ou encore retraites de bien-être, sachant que bon nombre de ces produits ou soi-disant « solutions » n’ont pas démontré leur efficacité.
Attention à ne pas faire d’amalgame avec le traitement hormonal de la ménopause. Celui-ci est délivré sur prescription médicale, sous la responsabilité du ou de la gynécologue. Longtemps controversé, il est strictement encadré.
Cette croissance transforme la représentation de la ménopause. Elle n’apparaît plus seulement comme une phase du vieillissement, mais comme une période nécessitant des solutions, des accompagnements et des produits spécifiques. Les marques la présentent comme un défi à gérer grâce à des choix de consommation adaptés.
À lire aussi : « Vous souffrez de bouffées de chaleur ? » La ménopause, ce tabou qui creuse les inégalités au travail
La naissance de la « consommatrice responsable »
Au cœur de cette évolution, apparaît la figure de la « consommatrice responsable ». Les femmes sont encouragées à devenir actrices de leur santé en recherchant des informations, en surveillant leurs symptômes et en choisissant les produits censés améliorer leur qualité de vie.
Cette approche s’inscrit dans une tendance plus large : la responsabilisation individuelle en matière de santé. Chacune et chacun est invité à prendre en charge son bien-être par des comportements appropriés et des choix éclairés. Dans le cas de la ménopause, cette logique fait des femmes les gestionnaires de leur transition hormonale. Elles sont incitées à s’informer, à modifier leurs habitudes alimentaires, à pratiquer davantage d’activité physique ou à investir dans des solutions présentées comme innovantes.
Cette responsabilisation peut favoriser l’autonomie et une meilleure compréhension du corps. Toutefois, elle comporte aussi des risques : en insistant sur les choix individuels, elle tend à déplacer l’attention des responsabilités collectives vers les responsabilités personnelles.
Le rôle des médias et des réseaux sociaux
La visibilité actuelle de la ménopause doit beaucoup aux médias et aux réseaux sociaux. Des personnalités publiques, des journalistes et des professionnelles de santé ont contribué à sortir le sujet de l’ombre.
Au Royaume-Uni, les documentaires réalisés par Kate Muir avec Davina McCall ont joué un rôle important. En donnant la parole à des femmes confrontées à des symptômes parfois invalidants, ils ont sensibilisé un large public à une réalité longtemps ignorée. En France, on citera notamment une tribune signée par plusieurs personnalités du monde politique et de la culture en 2024. Un rapport parlementaire a même été remis au gouvernement en 2025.
Les réseaux sociaux ont amplifié ce mouvement. Des milliers de femmes y partagent leurs expériences, échangent des conseils et recommandent des solutions, contribuant ainsi à réduire le sentiment d’isolement associé à la ménopause.
Des espaces de paroles ou des communautés se développent autour de la ménopause sur les réseaux sociaux. Ils sont portés par des hashtags comme #Midlifewomen (« Femmes au milieu de leur vie »), #PerimenopauseProblems (« Les problèmes à la périménopause »), #Breakthemenopausetaboo (« Briser le tabou autour de la ménopause »), #MyHormonesAreDrunk (« Mes hormones sont sens dessus dessous ») etc.
Ces espaces sont toutefois devenus des lieux privilégiés pour les stratégies marketing. Influenceuses, coachs et entreprises y promeuvent leurs produits auprès d’un public réceptif. La frontière entre information, témoignage et publicité devient alors parfois difficile à distinguer.
Un besoin d’accompagnement qui alimente le commerce
La sensibilisation à la ménopause répond à un réel besoin d’information. Pourtant, elle a aussi créé les conditions favorables à une expansion commerciale rapide.
De nombreuses entreprises proposent désormais des produits destinés aux femmes ménopausées. Certains répondent à des besoins réels et reposent sur des bases scientifiques solides ; d’autres s’appuient surtout sur des promesses de bien-être ou des arguments marketing difficiles à vérifier.
Cette situation conduit à la notion de « complexe industriel de la ménopause », c’est-à-dire d’un ensemble d’acteurs économiques cherchant à tirer profit de ce marché en croissance. Le problème n’est pas l’existence de solutions commerciales : certaines innovations peuvent améliorer la qualité de vie des femmes. La question centrale est celle de la validité scientifique des promesses formulées.
Lorsque des produits sont présentés comme capables de soulager des symptômes sans preuves suffisantes, le risque de désinformation augmente. La croissance du marché des compléments alimentaires illustre la marchandisation croissante de la ménopause. Alors même que les preuves d’efficacité restent limitées, une étude a pu identifier pas moins de 201 produits sur le marché britannique en 2026, avec des formulations et des prix extrêmement variables.
Des consommatrices vulnérables exploitées par le marketing
Les femmes concernées peuvent être particulièrement vulnérables. Troubles du sommeil, anxiété, changements hormonaux ou difficultés professionnelles les conduisent parfois à rechercher activement des solutions.
À lire aussi : Au-delà des bouffées de chaleur, les femmes doivent s’inquiéter des effets de la ménopause sur leur cœur
Cette vulnérabilité peut être exploitée par certaines stratégies marketing. Face à des symptômes difficiles, une promesse de soulagement rapide ou naturel peut paraître particulièrement attractive. Toutes les femmes ne disposent pas par ailleurs des mêmes possibilités d’évaluation des propositions qui leur sont faites. Les connaissances médicales, l’accès aux soins et les moyens financiers varient fortement selon les individus.
Les inégalités sociales jouent donc un rôle majeur. Les femmes disposant de revenus élevés ont davantage accès aux consultations spécialisées ou aux produits coûteux, tandis que celles qui disposent de ressources moindres rencontrent plus d’obstacles pour obtenir une prise en charge adaptée.
Pourquoi la régulation est nécessaire
Il convient de mettre l’accent sur une marchandisation absurde. Au Royaume-Uni, par exemple, des publicités vont jusqu’à vanter des chocolats qui soulageraient les symptômes de la ménopause, entre autres.
Face à l’expansion du marché de la ménopause, la régulation devient essentielle. Les consommatrices doivent pouvoir distinguer les informations fondées sur des preuves scientifiques des simples arguments commerciaux.
Les autorités sanitaires ont un rôle important à jouer dans le contrôle des allégations formulées par les entreprises. Les professionnels de santé ont également une responsabilité majeure pour aider les femmes à prendre des décisions éclairées sans dépendre uniquement des discours commerciaux.
Au-delà du marché
L’enjeu est donc de trouver un équilibre entre innovation, information et protection des consommatrices. La ménopause mérite d’être abordée comme une question de santé, d’égalité et de justice sociale, et non simplement comme un marché à conquérir.
En définitive, la fin du silence autour de la ménopause représente un progrès majeur. Il reste toutefois à veiller à ce que cette visibilité bénéficie avant tout aux femmes elles-mêmes, plutôt qu’aux seuls intérêts commerciaux.

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
12.10.2026 à 16:01
« Marie-Antoinette » : vingt ans après sa sortie, le film subversif de Sofia Coppola célébré à Versailles
Fiona Handyside, Associate Professor of Film Studies, University of Exeter
Texte intégral (1655 mots)
L’ESSENTIEL
Le château de Versailles célèbre les vingt ans du film Marie-Antoinette, de Sofia Coppola, à travers une exposition présentée au Petit Trianon, conçue en collaboration avec la réalisatrice.
L’exposition explore la genèse de l’œuvre, ses choix esthétiques et son impact culturel.
Il s’agit d’une reconnaissance importante pour un film qui avait été hué à Cannes, en mai 2006, tandis qu’il était projeté pour l’ouverture du festival.
Jusqu’à fin janvier 2027, un événement unique se déroule au Petit Trianon, cette petite résidence d’été nichée au milieu des parterres de fleurs du vaste domaine du château de Versailles.
En parcourant ses salles, les visiteurs peuvent admirer des compositions florales d’un rose éclatant tout en écoutant la musique de New Order. Cet événement a été conçu en hommage au film de Sofia Coppola sorti en 2006, Marie-Antoinette.
Le film, tourné à Versailles, fait l’objet d’une extraordinaire fête pour son 20ᵉ anniversaire. Des scènes et des décors ont été recréés dans les salles mêmes où la reine adolescente (incarnée dans le film par Kirsten Dunst) échappait autrefois aux hiérarchies rigides de la vie de cour.
Dans ce mélange de réalité et de fiction, les visiteurs peuvent découvrir le véritable service de table en porcelaine de Sèvres de Marie-Antoinette. À ses côtés sont exposés les accessoires culinaires sophistiqués créés pour le film de Coppola par la directrice artistique Anne Seibel et le chef étoilé Marc Meneau. Des portraits de Marie-Antoinette par Élisabeth Vigée Le Brun sont accrochés aux côtés de mannequins dont la tenue rappelle celles de Kirsten Dunst dans le film.
Plus de 200 films ont été tournés sur place, dans les bâtiments et les jardins de Versailles et aux alentours, mais il s’agit ici de la première exposition consacrée à un seul et même film.
Coppola a collaboré avec les commissaires d’exposition Laurent Salomé et Hélène Delalex pour la conception artistique de l’exposition. Le résultat est une expérience extraordinaire et étrange : le Petit Trianon vu à travers la double sensibilité de la cinéaste et de la reine.
Ici, les visiteurs voient comment ces deux femmes ont construit des univers clos destinés à nourrir leur identité et à préserver leurs plaisirs de jeunes filles. Dans le même temps, toutes deux comptaient – peut-être trop – sur leurs privilèges et leur image pour se maintenir à flot.
En avance sur son temps
Le film de Sofia Coppola a été hué lors de la projection d’ouverture au Festival de Cannes en mai 2006. Ce fut un échec commercial, le film ayant à peine couvert son budget de 40 millions de dollars (21,7 millions de livres sterling). Coppola n’a pas réalisé d’autre film pendant quatre ans.
Il est donc d’autant plus gratifiant pour les fans du film de le voir gagner en stature et en reconnaissance. À l’occasion de son 20ᵉ anniversaire, Marie-Antoinette bénéficie d’un regain d’intérêt et, enfin, du prestige culturel que, selon moi, son audace mérite.
L’entreprise de distribution de films Criterion a sorti une restauration numérique en 4K dans sa prestigieuse collection, accompagnée de commentaires audio, de scènes coupées et d’un essai de Claire Healy, spécialiste de l’enfance des filles. Réalisé par la mère de Sofia, Eleanor Coppola, The Making of Marie-Antoinette sortira en novembre.
Pourquoi, deux décennies après sa sortie, le film de Sofia Coppola reçoit-il enfin la reconnaissance du public et de la critique qu’il mérite – célébrant ainsi son choix audacieux de raconter l’histoire d’une reine du XVIIIᵉ siècle à travers le prisme du pop art ?
Cela s’explique en partie par le fait que la cinéaste a anticipé un genre de fantaisie historique devenu courant aujourd’hui : la Régence délibérément kitsch de la série les Chroniques de Bridgerton (2020), le langage grossier et ironique de la cour russe dans la série The Great (2020), et l’univers du XVIIIᵉ siècle joyeusement révisionniste du film la Favorite (2018).
Mais cette reconnaissance n’est pas seulement liée au fait que le postmodernisme ludique de Coppola soit devenu plus accessible culturellement. La cinéaste annonce ses intentions avec une clarté extraordinaire dès le tout début du film.
Un postmodernisme ludique
Le film s’ouvre sur un écran noir, le texte du générique apparaissant en rose vif. La chanson Natural’s Not in It de Gang of Four retentit (« I do love a new purchase/a market of the senses ») tandis que la première scène est lancée.
Dunst, vêtue d’un corset en soie blanche et de jupons, les cheveux ornés de plumes blanches, est allongée sur une chaise longue gris tourterelle. Une femme de chambre place un soulier sur son pied tendu, tandis qu’elle prélève nonchalamment une cuillerée de glaçage rose épais sur un gâteau posé à côté d’elle.
Alors qu’elle porte son doigt à sa bouche, elle se tourne et lance un regard à la caméra. Elle nous salue. C’est une femme consciente d’être observée : par la cour, par la caméra, par les spectateurs.
La célèbre galerie des Glaces préfigure l’univers des réseaux sociaux, où les représentations passent d’un écran à l’autre dans des boucles de références sans fin. Les paroles du groupe punk Gang of Four associent l’acquisition d’objets au plaisir sensuel et à la construction d’un mode de vie désirable – faisant de la Marie-Antoinette de Dunst une influenceuse avant la lettre.
Pourtant, le film garde une pointe de mélancolie. À l’ère des contraintes financières post-austérité, du dérèglement climatique et des événements géopolitiques imprévisibles, sa représentation d’un monde vacillant au bord de la crise – tout en se consacrant à la mise en scène de modes de vie toujours plus raffinés – trouve un écho troublant.
En regardant le film de Coppola projeté sur les murs de pierre du Petit Trianon, dans les pièces mêmes où Marie-Antoinette a vécu, les visiteurs se rappellent aussi la fin sanglante qui attendait la charmante jeune femme que l’on voit danser devant eux.
C’est un film qui place le regard d’une jeune fille au cœur d’un moment convulsif de l’histoire mondiale. Et Coppola insiste sur le fait que ses expériences et ses sentiments comptent.
Ce film est un manifeste en faveur de la spécificité de l’enfance féminine : il affirme avec force que grandir en tant que fille est une expérience à part entière, façonnée par les attentes imposées aux corps et aux identités.
Si même les jeunes filles les plus privilégiées ressentent le poids de l’oppression et des attentes dans un monde régi par les images, qu’est-ce que cela signifie pour celles qui ne bénéficient pas du même niveau de confort matériel ?
Le film de Sofia Coppola est sorti à une époque culturelle dominée par un consumérisme présenté comme une forme d’émancipation, où le « girl power » servait à vendre de la musique et de la mode aux jeunes femmes. Le contre-message du film – selon lequel ce pouvoir est strictement limité, affaibli d’un côté par un establishment patriarcal hypertrophié et de l’autre par la pauvreté scandaleuse qui se cache derrière les plaisirs de Marie-Antoinette, dont elle n’avait guère conscience – semblait anachronique et hors de propos à l’époque.
Aujourd’hui, à l’ère post-#MeToo, alors que Donald Trump entame son deuxième mandat présidentiel et que la montée du populisme de droite met en évidence des injustices sociales profondément enracinées et des inégalités de revenus, le film de Coppola semble bien trop prémonitoire.

Fiona Handyside ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
12.10.2026 à 16:01
« Ça vient direct du marché de producteurs » : Quand le greenwashing personnel conduit à agir concrètement
Nadège Ianni, Doctorante en marketing durable, Aix-Marseille Université (AMU)
Texte intégral (1708 mots)
L’ESSENTIEL
Si les Français s’inquiètent pour l’environnement, ils sont peu nombreux à faire des actions concrètes. C’est ce qu’on appelle le green gap.
La théorie du comportement planifié aide à en comprendre les mécanismes. Elle met aussi en avant un levier pour le réduire.
Si les comportements ostentatoires recherchent une récompense sociale, ils peuvent aussi être à l’origine d’un engagement écologique.
Poster sa skincare 100 % DIY sur Instagram, exhiber son sac en tissu au marché ou parader avec une pièce de seconde main… Ces pratiques sont souvent perçues comme du greenwashing personnel. Et si, à l’inverse, exposer ses choix responsables favorisait l’engagement écologique ?
Huit Français sur dix jugent que la crise climatique les oblige à revoir leurs habitudes de consommation, selon l’Agence de la transition écologique (Ademe). Mais seulement 13 % d’entre eux font tout leur possible pour y parvenir.
Ce paradoxe s’appelle le green gap : on aimerait avoir des comportements responsables mais il reste difficile de passer à l’acte. Les recherches en marketing durable ont identifié les causes du « green gap » et tentent désormais de trouver des leviers pour le réduire. Nos travaux, qui s’appuient des entretiens individuels avec des consommateurs responsables et anti-consommateurs, s’inscrivent dans cette démarche.
Pourquoi la bonne volonté ne suffit pas
Vouloir consommer de façon responsable ne suffit pas. La théorie du comportement planifié explique pourquoi une bonne volonté ne se transforme pas systématiquement en acte, comme l’illustre le green gap. En effet, le comportement responsable s’appuie sur trois piliers : l’attitude, la norme subjective (ou norme sociale) et le contrôle comportemental perçu. Passons en revue ces différentes conditions.
À lire aussi : Pourquoi la mise en œuvre de la durabilité échoue souvent, même quand tout le monde est d’accord
Tout d’abord, l’attitude doit être favorable à la responsabilité, c’est-à-dire que l’acte responsable doit avoir du sens. Ensuite, la norme sociale doit accompagner ce changement : un entourage qui valorise la responsabilité encourage à faire pareil. Enfin, il y a le contrôle comportemental perçu, qui correspond au jugement de ses propres capacités à pouvoir réaliser un acte responsable. L’expérience renforce le contrôle comportemental perçu : une fois que l’on a déjà accompli un acte responsable, on se sent capable de recommencer plus facilement.
Ces phénomènes qui creusent le « green gap »
Ces moteurs du comportement responsable peuvent rencontrer des obstacles. Par exemple, une communication maladroite peut obtenir l’effet inverse de celui escompté sur l’attitude des individus. Ils peuvent ainsi rejeter le comportement responsable quand le message est perçu comme culpabilisant ou manipulateur. De la même manière, la norme sociale ne doit pas être ressentie comme une pression.
À lire aussi : Percevoir les conséquences immédiates du changement climatique suffit-il pour changer les comportements ?
Un autre frein apparaît : le contrôle comportemental perçu s’effondre dès que l’acte demande un changement d’habitude ou un effort. Pas facile de faire les courses en vélo quand on a toujours pris la voiture ! Or la consommation responsable demande parfois de renoncer au confort, ou de dépasser ses freins financiers.
Enfin, la désirabilité sociale brouille les pistes. On peut se déclarer plus responsable qu’en réalité pour montrer une bonne image de soi. Ce biais creuse le green gap car l’intention est artificiellement exagérée sans changer le comportement réel. Paradoxalement, un levier permet justement de transformer ce greenwashing personnel en passage à l’acte : le comportement ostentatoire responsable.
Le summum de la distinction sociale : ne rien acheter
Le comportement ostentatoire responsable consiste à rendre visible un acte qui diffuse un statut d’engagement social ou environnemental. L’ostentation responsable permet de montrer qu’on est quelqu’un de bien, parce qu’on a des valeurs écologiques et sociales. Au-delà d’un discours, c’est un comportement posé par des actes. Offrir des légumes de son producteur à ses invités, montrer ses techniques zéro déchet ou donner ses vêtements plutôt que de les jeter… Autant de pratiques publiques qui valorisent !
À lire aussi : Entre paillettes et éthique : l’influence responsable est-elle un mirage ?
En rendant les efforts visibles pour consommer mieux ou réduire sa consommation, on reçoit une récompense sociale statutaire. Nous avons interrogé plusieurs anti-consommateurs qui témoignent de cette valorisation. « Ils avaient été absolument fascinés parce qu’ils s’étaient rendu compte qu’en fait, avec tous les déchets de légumes, je faisais un bouillon à côté. On leur avait fait un risotto, et quand ils avaient découvert que le bouillon n’était pas sous forme d’un cube emballé dans de l’aluminium, ils avaient été hyperimpressionnés », développe Romain, 42 ans.
De la désirabilité à l’engagement écologique
À l’œuvre derrière le greenwashing personnel, le comportement ostentatoire parait intéressé. Mais il peut aboutir à une démarche plus sincère. La théorie de l’engagement l’explique : un acte public qui demande un effort crée une cohérence comportementale future. En effet, agir devant des témoins pousse à continuer dans la même voie pour garder une cohérence avec l’image que l’on vient de donner de soi.
Plus l’acte demande des efforts, plus on se l’approprie et plus il engage. Une intention silencieuse n’engage personne, alors qu’un effort visible engage et pousse à recommencer, jusqu’à ce que l’effort perçu s’efface. « Ça demande un effort supplémentaire de penser ses courses avant, ça demande de cuisiner plus. Mais après, une fois qu’on a fait le changement, on a du mal à revenir », nous a assuré Sylvie, 52 ans, qui cherche à moins dépendre de la grande distribution.
Ainsi, le basculement vers l’engagement suit une trajectoire en trois temps : je voudrais, je fais, je deviens. Tout d’abord, la désirabilité sociale donne envie de paraître responsable. Ensuite, cette volonté se transforme en premier acte ostentatoire visible et coûteux. Visible pour montrer aux autres que l’on est responsable. Coûteux parce qu’il demande un changement d’habitude. Enfin, l’acte se répète et s’étend : on commence par trier le verre puis on supprime petit à petit les emballages. L’engagement s’intensifie et transforme l’identité. On devient la personne responsable que l’on voulait être au départ.
Cet engagement peut amener à des décisions radicales, comme nous l’a confié Véronique, 38 ans : « J’ai fait un gros choix écologique, c’est de ne pas avoir d’enfant. »
Réduire le green gap grâce aux comportements ostentatoires
Les comportements ostentatoires responsables peuvent être mobilisés pour encourager l’engagement écologique et réduire le green gap. Pour ce faire, l’acte ostentatoire responsable doit être public, coûteux et valorisant. On oublie les campagnes de communication de masse, l’idée est de multiplier les contacts sur les lieux où la compétence responsable se montre : jardins partagés, associations locales ou ateliers de quartier.
Les plus engagés peuvent être sollicités comme modèles sans en faire trop. Ces derniers deviennent des références de compétence responsable. Le statut qu’ils gagnent doit rester inclusif et accessible à qui apprend. Ce rôle les valorise en retour, ce qui rend le mécanisme durable : plus leur compétence responsable est reconnue, plus ils ont intérêt à continuer.
La répétition des actes ostentatoires responsables agit sur les trois piliers du comportement planifié que nous avons présentés plus tôt. L’attitude se renforce par l’expérience positive vécue. La valorisation de la responsabilité renforce la norme subjective. Enfin, l’expérience favorise la capacité à recommencer et donc le contrôle comportemental perçu. Ces mécanismes réduisent donc le green gap, non pas en imposant le comportement responsable mais en le rendant visible, désirable et reproductible.
En clair : on passe à l’action quand le comportement responsable est visible par le groupe et valorisé socialement. Lorsque la désirabilité sociale ne joue aucun rôle, se montrer responsable n’engage pas. L’ostentation responsable n’est donc pas une solution universelle au green gap mais elle peut transformer un greenwashing personnel en engagement acté. La prochaine fois qu’on s’habillera d’une pièce de seconde main ou que l’on exhibe son sac en tissu, c’est peut-être le début d’un engagement écologique.

Nadège Ianni ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
12.10.2026 à 16:00
Quand la loi d’urgence agricole cherche à réserver la ressource en eau plutôt que d’adapter les besoins
Benoît Grimonprez, Droit rural et de l'environnement, Université de Poitiers
Texte intégral (2313 mots)
L’ESSENTIEL
La loi d’urgence pour la protection et la souveraineté agricoles (Upsa) érige l’accès à l’eau en condition existentielle de l’agriculture française.
Malgré cette nouvelle orientation, le nouveau texte ne remet pas fondamentalement en cause le principe de gestion équilibrée et durable de l’eau inscrit dans le Code de l’environnement.
Elle risque toutefois de faire tanguer la gouvernance de l’eau, en faisant évoluer le cadre d’action de plusieurs instances.
La loi d’urgence pour la protection et la souveraineté agricoles (Upsa) du 18 août 2026 érige l’accès à l’eau en condition existentielle de l’agriculture française. Pour en garantir la disponibilité, le texte encourage le stockage, assouplit les procédures et accorde davantage de poids aux intérêts agricoles dans les instruments de gestion de la ressource.
Faut-il y voir la consécration d’un droit des agriculteurs à l’eau qui supplanterait les autres usages ? Pas exactement. De manière plus subtile, la loi déplace les équilibres sur lesquels repose notre gouvernance de l’eau.
L’eau, nouveau pilier de la souveraineté agricole
L’agriculture traverse une crise de revenus et de compétitivité. L’excédent brut des exploitations agricoles a reculé de 25,7 % en 2023, puis à nouveau de 9,4 % en 2024, en euros constants.
Le changement climatique, particulièrement brutal en France durant l’été 2026, aggrave la situation. Répétées et plus intenses, les sécheresses menacent cultures, prairies et élevages, faisant plus que jamais de l’irrigation une assurance-vie agricole.
Or l’eau aussi est en crise, de façon qualitative et quantitative. Les milieux aquatiques et les captages d’eau potable se dégradent, tandis que la ressource s’amenuise de plus en plus aux beaux jours. Agriculture et eau se retrouvent prises dans une même spirale : garantir la production exige davantage d’eau, alors que la ressource souffre déjà des pressions anthropiques.
C’est dans ce contexte défavorable, pour ne pas dire apocalyptique, que la loi dite Upsa entend sanctuariser l’usage de l’eau pour l’agriculture. Son parti pris est clair : augmenter l’offre pour répondre à la demande. D’où les objectifs de doubler les volumes de stockage agricole d’ici 2035 et de multiplier fortement la réutilisation des eaux usées traitées.
Il faut toutefois, avec le Conseil constitutionnel, ramener ces ambitions à leur juste portée. Il s’agit de simples déclarations d’intention, sans force contraignante, qui ne permettent pas d’autoriser des projets qui méconnaîtraient les règles de protection des milieux aquatiques.
La loi affirme aussi l’absence de hiérarchie générale entre les usages économiques et environnementaux, qui doivent être conciliés. Aucune priorité donc à l’irrigation, le Code de l’environnement continuant de faire prévaloir santé, salubrité publique, sécurité civile et eau potable. En somme, espérer stocker davantage ne signifie pas prendre davantage, ni n’importe comment.
À lire aussi : Avec la loi d’urgence agricole, la France contrevient au droit international sur les zones humides
Le stockage, entre dogmatisme et pragmatisme
À la problématique climatique, la loi semble n’avoir trouvé qu’une réponse d’urgence, longue à mettre en place : le stockage. L’approche séduit par sa simplicité : garder l’eau quand elle abonde pour l’utiliser quand elle manque. La stratégie, si elle ne doit pas être exclue, n’est sûrement pas exclusive. Le tort majeur de la loi est de ne rien envisager d’autre.
Surtout que le débat s’est enfermé dans l’opposition entre les « pour » et les « contre » les « bassines », positions antagonistes qui masquent une réalité bien plus nuancée. Le stockage n’est ni bon, ni mauvais par nature, pas plus qu’il n’est interdit ou autorisé par principe. Les nombreux contentieux montrent que ce ne sont pas tant les réserves elles-mêmes qui sont condamnées que leurs défauts de conception : études d’impact insuffisantes, volumes excessifs.
Le débat « scientifique » mérite, lui aussi, d’être enrichi.
D’abord, les études hydrologiques menées au plus près des bassins identifient souvent des volumes hivernaux disponibles compatibles avec un retour à l’équilibre, mais sous conditions. À savoir : privilégier les eaux superficielles, mobiliser les plans d’eau déjà existants, fixer des seuils de remplissage protecteurs, et respecter la substitution entre prélèvements hivernaux et estivaux.
Ensuite, le stockage n’est pas forcément antinomique avec la transition du modèle agricole. Mais encore faut-il que la gouvernance de l’eau en fasse un levier territorial de changement collectif des pratiques et de restauration des milieux. Cela suppose de sortir, comme l’ont tenté certains bassins, d’une logique binaire où les deux approches (stockage et agroécologie) sont vues comme mutuellement exclusives, alors qu’elles ne le sont pas nécessairement.
C’est sur ces conditions d’acceptabilité (sociales, écologiques, économiques) que la loi laisse le lecteur assoiffé, car elle laisse en suspens plusieurs points cruciaux. Quelle eau stocker ? Par qui ? Pour cultiver quoi ? Avec quels financements publics ?
Sur ces questions majeures, le législateur se contente de renvoyer à un instrument encore à l’état de brouillon : le projet de territoire pour la gestion de l’eau (PTGE).
À lire aussi : Plan « eau » : la politique des petits tuyaux fera-t-elle les grandes rivières ?
La montée en puissance des PTGE
Longtemps cantonnés à un rôle purement organisationnel, les PTGE changent de statut avec la loi d’urgence agricole. Elle en fait des documents officiels permettant d’adapter les usages à la ressource disponible et de prendre en compte l’évolution des besoins agricoles.
Leur force nouvelle tient surtout à leur rapport avec le schéma d’aménagement et de gestion des eaux (SAGE). Lorsqu’un projet de stockage figure dans un PTGE approuvé, le SAGE doit être révisé pour en tenir compte. Et si la révision n’intervient pas dans le délai fixé, le préfet coordonnateur de bassin peut autoriser une dérogation aux prescriptions du SAGE, sous réserve du respect des volumes prélevables et de la compatibilité avec schéma directeur d’aménagement et de gestion de l’eau (SDAGE).
Ce dispositif est discutable parce qu’il inverse la logique habituelle. Jusqu’ici, les projets d’ouvrages s’inscrivaient nécessairement dans le cadre du SAGE ; demain, ils pourront conduire à l’adapter, voire à l’écarter ponctuellement. Le PTGE devient ainsi un nouvel espace de pouvoir – démocratique ? – au sein de la gouvernance de l’eau, alors même que ses conditions d’élaboration et son contenu sont aux mains du pouvoir réglementaire.
Une gouvernance de l’eau qui tangue
La loi s’attaque, plus largement, à la gouvernance hydrique. D’abord, les organismes uniques de gestion collective (OUGC), chargés de répartir l’eau entre irrigants, sont invités à revoir leurs pratiques.
Il faut savoir que les quotas d’eau individuels sont souvent basés sur des droits historiques, qui ne tiennent pas compte des nouveaux prétendants. En guise de remède, la loi impose aux OUGC d’élaborer une stratégie concertée d’irrigation, de garantir un accès non discriminatoire à l’eau et de publier un bilan annuel des prélèvements. La formulation très générale de ces missions augure toutefois d’une faible portée juridique, alors que la réforme aurait pu en faire de véritables instruments d’orientation des pratiques agricoles.
Ensuite, ce sont les SDAGE et les SAGE qui sont invités à s’« assagir », autrement dit, à réduire leurs ambitions. Pour corriger leur supposé tropisme environnemental, ils doivent désormais intégrer des orientations en faveur de l’optimisation des usages et du stockage, évaluer les conséquences socio-économiques de leurs prescriptions sur l’agriculture et veiller à leur proportionnalité.
Le pouvoir normatif des SAGE se trouve aussi amputé, voire neutralisé : les retenues collinaires agricoles soumises à déclaration ne peuvent plus être interdites ou limitées par ces schémas, lesquels doivent en outre s’adapter aux volumes prélevables fixés par le préfet ainsi qu’aux projets de stockage inscrits dans les PTGE.
La réforme ne remet pas formellement en cause le principe de gestion équilibrée et durable de l’eau. Toutefois, elle complique sa mise en œuvre, en soumettant les restrictions imposées à l’agriculture à une exigence de proportionnalité aujourd’hui impossible à apprécier.
Le recadrage atteint jusqu’à l’expertise scientifique. Les études HMUC (hydrologie, milieux, usages et climat) doivent maintenant intégrer les besoins de stockage de l’agriculture. Après la loi Duplomb, qui leur imposait déjà de prendre en compte la souveraineté alimentaire, les études doivent être à nouveau complétées.
Voilà qui va retarder, et sans doute fragiliser, la détermination des volumes prélevables. Mieux faire place aux besoins agricoles, certes, mais jusqu’à quel point sans brouiller les frontières entre expertise scientifique, arbitrage politique et concertation territoriale ?
Enfin, la loi remodèle la gouvernance de l’eau. Elle renforce la représentation agricole au sein des commissions locales de l’eau (CLE), où la profession dispose désormais d’au moins un tiers des sièges du collège des usagers. Est aussi imposée, au sein de la CLE, la création d’une commission technique dédiée aux usages agricoles, présidée par un agriculteur. Les agences de l’eau demeurent sous la tutelle du ministère chargé de l’environnement, mais plusieurs ministères sectoriels sont désormais associés aux décisions qui les concernent.
Changer le droit de l’eau : en vain ?
Au-delà de son orientation politique, cette loi interroge quant à sa portée effective.
D’un côté, elle opère incontestablement un rééquilibrage de la gestion de l’eau au profit de la corporation agricole. Le texte est cependant loin d’annihiler le principe d’une gestion durable et partagée de la ressource, qui continue de s’imposer aux documents de planification comme aux prélèvements. Comme avant, le juge conservera une importante latitude pour censurer les projets incompatibles avec la préservation de la ressource.
D’un autre côté, les espoirs suscités par cette loi dans le monde agricole risquent fort d’être douchés. S’agissant du stockage, les quelques verrous levés ne suffiront pas à surmonter les obstacles administratifs, techniques et financiers auxquels se heurtent les projets.
Pour le reste, le texte ne propose aucun moyen à l’agriculture de s’adapter au changement climatique. Le législateur, en mettant l’exception agricole à tout bout de champ, verse dans la complexification d’un droit de l’eau déjà très trouble. L’urgence agricole laissera ainsi des traces durables dans la législation, sans apporter de réponses convaincantes à des difficultés bien réelles.
À lire aussi : Comment l’agriculture peut-elle s’adapter aux étés de plus en plus secs ?

Benoît Grimonprez ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
12.10.2026 à 15:54
Exilés en Géorgie, les artistes russes anti-guerre doivent réinventer leur art et leur engagement
Yauheni Kryzhanouski, Chercheur postdoctoral à Plurielles (Université Bordeaux-Montaigne) pour le projet ANR Exilest, chercheur associé au CERCEC (EHESS) et au SAGE (Université de Strasbourg), Université de Strasbourg
Texte intégral (3184 mots)
L’ESSENTIEL
Depuis 2022, la Géorgie a accueilli plusieurs vagues d’artistes russes fuyant les persécutions, la guerre ou la mobilisation.
L’exil transforme leurs pratiques artistiques et professionnelles, tout en les poussant à s’engager en faveur de l’Ukraine et dans les mobilisations géorgiennes.
Face à la montée de l’autoritarisme en Géorgie et à la lassitude suscitée par la guerre, nombre d’entre eux cherchent désormais un nouvel ailleurs et de nouvelles formes artistiques, parfois dépolitisées.
Depuis le début de l’invasion à grande échelle de l’Ukraine, des milliers de Russes ont quitté leur pays, certains pour échapper aux persécutions politiques, le régime du Kremlin s’étant encore durci depuis février 2022, d’autres pour ne pas avoir à vivre dans un pays menant une guerre injuste, d’autres encore pour éviter la mobilisation. Parmi eux, bon nombre d’artistes ont choisi la Géorgie, proche géographiquement, facilement accessible et perçue comme un refuge relativement sûr pour les opposants russes, dès avant l’attaque massive contre l’Ukraine. À Tbilissi, ils ont reconstitué des réseaux, poursuivi leurs activités et parfois profondément transformé leur manière de créer.
Cet exil n’a rien d’un simple déplacement. Il bouleverse les trajectoires professionnelles et personnelles, modifie les pratiques artistiques et place ces Russes opposés à la guerre dans une position parfois paradoxale au sein de la société géorgienne. Quatre ans après l’invasion de l’Ukraine, alors que la Géorgie connaît elle-même un tournant autoritaire, certains de ces artistes envisagent déjà un nouvel exil. Leur parcours révèle ainsi les tensions et les ambiguïtés d’une émigration russe qui ne cesse de se déplacer.
De journaliste à musicien en exil
Dans les années 2010, Alexeï Ponomarev est un journaliste moscovite qui collabore avec plusieurs médias indépendants ; à ses heures perdues, il chante et compose sous le nom de Joker James, mêlant rap et rock indé. En 2021, alors que son épouse de l’époque est citée à comparaître en tant que témoin dans une affaire de haute trahison – un statut qui, en Russie, peut vite se transformer en mise en accusation –, il part avec elle en Géorgie.
Si la famille choisit Tbilissi comme destination d’émigration, c’est avant tout parce que les mesures sanitaires liées au Covid-19 y sont moins strictes que dans l’Union européenne. Alexeï continue un temps ses allers-retours en Russie, jusqu’au début de l’invasion à grande échelle déclenchée contre l’Ukraine en février 2022. Le 2 mars 2022, il quitte définitivement le pays, peu avant ses collègues du média Holod : la censure rend le journalisme indépendant difficilement envisageable.
L’exil se traduit pour Alexeï par plusieurs ruptures. Familiale, d’abord : il se sépare de son épouse, partie s’installer dans l’Union européenne. Professionnelle, ensuite : il a aujourd’hui « presque quitté » le journalisme et vit désormais de la musique, qu’il pratique en artiste à part entière et non plus en amateur. L’exil accentue enfin la politisation de son œuvre, déjà amorcée après l’annexion de la Crimée en 2014.
Privé de ses musiciens, il change de mode de production et se met à enregistrer et à jouer seul, dans l’esprit Do It Yourself (DIY). Fin 2022 sort l’album Khorochiï (Bon), clin d’œil ironique à l’expression « Bon Russe », souvent utilisée pour désigner les Russes anti-guerre.
Rempli de chansons qui dénoncent l’agression visant l’Ukraine et raillent le passé soviétique – l’une d’elles comporte une phrase en ukrainien –, l’album vaut à Alexeï une amende administrative en Russie pour « incitation à la haine » envers les « journalistes des chaînes fédérales » et envers « les Russes ». Avec ses guitares et son looper, il tourne dans les capitales de la « nouvelle émigration russe » – Vilnius, Riga, Tallinn, Belgrade, Erevan, Paris, Berlin –, où il dispose, pendant ses concerts, des urnes destinées à récolter des dons des spectateurs pour les réfugiés ukrainiens. Depuis 2025, il cherche cependant à réinventer Joker James : ses nouvelles chansons s’éloignent de la contestation frontale, le public comme l’auteur se lassant des thèmes tragiques de la guerre et de l’exil.
Bien qu’il juge la communauté exilée russe de Tbilissi plus politisée et plus pro-ukrainienne que celles de Belgrade, Erevan ou Berlin, et qu’il apprécie son « bouillon créatif » associatif et artistique, Alexeï ne s’y sent pas chez lui.
Une partie de la société géorgienne se montre réticente à l’égard des Russes, surtout parmi la jeunesse. Mais c’est surtout le tournant autoritaire du pouvoir géorgien, porté par le parti Rêve géorgien, qui complique son intégration : déjà refoulé sans explication à la frontière en 2022 avant d’être réadmis ; il se dit désormais « intérieurement prêt » à l’être de nouveau à tout moment.
Il a abandonné les cours de géorgien entamés à son arrivée, et son cercle social comme son public restent composés surtout d’immigrés russes, bélarusses et ukrainiens. Après une année passée à Berlin en 2024-2025, il envisage à nouveau de quitter la Géorgie, cette fois pour la France.
Trois vagues d’exil artistique
Le parcours d’Alexeï Ponomarev n’a rien d’exceptionnel. En 2026, dans le cadre du projet de recherche ANR Exilest, j’ai interrogé une dizaine d’artistes russes exilés en Géorgie depuis 2022 : la dessinatrice, performeuse et autrice Daria Apakhonchich, la peintre Alisa Yoffe, l’actionniste Léonid Tsoï, la légende de la scène underground pétersbourgeoise Arseny Morozov et son ancien complice des groupes Sonic Death et Arseny Krestitel (Arséni le Baptiste), le batteur Sam Twilight, ainsi que d’autres artistes ayant préféré rester anonymes. Leurs trajectoires éclairent les tensions, les ruptures et les ambiguïtés propres aux cercles culturels russes récemment exilés.
Comme les autres exilés russes, les artistes arrivés en Géorgie se répartissent en trois vagues. La première, à l’image d’Alexeï Ponomarev ou de Daria Apakhonchich, part avant même la guerre, en général pour fuir des poursuites politiques. Daria a quitté la Russie début 2021 après une arrestation (pour participation à des performances féministes et autres activités militantes, notamment l’organisation de camps d’été anti-guerre en Finlande pour des activistes russes et ukrainiens) suivie de l’attribution du statut d’« agent de l’étranger », ce qui restreignait ses activités. L’invasion de l’Ukraine rendra tout retour de ces dissidents plus improbable encore.
La deuxième vague, également politisée, suit le début de l’invasion à grande échelle, le 24 février 2022 : opposition à la guerre, peur des répressions ou refus de continuer à créer dans un pays désormais perçu comme agresseur motivent ces départs.
Comme le raconte Alisa Yoffe :
« Je comprenais que je ne pouvais pas rester là et créer mes œuvres d’art. Les exposer, dans cette situation, dans ce contexte. Je suis, disons, payée en échange. Par qui ? Et ensuite où est-ce que je verse cet argent, où vont les impôts ? En somme, toute cette chaîne alimentaire pour moi… devait être transférée avec mon corps vers un autre lieu. »
Sam Twilight, lui, ne voyait pas comment continuer à « divertir son public » en temps de guerre :
« Nous avions des groupes assez… disons… couronnés de succès dans des cercles restreints, mais nous n’avons pas jugé possible de poursuivre une quelconque activité créative dans un contexte de guerre. […] Je ne voyais pas comment il aurait été possible de continuer à faire de la création, de la musique, de l’"entertainment", dans ces réalités. »
Ces départs, souvent improvisés dans une atmosphère de fin du monde, restent dans la mémoire d’Arseny Morozov :
« Nous avons senti comme des vagues — nos amis partent, tout le monde part. […] C’était le sentiment de l’exode : le pays qui part. »
Enfin, ceux qui étaient initialement restés en Russie, y compris pour y protester, partent avec l’annonce de la mobilisation militaire « partielle » de septembre 2022 : cette troisième vague, majoritairement masculine, fuit dans l’urgence pour échapper à l’appel sous les drapeaux.
Quelle que soit la vague de départ, le choix de la Géorgie tient à plusieurs facteurs. D’un côté, les formalités y sont plus légères que dans l’UE, pour le séjour comme pour l’activité professionnelle, et le coût de la vie plus faible. D’un autre côté, en 2022, la Géorgie bénéficie de l’image d’un pays sûr pour les opposants russes. À la différence d’autres pôles de la nouvelle émigration russe comme le Kazakhstan, l’Arménie ou la Serbie, il y a peu de coopération (et donc de risques d’extradition) avec la Russie, dans un contexte marqué par l’occupation russe de deux régions géorgiennes (l’Abkhazie et l’Ossétie du Sud) ; et la société géorgienne est vue comme très pro-ukrainienne.
Une fois sur place, la plupart poursuivent leur pratique artistique. Pour certains, comme Alexeï Ponomarev, l’exil consacre une reconversion professionnelle définitive ; pour d’autres, il ouvre une rupture créative.
Arséni Morozov politise l’expression de son groupe Sonic Death, qui intègre désormais des chansons en ukrainien, puis fonde avec Alisa Yoffe le projet d’« auto-culpabilisation » Xanax Tbilisi, anglophone — « parce que je comprenais qu’on ne pouvait pas chanter en russe ».
Daria Apakhonchich abandonne performances et actions de rue pour l’écriture autobiographique : « Je ne connaissais pas le contexte géorgien, je ne pouvais pas imposer mes codes. » Elle poursuit toutefois son projet des « Lettres d’amour au ministère de la justice » russe : détournant l’obligation, propre à son statut d’« agent de l’étranger », de déclarer ses activités, elle envoie à Moscou des formulaires officiels transformés en dessins contestataires.
Pour Alisa Yoffe, la liberté retrouvée en Géorgie permet d’assumer pleinement des messages jusque-là difficilement réalisables : « Je peux écrire “La Russie tue”, je peux le dire ouvertement. »
Si les plus établis ou chanceux vivent de leur art, d’autres exercent des métiers alimentaires variés, de la gestion d’un bar à la restauration ; Daria enseigne le russe à des étudiants étrangers, tandis que Léonid Tsoï exerce aussi comme psychologue.
Simultanément, ces artistes s’engagent aussi sur le terrain militant : la plupart collaborent avec des associations d’aide aux réfugiés ukrainiens ou participent à des événements caritatifs et à des collectes de dons. Plusieurs participent également, à l’invitation d’amis géorgiens, aux mobilisations contre les réformes autoritaires du parti Rêve géorgien, notamment la loi sur les « agents de l’étranger » : Arséni Morozov y brandit des pancartes en géorgien, quand celle de Léonid Tsoï proclame « I thought I left Russia ».
Une toile monumentale anti-guerre d’Alisa Yoffe a même été déployée devant le parlement géorgien lors de manifestations pro-ukrainiennes.
Une intégration sous tension
La position de ces exilés — engagés contre la guerre, mais d’origine russe — reste toutefois ambiguë dans la société d’accueil, entre insultes ponctuelles dans la vie quotidienne et réticences de la scène culturelle locale ; les collaborations avec des artistes géorgiens demeurent rares.
Cette méfiance, alimentée par la hausse des loyers suite à l’arrivée des exilés et le souvenir des différentes formes de domination russe qui se sont toujours accompagnées d’une « russification culturelle » – colonisation impériale, statut périphérique au sein de l’URSS, occupations territoriales actuelles –, est en général comprise par les artistes russes eux-mêmes.
À lire aussi : Géorgie : quand la dénonciation du pouvoir pro-russe actuel s’appuie sur la mémoire des répressions soviétiques
Le problème le plus sérieux tient plutôt au tournant autoritaire géorgien, qui accroît le risque d’expulsion et prive les exilés de toute perspective de résidence stable. Cette précarité pousse la quasi-totalité des artistes interrogés à partir vers une nouvelle destination ou à s’y préparer : Arséni Morozov et Alisa Yoffe vivent désormais à Paris, Daria Apakhonchich à Cologne, Léonid Tsoï à Erevan, tandis que Sam Twilight parcourt le Vietnam en quête de ville où s’installer.
Quand l’art se détache de la guerre
La dernière ambiguïté que doivent affronter les artistes en exil est l’évolution de la politisation de leur œuvre. Si, en 2022-2023, l’engagement frontal contre la guerre, y compris dans l’œuvre, semblait la seule réponse possible à l’horreur du conflit et à l’effondrement de leur cadre de vie, quatre ans plus tard les principes d’autonomie artistique et de primauté de l’esthétique reprennent le dessus.
Tout se passe comme si le temps était venu de chercher de nouvelles formes d’expression, moins immédiatement tributaires de l’abîme politique et psychologique creusé par la guerre – l’art renouant avec sa fonction de quête de vérités plus universelles.

Yauheni Kryzhanouski a reçu des financements de l'Agence nationale de la recherche (ANR).
12.10.2026 à 15:53
Additifs alimentaires dangereux dans nos assiettes : quand les industriels contournent les règles (du XIXᵉ siècle à nos jours)
Hachez-Leroy Florence, Historienne de l'économie, des sciences et des techniques, Université d'Artois
Texte intégral (1862 mots)
L’ESSENTIEL
L’emploi d’additifs alimentaires est mentionné dès l’Antiquité, mais les progrès de la chimie au XIXᵉ siècle ont permis de banaliser leur utilisation.
Les dangers de ces additifs sont rapidement connus et des vagues de régulation se succèdent à partir de 1905 avec la loi sur l’alimentation.
Ces dernières décennies, la mondialisation des échanges et la consommation massive d’aliments ultratransformés ont rendu la régulation encore plus difficile.
Les controverses sur les additifs alimentaires occupent régulièrement l’actualité avec leurs scandales : colorants, conservateurs, exhausteurs de goût, sel, aluminium, etc.
L’emploi d’additifs dans l’alimentation est mentionné dès l’Antiquité, mais les progrès de la chimie ont eu pour effet d’élargir leur nombre et de banaliser leur utilisation. Un nombre considérable de nouvelles substances aux usages variés apparaissent pour améliorer les conditions de conservation, contrôler les qualités gustatives ou modifier l’aspect visuel des aliments. En 1800, environ 550 substances chimiques organiques étaient connues et leur nombre a atteint environ 150 000 au tournant du XXᵉ siècle.
Quelles furent les grandes étapes de cette régulation, et quel bilan tirer de cette action, alors que la quantité de substances utilisées n’a cessé de croître depuis le XIXᵉ siècle ?
Conserver sans intoxiquer
Les conservateurs sont les additifs les plus utiles pour prolonger la durée de consommation des aliments dans de bonnes conditions sanitaires. Les premiers usages systématiques des conservateurs de synthèse dans l’industrie sont difficiles à dater faute de sources, mais des exemples permettent de comprendre leur développement.
En 1837, les Allemands Wöhler et Liebig découvrent les propriétés chimiques de l’acide benzoïque (E 210), un conservateur alimentaire présent naturellement dans certaines plantes, dont l’amande amère. Son développement semble rapide et en 1879, les archives rapportent des discussions entre Pasteur et le préfet de la Seine pour l’autoriser. D’autres conservateurs sont utilisés comme l’acide borique, le borate de soude et l’acide salicylique dans les années 1870. L’usage du borax (E285) est aussi ancien, en particulier en métallurgie et marginalement en médecine. Son emploi dans l’alimentation, nouveau au XIXᵉ siècle est largement encouragé par les industriels. Le borax est interdit dans l’Union européenne depuis 2010, mais reste autorisé dans d’autres pays.
Couleurs et arômes artificiels
La découverte de l’aniline à partir de l’indigo, en 1826, a donné naissance à de nombreuses autres couleurs artificielles ou de synthèse. La nomenclature des substances interdites pour la coloration des aliments et de leurs papiers d’emballage témoigne de la riche palette des possibles : substances d’origine minérale comportant des composés de cuivre, de plomb et d’arsenic, le sulfate de mercure – notamment les dérivés du goudron de houille –, et colorants d’origine organique, comme la fuchsine et ses dérivés.
Les arômes suivent le même mouvement tel l’« arôme de beurre » à base d’aldéhyde benzoïque, de nitrobenzène et d’acide butyrique, ou l’arôme « noix de coco ». Ils sont complétés par les exhausteurs de goût. Identifié au XIXe siècle, le glutamate de sodium est isolé au début du XXe siècle dans une algue, son usage se répand largement. Et l’on pourrait poursuivre avec les modificateurs de texture et les émulsifiants – la margarine, en 1869 –, les épaississants, les gélifiants ou encore les phosphates, dont le phosphate d’aluminium sodique, utilisé en boulangerie dès les années 1870 aux États-Unis, la fameuse levure chimique.
La régulation à partir de 1914
Le XIXᵉ siècle n’est donc pas une période où l’on pouvait se nourrir sans danger, loin de là : des pratiques alimentaires frauduleuses et le développement des additifs alimentaires conduisaient à la mise sur le marché d’aliments toxiques.
En réaction, des vagues de régulation se sont succédé dans les pays européens dès avant 1914. En France, la dangerosité des additifs est combattue après la fraude et la falsification des denrées. La régulation est progressive, jusqu’à la loi de 1905 sur l’alimentation.
Les colorants sont encadrés à partir de 1911. Leur approbation est soumise à une double tutelle conjointe des ministres de l’agriculture et de l’intérieur, sur avis conjoint du Conseil supérieur d’hygiène publique de France et de l’Académie de médecine. On peut y voir la main d’Eugène Roux, figure emblématique de la régulation de l’alimentation, directeur du service de répression des fraudes du ministère de l’agriculture.
À partir de 1912, l’usage des additifs alimentaires est interdit, à l’exception des cas déterminés par la loi. Le législateur détaille aussi les types d’emballage et les revêtements apposés à l’intérieur.
Certaines exceptions demeurent : le plomb et l’arsenic, autorisés dans les alliages, avec des pourcentages précisés. Le cuivre, le zinc et le fer galvanisé sont explicitement exclus des processus de fabrication et de conservation à l’exception de trois secteurs : chocolaterie, confiserie et distillerie.
Mais les industriels et artisans font preuve d’une exceptionnelle inventivité pour contourner la loi : la nécessité d’écouler des stocks, le lobbying auprès des ministères, l’usage non déclaré, l’erreur de manipulation, la minimisation du risque, le financement d’études « scientifiques » manipulées et l’instrumentalisation du doute bien sûr, arme favorite déployée déjà au XIXᵉ siècle.
La régulation de l’entre-deux-guerres et de la fin du XXᵉ siècle
La régulation connaît une accélération dans l’entre-deux-guerres. Parallèlement, la recherche scientifique progresse dans la compréhension des processus de dégradation des denrées et dans leur analyse toxicologique. Les chercheurs œuvrent auprès des pouvoirs publics pour protéger les populations et faire évoluer les lois : Louis Pasteur en France, Friedrich Accum en Allemagne, et Harvey W. Wiley aux États-Unis. Ils contribuent à développer la formation des chimistes en alimentation, dont le travail au sein des administrations et des entreprises participe au renforcement des contrôles sanitaires.
Pourtant, tout au long du XXᵉ siècle, l’usage de substances nouvelles est exponentiel. En outre, l’industrie agroalimentaire rend ces additifs indispensables à l’alimentation, sans en mesurer les effets sur la santé. Les recherches sur la toxicité de ces substances, qui nécessitent des moyens considérables, dépassent alors les possibilités des institutions publiques. Après-guerre, ce sera l’un des moteurs du développement d’organisations internationales comme l’Organisation mondiale de la santé (OMS) et l’Organisation des Nations Unies pour l’alimentation et l’agriculture (FAO). De fait, à partir des années 1950, la régulation conduit à une progressive et importante diminution du nombre d’additifs autorisés, tandis qu’est posée la question de l’exposition des consommateurs à ces substances et instaurée la dose journalière admissible.
Reste que ce mouvement est très vite soumis aux coups de boutoir des industriels. Créée en 1955, la Conférence mixte FAO/OMS sur les substances ajoutées aux denrées alimentaires permet la création d’un Comité d’experts des additifs alimentaires. Ce dernier publie un premier rapport très complet sur la nature et l’usage des additifs, les recherches à mener, l’information des consommateurs à assurer, etc. Mais dès le second rapport, en 1958, une personnalité issue de la Dow Chemical Company, l’une des plus grandes entreprises chimique américaine, est nommée au sein de ce comité. Dès lors, les travaux seront teintés d’un certain « pragmatisme » afin que soient préservées les possibilités de développements commerciaux des additifs.
La situation actuelle
Qu’en est-il aujourd’hui ? La mondialisation a renforcé les lobbys industriels. La situation s’est largement complexifiée pour de multiples raisons qui s’entrecroisent :
interactions entre substances dont les mécanismes restent à comprendre mais suspectées dans de nombreuses pathologies ;
consommation d’aliments ultratransformés ;
effets à très long terme comme les perturbateurs endocriniens ;
omniprésence de ces substances, dont les plastiques, dans notre environnement avec des contaminations multiples ;
différences importantes de législation et de contrôle selon les pays dans un espace mondialisé, qui fragilisent les dispositifs normatifs européens.
Les travaux en santé environnementale n’ont de cesse d’alerter sur la dangerosité des intrants agricoles et des additifs alimentaires. L’histoire longue montre, s’il le faut, à quel point la régulation a été et reste indispensable pour protéger les consommateurs et l’environnement, et relève du droit à l’alimentation.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Hachez-Leroy Florence a reçu des financements de l'IUF et de l'ANR.
12.10.2026 à 15:51
Cueillettes de plantes et de champignons : gare aux parasites, voici comment les éviter
Françoise Debierre-Grockiego, Enseignant chercheur, Université de Tours
Texte intégral (2864 mots)
L’ESSENTIEL
Les plantes cueillies dans la nature ou dans les jardins peuvent être contaminées par des parasites.
Bien que le lavage aide à éliminer certains parasites, il n’est pas toujours efficace.
Seule la cuisson à une température suffisante permet de s’assurer que le risque est totalement levé.
Fraises des bois, mûres des chemins, menthe sauvage, cèpes ou trompettes de la mort… la cueillette de plantes et de champignons comestibles dans la nature a de nombreux adeptes en France.
Cependant, il ne faut pas oublier que ces aliments peuvent avoir été souillés par des excréments d’animaux sauvages ou domestiques. Or, ces derniers contiennent parfois des parasites responsables de maladies plus ou moins graves. Un constat qui vaut aussi pour les aliments ramassés dans les jardins potagers, y compris en zone urbaine.
Heureusement, si vous pratiquez la cueillette, quelques mesures d’hygiène simples permettent de consommer sans risque les produits récoltés, en évitant les complications médicales.
Quels sont les parasites en cause en France ?
Les excréments des animaux, qu’ils soient sauvages ou domestiques, peuvent contenir non seulement des bactéries, des virus ou des champignons microscopiques potentiellement dangereux pour la santé, mais aussi des parasites responsables de maladies plus ou moins graves. C’est à cette dernière catégorie de pathogènes que nous allons nous intéresser.
À lire aussi : Virus, bactérie, parasite ? Connaissez vos microbes sur le bout des doigts !
En France, les parasites retrouvés dans la nature sont principalement hébergés dans l’intestin ou le foie d’animaux et d’êtres humains. Au cours de leur cycle de reproduction, ils se dispersent dans l’environnement en étant excrétés avec les selles de leurs hôtes.
Point très important à souligner : certains parasites peuvent persister jusqu’à plusieurs mois dans l’environnement, et rester infectants alors que la moindre trace de déjection a disparu depuis longtemps !
Parmi les parasites les plus courants dans notre pays, certains sont des parasites unicellulaires (donc microscopiques). C’est, par exemple, le cas de Giardia duodenalis, responsable de la giardiase. Cette infection intestinale provoque des vomissements et des diarrhées pouvant devenir chroniques et entraîner des pertes de poids, voire des carences alimentaires (750 cas notifiés entre 2017 et 2019).
Autre parasite unicellulaire courant, Cryptosporidium parvum est, quant à lui, responsable de la cryptosporidiose, à l’origine, là encore, de diarrhées (près de 4 500 cas dépistés en Europe en 2021). Enfin, Toxoplasma gondii, le parasite responsable de la toxoplasmose, fait l’objet d’une surveillance particulière chez les femmes enceintes (118 cas de toxoplasmoses congénitales en 2023). Il peut en effet provoquer des atteintes fœtales pouvant aller jusqu’à des malformations ou un avortement spontané. Dès que l’infection de la femme enceinte est connue, un traitement est mis en place pour limiter les complications (association d’un antiparasitaire et d’un antibiotique). En outre, la présence de Toxoplasma gondii dans les tissus peut parfois entraîner une dégradation de la rétine ou, dans les cas les plus graves, une encéphalite. Le même traitement est alors appliqué.
Parmi les autres parasites présents en France, citons les échinocoques, des vers plats parasites vivant dans l’intestin des canidés (chiens, renards) et des chats. Echinococcus granulosus et Echinococcus multilocularis sont responsables de deux maladies très graves lors d’infection accidentelle humaine (une vingtaine de cas pour chacune d’elles en 2024), l’échinococcose kystique et l’échinococcose alvéolaire.
À lire aussi : Les échinococcoses, des maladies parasitaires en expansion
D’autres vers (ronds, ceux-là), vivant dans l’intestin des canidés et des chats, Toxocara canis et Toxocara cati, peuvent aussi être responsables de la toxocarose, dont les symptômes, qui sont dus à la migration des larves dans différents organes et tissus (sans qu’elles ne se transforment jamais en vers ; on parle de « larva migrans »), peuvent consister en fièvre, en toux, en gonflement du foie (hépatomégalie), en pneumonie, voire plus rarement en encéphalite ou en atteinte de l’œil.
Dans les cas des échinocoques et des vers ronds du genre Toxocara, la gravité dépend essentiellement de la localisation des larves. En toute logique, les atteintes sont plus importantes lorsque les parasites se logent dans les organes essentiels (cœur, poumon, foie, cerveau). La grande variabilité des manifestations possibles rend alors le diagnostic très difficile à établir.
Enfin, citons le cas particulier de la grande douve du foie, Fasciola hepatica, dont les vers sont localisés dans les canaux biliaires des mammifères herbivores, qu’ils soient domestiques ou sauvages (vaches, moutons, chèvres, sangliers, ragondins, etc.). Les œufs qu’ils produisent rejoignent les intestins, et sont expulsés avec les selles.
Lorsqu’une flaque d’eau est contaminée par des selles contenant des œufs, les larves qui en sortent peuvent infester de nouveaux hôtes, les limnées, des sortes de petits escargots aquatiques mesurant moins d’un centimètre. Les larves se multiplient dans ces mollusques gastéropodes, s’y transforment, puis s’en échappent sous leur nouvelle forme larvaire pour se fixer sur des plantes.
Parmi les différentes herbes concernées figurent notamment le cresson ou le pissenlit, très appréciés par certains gourmets. En cas d’ingestion, les larves de douves se retrouvent accidentellement dans les canaux biliaires et le foie des consommateurs, où elles arrivent à maturation. Les vers et leurs œufs provoquent alors obstruction, inflammation et fibrose.
À lire aussi : Pourquoi la grande douve du foie est une menace latente, même en France
La maladie résultante, appelée fasciolose, se manifeste par une phase aiguë (accompagnée de fièvre, de nausées, de fortes douleurs abdominales et de gonflement du foie) et une phase chronique, qui peut durer des années et se manifeste par des douleurs dans la région supérieure centrale de l’abdomen (douleurs épigastriques), des nausées, une intolérance aux graisses, une inflammation et une obstruction des canaux biliaires ainsi que des lésions hépatiques, une jaunisse et une anémie.
Des affections sous-diagnostiquées
La gravité des maladies causées par les parasites dépend non seulement de facteurs liés au parasite considéré (comme sa capacité à proliférer ou à échapper au système immunitaire), mais aussi de facteurs liés à l’hôte (maladie chronique, déficit immunitaire, etc.).
En outre, le risque de développer des symptômes est plus important lorsque la quantité de parasites ingérés est élevée.
La sensibilité individuelle est également prépondérante dans l’apparition et l’évolution de la maladie. Pour les personnes en bonne santé générale, c’est-à-dire la majorité des cas, il y aura peu ou pas de symptômes pour tous les parasites cités ici.
Pour les populations dites « fragiles », telles que les jeunes enfants, les personnes de plus de 65 ans ou les patients atteints d’un déficit immunitaire, les troubles peuvent être plus graves.
Point important à souligner : le nombre réel de cas d’infections par l’ensemble de ces parasites est largement sous-estimé dans notre pays. En effet, le diagnostic n’est pas systématique, soit parce que les symptômes sont légers et de courte durée, soit parce qu’un traitement est administré au plus tôt sans attendre de connaître la cause précise (antidouleur, antipyrétique, parfois pris en automédication).
Quelles sont les zones géographiques concernées ?
Avant tout, il faut faire la distinction entre les parasites hébergés par de nombreuses espèces animales, qui sont donc très fréquents, et les parasites plus restrictifs, et donc plus rares.
Giardia duodenalis et Cryptosporidium parvum sont présents dans les déjections de nombreuses espèces de mammifères, dont les humains. Toxoplasma gondii est quant à lui présent uniquement dans les déjections des félidés, comme le chat européen (on le retrouve cependant aussi piégé sous forme de kystes dans les tissus des autres mammifères et des oiseaux).
En France, les parasites qui contaminent fréquemment les humains, tels que Giardia duodenalis, Cryptosporidium parvum, Toxoplasma gondii ou Toxocara canis, contaminent également un grand nombre d’animaux domestiques et sauvages (bovins, ovins, chiens, chats). Ils sont donc cosmopolites, c’est-à-dire qu’ils sont répartis sur tout le territoire hexagonal. On les trouve également dans les outre-mer.
Les autres espèces données ici en exemple, la douve et les échinocoques ont une répartition géographique plus restreinte, en raison des spécificités de leur cycle de vie.
Les larves d’Echinococcus granulosus se multipliant dans le foie de mammifères herbivores, cette espèce se trouve principalement dans les zones d’élevages, notamment de moutons (Corse, Provence-Alpes-Côte d’Azur, Landes, Pays basque). L’espèce Echinococcus multilocularis est apparue en France en provenance de l’est de l’Europe, véhiculée par des renards, et sa progression vers le nord et l’ouest du pays est très lente.
Pour ce qui est de Fasciola hepatica, son existence requiert la présence simultanée de grands mammifères herbivores et des limnées aquatiques et est donc étroitement liée à la pratique du pâturage en zones humides (Auvergne, Centre, Limousin et Ouest avec une majorité de cas humains en Limousin). Les risques de contamination sont donc variables en fonction des régions.
Un point important à ne pas oublier est que les parasites peuvent aussi se trouver dans les jardins potagers et les tas de compost, qui peuvent être visités par les chats du voisinage, voire par des renards, même en zones urbaines.
Les gestes à adopter pour limiter les risques
La prise de risque est la plus importante lorsque plantes et champignons sont consommés crus et non lavés. Le nettoyage des champignons avec une brosse ne fait pas partie des recommandations pour éliminer les parasites.
Le lavage sous le jet d’eau du robinet (et non pas par trempage !), si possible en frottant bien, permet de retirer mécaniquement une très grosse partie des pathogènes.
Mais certains aliments fragiles, tels que champignons ou baies, ne supportent pas un tel traitement. De plus, cette méthode n’est pas du tout efficace pour éliminer les larves de Fasciola hepatica, trop fortement fixées sur les feuilles pour être emportées avec le liquide.
Il est souvent entendu que l’ajout de vinaigre permet de laver plus efficacement les fruits et légumes, mais en réalité, il est trop dilué pour avoir un effet désinfectant. Des expériences en laboratoire ont montré que la destruction totale des formes de résistance (autrement dit les formes qu’adoptent les parasites pour survivre quand les conditions de l’environnement sont défavorables) de Toxoplasma gondii demande une application de chlore, d’alcool ou d’acide à des concentrations élevées, ce qui est à la fois dangereux pour la santé et pour les aliments traités.
Le seul moyen permettant de détruire assurément tous les parasites est la cuisson (poêlée de champignons, soupe de cresson, confitures et tartes pour les baies…). Plus la température est élevée et plus la destruction est rapide (en moins de cinq minutes au-delà de 70 °C). Le réchauffement au four à micro-ondes est à considérer avec précaution pour tuer les parasites, car la température peut ne pas être homogène au sein des aliments.
Enfin, il n’existe que peu de données concernant la survie des parasites lorsque les plantes sont séchées à basse température (inférieures à 30 °C) pour préserver leurs propriétés médicinales. Dans un tel cas de figure, il est préférable de les utiliser dans des préparations culinaires cuites, ou de les ébouillanter si elles sont destinées à des infusions ou des décoctions.
En cas de doute, que faire ?
Si la consommation de plantes et de champignons sauvages fait partie des voies de contamination par les parasites à ne pas négliger, il faut se souvenir qu’il en existe bien d’autres.
Parmi elles, on peut citer la baignade en milieu naturel (contamination par la bouche, le nez ou la peau), la consommation d’aliments crus ou peu cuits (viandes, fruits de mer, légumes, fruits, herbes aromatiques…), la mise à la bouche de mains souillées (après avoir touché la terre, le sable, des animaux domestiques, tout objet lui-même souillé par contact avec le sol, par exemple, etc.), la consommation d’eau du robinet (lors de voyages, surtout, car ce mode de contamination est très rare en France), ou encore la mauvaise habitude qui consiste à tolérer de se faire lécher le visage par son chien ou son chat…
Il faut consulter un médecin en cas de diarrhées, de douleurs persistantes ou de fièvre. Il pourra alors demander un examen parasitologique des selles qui permet de mettre en évidence la présence de Cryptosporidium parvum, de Giardia duodenalis et de Fasciola hepatica. Les toxocaroses et les échinococcoses tissulaires sont diagnostiquées par imagerie ou par biopsie. Des antiparasitaires seront prescrits si nécessaire, mais ils ne sont pas efficaces à 100 % sur ces espèces.
Enfin, rappelons que les parasites ne sont pas les seuls microorganismes présents dans l’intestin des animaux, qui abritent aussi des virus, des bactéries et des champignons microscopiques potentiellement dangereux pour la santé. Suivre les mesures d’hygiène alimentaire évoquées ici permet de prévenir non seulement les maladies parasitaires, mais aussi l’ensemble des maladies infectieuses concernées.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Françoise Debierre-Grockiego ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
12.10.2026 à 15:51
La violence d’être cloné : et si le deepfake n’était pas qu’un mensonge, mais aussi une atteinte à notre corps numérique ?
Adela Barbulescu, Ingenieur de recherche (audio-visual speech synthesis, multimodal AI, affective computing), Inria; Université de Bordeaux
Texte intégral (2604 mots)
L’ESSENTIEL
Les deepfakes (ou hypertrucages en français) sont des images et des vidéos truquées générées à l’aide d’intelligences artificielles génératives. Un grand nombre d’entre elles sont des contenus pornographiques non consentis.
En se focalisant sur l’authentification de la véracité des contenus, on occulte une partie du problème : le tort fait aux victimes dont l’identité est volée pour être manipulée a des conséquences dans la vie physique.
Aujourd’hui, les protections juridiques sont fragmentées. En agissant en amont de la génération de deepfakes malveillants, pourrait-on mieux se protéger de ces atteintes à nos corps numériques ?
En 2018, la journaliste Rana Ayyub a subi une campagne de cyberharcèlement avec des vidéos pornographiques truquées utilisant son image pour la faire taire à la suite de ses enquêtes en Inde.
La violence de ce harcèlement, dénoncé par le Haut-Commissariat des Nations unies aux droits de l’homme, ne vient pas seulement du mensonge : la vidéo produite utilise le visage d’une femme réelle pour lui imposer une scène qu’elle n’a jamais vécue ni acceptée. Son identité et son intimité sont devenues une arme contre elle.
Le terme « deepfake », qui désigne une image, un son ou une vidéo généré ou modifié par un réseau d’apprentissage profond (deep learning) afin de reproduire l’apparence ou la voix d’une personne réelle, est souvent associé à des fins malveillantes. Les exemples sont nombreux.
La désinformation : en Slovaquie, lors des législatives de 2023, un faux enregistrement audio attribué au chef du parti pro-européen a été diffusé en plein silence électoral. La fraude : à Hong Kong, un salarié a viré près de 24 millions d’euros après une visio où tous les autres participants étaient des deepfakes ; tandis qu’en France, les tentatives de fraude par deepfake ont bondi de 700 % en un an. Les images intimes non consenties : une étude de 2019 recensait 96 % de contenus pornographiques non consentis parmi les vidéos deepfake en circulation ; et en 2026, Grok a été utilisé pour générer des millions de deepfakes à caractère sexuel sur X.
Ces affaires sont graves. Pourtant, elles ne disent pas tout. Quand une personne est clonée sans son consentement, ce n’est pas seulement l’argent ou la vérité qu’on lui enlève. C’est une part de soi : une atteinte à son visage, à sa voix, à ses gestes et à la confiance que les autres lui accordent.
La violence d’être cloné : une atteinte au corps numérique
Imaginez une vidéo où l’on voit votre visage. Vous y parlez avec votre voix, vous souriez, vous bougez. Pourtant, vous n’avez jamais tourné cette vidéo. Vous n’avez jamais dit ces mots. Quelqu’un a utilisé votre image et votre voix pour fabriquer un double de vous.
On peut désigner le « corps numérique » comme l’ensemble des signaux par lesquels on nous reconnaît : visage, voix, gestes, expressions, façon de parler et de bouger. Ce concept est une représentation numérique de l’humain physique, une prolongation du corps biologique. Ces signaux ne sont pas seulement des données ou des fichiers, ils forment la couche corporelle de notre identité numérique.
Les travaux en apprentissage automatique traitent les deepfakes comme un simple problème de vérification, proposant d’authentifier et de détecter le faux, en ignorant la personne dont le corps numérique a été instrumentalisé. Or, plusieurs études montrent que le fait de savoir que la vidéo est fausse n’atténue pas la souffrance de la victime, et peut même l’aggraver.
La recherche parle d’atteintes incarnées (ou embodied harms) pour désigner cette violence qui fracture le rapport au corps et à l’identité bien au-delà de l’écran. Quand la journaliste Rana Ayyub a été ciblée par des vidéos pornographiques synthétiques, l’impact a été immédiat : isolement, anxiété aiguë et sentiment d’effraction intime.
De plus, des études qualitatives sur les clones IA identifient une « doppelganger-phobie » (un Doppelgänger est le sosie d’une personne), un rejet émotionnel face au potentiel de ces contenus à s’approprier et à déplacer l’identité d’une personne, même sans contenu explicite.
Une histoire de la synthèse humaine
En informatique graphique, la synthèse humaine est le fait de produire numériquement l’apparence d’une personne : son visage, sa voix, ses mouvements. C’est la famille de techniques dont les deepfakes sont l’expression la plus récente.

Pourtant, la synthèse humaine n’est pas née avec les modèles génératifs. En 1957, Kirsch, Cahn, Ray et Urban présentent la première numérisation d’image : un portrait de trois mois de Walden Kirsch, le fils du chercheur.
Depuis, cinéma, musique et jeu vidéo ont inventé avatars et voix de synthèse. L’intégration d’acteurs virtuels dans le cinéma s’installe après le film The Crow (1994) : à la mort de Brandon Lee en plein tournage, l’équipe termine les scènes manquantes en superposant numériquement son visage sur le corps d’une doublure, avec l’accord explicite de sa famille.
En 2007, la chanteuse virtuelle Hatsune Miku, dont la voix est synthétisée à partir d’échantillons enregistrés contractuellement par une comédienne, au moyen du logiciel Vocaloid de Yamaha, popularise un modèle de création où chacun peut commercialiser ses propres compositions avec sa voix.
Le mot « deepfake » lui-même naît d’une rupture nette du consentement : en 2017, un utilisateur de Reddit surnommé « Deepfakes » partage des vidéos pornographiques d’actrices célèbres, utilisant une technique de substitution de visage (face swap) reposant sur un auto-encodeur.
C’est à cette époque que les techniques pour générer des deepfakes se sont enchaînées : les réseaux antagonistes génératifs (GAN) en 2014, puis les transformers en 2017, jusqu’aux modèles de diffusion en 2020, qui dominent la génération d’images aujourd’hui.
Consentement et frontière juridique
La recherche en informatique réduit le deepfake à un problème de criminalistique (ensemble de techniques mises en œuvre pour établir la preuve d’un délit ou d’un crime et en identifier l’auteur) : traque des incohérences de pixels et de la provenance cryptographique pour distinguer le vrai du faux.
Cette approche est réductrice, car elle vérifie l’authenticité de l’image, et non la légitimité de son existence. Le système juridique mobilise des protections fragmentées sur la propriété, sur la réputation ou sur la vie privée plutôt qu’un droit unifié à l’intégrité de l’identité numérique.
La loi visant à sécuriser et à réguler l’espace numérique (loi SREN) de 2024 sanctionne la diffusion d’un deepfake, non l’atteinte à l’identité ; et l’article 50 de l’AI Act européen, appliqué depuis août 2026, impose de signaler les contenus générés par IA, protégeant le droit du public à être informé, mais pas l’intégrité de la personne représentée.
Ce vide oblige les parties à trouver des solutions au cas par cas. En France, 25 comédiens de doublage ont obtenu le retrait de 47 voix clonées en mettant en demeure les plateformes de clonage vocal Fish Audio et VoiceDub. Des artistes protègent leurs attributs, de Scarlett Johansson face aux abus d’OpenAI à Matthew McConaughey déposant sa voix et son image.
Mais renforcer cette protection soulève une difficulté : jusqu’où aller sans menacer la liberté d’expression ? C’est l’alerte des défenseurs des libertés numériques comme l’Electronic Frontier Foundation (EFF, Fondation des frontières numériques), une organisation de défense des droits sur Internet, pour qui une régulation doit cibler l’intention malveillante afin de ne pas étouffer la parodie et la satire.
C’est ce qui pousse des pionniers à réinventer le cadre. Par exemple, le Danemark a proposé d’accorder à chacun un droit direct sur son visage, sa voix et son corps, marquant la première tentative européenne de faire du consentement à l’identité numérique un droit à part entière : l’usage de l’image sans accord y deviendrait illicite en soi, sans que la victime ait à prouver un préjudice.
Protéger l’identité numérique : un nouveau standard
L’enjeu est de bâtir un véritable standard d’identité numérique : un cadre commun, partagé par tous, qui rende vérifiables l’origine d’un contenu et le consentement de la personne représentée. Des standards ouverts comme C2PA en posent une première pierre, en attachant aux médias des métadonnées infalsifiables sur leur provenance. Mais un tel standard n’a de valeur que s’il est adopté par tous et soutenu par un cadre juridique et technique capable de le faire respecter.
Aujourd’hui, la réponse technique dominante reste la détection a posteriori : repérer un contenu cloné une fois qu’il a déjà été produit et diffusé.
Une seconde approche, complémentaire, consiste à agir en amont : protéger le média à la source pour empêcher son détournement, à l’aide de techniques qui rendent images et voix plus difficiles à cloner par des modèles génératifs non autorisés.
C’est dans cette logique que s’inscrit BeepFake, projet en recherche et développement mené au sein de l’Institut national de recherche en sciences et technologies du numérique (Inria, France), qui vise à protéger images, voix et vidéos avant leur diffusion, grâce à plusieurs mécanismes qui perturbent le clonage des traits de l’identité audiovisuelle (visage, voix). L’ambition : rendre le détournement plus difficile, renforcer la traçabilité et redonner aux personnes une capacité d’action.
Protéger le corps numérique, c’est garantir qu’aucun visage ne soit cloné, aucune voix échantillonnée, sans le consentement de la personne à laquelle ils appartiennent. Faire du consentement le point de départ, c’est faire de nos images et de nos voix le prolongement de nous-mêmes plutôt que l’instrument de notre dépossession.

Adela Barbulescu a reçu des financements de France 2030.
12.10.2026 à 15:48
Aliments et boissons : peut-on tout fermenter ?
Élodie Choque, Maitre de conférence en microbiologie, Université de Picardie Jules Verne (UPJV)
Texte intégral (1989 mots)
L’ESSENTIEL
La fermentation est de plus en plus tendance. Parmi les arguments apportés par ses promoteurs, on trouve notamment une plus grande digestibilité et une conservation accrue des aliments.
Il existe plusieurs types de fermentations, qui peuvent être combinés, comme c’est le cas pour le roquefort, le champagne et le pain au levain.
Cela signifie-t-il que tous les aliments peuvent être fermentés ? Peut-on manger trop d’aliments fermentés ?
Choucroute, yaourt, fromage, saucisson, vin ou bière sont les premiers aliments fermentés qui viennent à l’esprit. Mais c’est un monde beaucoup plus vaste qu’on ne le croit. En effet, le pain, la brioche, le chocolat, le café ou encore le poivre blanc peuvent aussi être considérés comme des aliments fermentés, et de nouveaux produits commencent à émerger sur le marché européen, comme le kéfir, le kombucha ou le kimchi. On estime que les aliments fermentés représentent en réalité entre 5 et 40 % de l’alimentation de chacun d’entre nous.
Si la fermentation alimentaire a d’abord été une méthode de conservation très prisée avant l’apparition de la réfrigération et a façonné l’histoire culinaire mondiale, elle connaît aujourd’hui un véritable engouement. En effet, il a été démontré que les aliments fermentés avaient un effet bénéfique sur le microbiote intestinal, car ils apportent des probiotiques (bactéries vivantes bénéfiques), des prébiotiques (des fibres végétales) et des postbiotiques (des acides gras à chaîne courte) qui ensemble renforcent le microbiote et la barrière intestinale.
Mais tous les aliments peuvent-ils être fermentés ? Consommer des aliments fermentés présente-t-il autant d’intérêt qu’on peut le lire sur le Net ?

Qu’est-ce que la fermentation ?
La fermentation est un mécanisme biologique au cours duquel des micro-organismes (bactéries, levures, moisissures) consomment les sucres et les protéines présents dans l’aliment et les transforment en acides organiques, en éthanol, en gaz, en peptides et en composés aromatiques.
On distingue quatre grands types de fermentation alimentaire.
La plus connue reste la fermentation alcoolique, pendant laquelle des levures transforment des sucres simples en alcool et en dioxyde de carbone donnant, donnant naissance au vin, à la bière, ou au cidre. Cette fermentation est aussi à l’origine de la panification : la production de dioxyde de carbone aère la mie et l’alcool s’évapore lors de la cuisson du produit.
Lors de la fermentation acétique, des bactéries transforment l’alcool en acide acétique, ce qui donne du vinaigre ou un kombucha. On parle de vinaigre de vin ou de vinaigre de cidre car une première fermentation alcoolique est nécessaire pour que la fermentation acétique puisse avoir lieu.
La fermentation fongique (aussi appelé fermentation enzymatique) résulte de l’action de champignons filamenteux qui utilisent leurs enzymes pour casser les sucres et les protéines de l’aliment. C’est le processus qui permet l’obtention de la sauce soja, du miso ou encore du tempeh, mais aussi de certains fromages comme le roquefort ou le camembert.
Enfin, dans la fermentation lactique, des bactéries vont transformer des sucres simples en acide lactique et en gaz, en acide organique et parfois en alcool. C’est le processus qui permet l’obtention des yaourts, des fromages, de la choucroute, du kimchi ou encore de certaines viandes pour l’obtention du saucisson.
Certains aliments fermentés nécessitent la combinaison de deux fermentations. L’association d’une fermentation lactique et d’une fermentation fongique donnera la plupart des fromages et des saucissons. Le champagne, lui, résulte d’une double fermentation alcoolique, la première apporte l’alcool et la seconde apporte à la fois de l’alcool et des bulles de dioxyde de carbone lui conférant son côté pétillant. Le pain au levain, quant à lui, résulte lui de l’association d’une fermentation lactique et d’une fermentation alcoolique.
Des vertus santé, mais sans miracle
La fermentation alimentaire montre plusieurs avantages : (i) elle rallonge la durée de vie des aliments, (ii) elle améliore leurs qualités organoleptiques (telles que l’odeur, la texture ou le goût de l’aliment), (iii) elle réduit leur temps de cuisson.
La fermentation alimentaire peut être vue comme une « prédigestion » de l’aliment qui peut faciliter leur consommation. Les cornichons ou les olives, par exemple, sont difficilement consommables s’ils ne sont pas fermentés au préalable. De même, les bactéries lactiques consomment le lactose du lait permettant aux personnes intolérantes au lactose de consommer certains produits à base de lait sans craindre de symptômes trop violents (kéfir, les fromages hautement fermentés comme le parmesan ou encore les yaourts).
Ainsi, les aliments fermentés apportent aussi des avantages nutritionnels et de santé, ce qui explique la nouvelle tendance de leur développement sur le marché depuis une décennie.
De la même manière, la fermentation alimentaire permet de diminuer la présence de FODMAPS (oligosaccharides, disaccharides, monosaccharides et polyols fermentescibles) dans les matières premières. Ces sucres complexes mal assimilés par l’intestin grêle fermentent dans le colon et sont la cause des douleurs intestinales liées au syndrome de l’intestin irritable.
La fermentation alimentaire permet de dégrader et neutraliser les anti-nutriments présents naturellement dans certains aliments, empêchent l’assimilation de certains nutriments et minéraux (fer, zinc, magnésium, calcium) par l’organisme par exemple l’acide phytique dans les céréales complètes et les légumineuses ou le cyanure dans le manioc.
Les aliments fermentés enrichissent le microbiote et vous apportent des vitamines et des antioxydants. En effet, lorsqu’ils sont non pasteurisés ou non cuits, ils vous apportent des milliards de bactéries vivantes (les probiotiques, qui ont réalisé la fermentation) importantes pour maintenir la diversité de votre microbiote. De plus, lors de la fermentation alimentaire, les micro-organismes se développent et produisent naturellement des vitamines (B et K) ainsi que des molécules antioxydantes qui sont aussi bénéfiques à votre organisme.
Attention toutefois : si les aliments fermentés s’intègrent parfaitement dans une alimentation saine et variée, ils ne constituent pas des « super-aliments » miracles, notamment pour vos maux d’estomac. En effet, contrairement aux probiotiques de pharmacie conçus pour résister à l’acidité gastrique, la plupart de leurs bactéries sont détruites dans l’estomac avant d’atteindre le côlon. De plus, la pasteurisation des produits du commerce élimine souvent une partie de ces micro-organismes vivants.
Autre inconvénient : certains aliments fermentés ont une forte teneur en sel (kimchi, miso, choucroute), celui-ci s’étant concentré lors de la fermentation. Enfin, la présence résiduelle de FODMAP peut même aggraver les ballonnements chez les personnes souffrant du syndrome de l’intestin irritable, qui doivent faire attention à leur consommation. Il convient donc de les consommer pour le plaisir, sans excès et sans les prendre pour des traitements médicaux.
Tous les aliments peuvent-ils être fermentés ?
Au sens pratique et culinaire, la réponse est presque tous.
La fermentation alimentaire est une alliée santé de premier ordre qui transforme la quasi-totalité de nos ingrédients bruts en trésors digestifs et nutritionnels.
En revanche, au sens biologique du terme, la réponse est non : en effet, certaines conditions doivent être réunies pour que les micro-organismes puissent réaliser la fermentation. Ainsi les matières premières trop grasses (comme l’huile), les matières premières déshydratées (comme les fruits secs comme les noix), les aliments trop sucrés (comme le miel), trop salés ou contenant des conservateurs (car déjà transformés) résisteront à l’action des micro-organismes.
Quant à moi, je vous recommande l’association pomme-betterave, si vous vouliez vous lancer dans l’aventure de la fermentation. C’est ma préférée !
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Élodie Choque a reçu des financements de la région Hauts-de-France (dynamique Economie Ciculaire et Nouveaux Modèles de Développement).
12.10.2026 à 15:47
Five ways to beat dating algorithms at their own game
Stefania Masè, Associate professor of marketing and communication, IPAG Business School
Alisa Minina Jeunemaître, Associate Professor of Marketing, EM Lyon Business School
Jamie Smith, Professor of Marketing, Escola de Administração de Empresas de São Paulo da Fundação Getúlio Vargas (FGV/EAESP)
Texte intégral (1392 mots)
KEY TAKEAWAYS
Decide what you want before you start swiping. An app can suggest people to meet, but it cannot decide what kind of relationship matters to you.
Set limits on your time and attention. More profiles and more matches do not necessarily bring you closer to a meaningful connection.
Treat the app as an introduction, not the whole relationship. If you want to get to know someone, make room for conversation and, when you both feel comfortable, a meeting beyond the app.
You open a dating app intending to spend ten minutes on it. An hour later, you are still swiping. You might have a few new matches, but are you any closer to meeting someone you actually like? Arguably, one of the benefits of dating apps is that they make introductions possible on a scale that would once have been hard to imagine.
They can help people meet outside their usual circles and offer a less daunting way to signal interest. But their design also shapes what we do: profiles arrive one after another, choices take seconds, and there is always the possibility that the next person will be a better match.
In our research, we examined 21 interviews with dating app users alongside public online discussions and French newspaper coverage. We found that people navigate three coexisting, sometimes competing ideas about dating. The first one is the romantic approach to dating where it is important to take time, build trust and look for a connection. The second, the shopping approach, treats dating more like browsing where a person can compare options, filter efficiently and keep their choices open. The third, the systems approach follows the app’s own rhythm: swipe, match, respond to prompts and keep engaging, without necessarily thinking about the long-term goals.
Most people do not fit neatly into just one of these approaches. Someone may hope for a lasting relationship while filtering profiles like a careful shopper. Another may enjoy casual dating but resent feeling pushed to make endless quick decisions. That tension helps explain why using an app can feel both useful and exhausting.
So how can you ‘beat’ a dating algorithm?
Despite years of research dedicated to looking for determinants of online dating success, there is no proven secret combination of swipes, photos or messages that will make a platform deliver the right partner.
Ask yourself instead, how can you stop the app’s rhythm from setting the terms of your romantic life? Here’s how:
- Keep a clear picture of your intentions
Before opening the app, consider whether you want a committed relationship, casual dates or simply to meet people without deciding yet. Any of these is a valid aim. Knowing yours can help you choose whom to talk to and what to say. It can also make it easier to notice when you are following someone else’s expectations because it seems simpler than explaining your own. When a conversation starts to matter to you, share what you are looking for and ask what the other person wants, too. You need not settle everything immediately, but you should not have to guess indefinitely.
- Choose when to stop browsing
One participant in our study, Rose, imposed a swiping ban on herself so she could focus on a few people she was genuinely interested in. Her choice did not reveal a flaw in the app’s code. It changed how she used the app. If you find yourself collecting matches without talking to them, try pausing new searches long enough to give existing conversations your attention.
- Use filters and profiles as tools, not verdicts
Some people in our study carefully shaped their profiles, used several apps or filtered matches to save time. These tactics can be useful, particularly when they reflect what you genuinely value. But a profile offers only a partial view of a person. A match is a reason to begin a conversation, not evidence that a relationship will work. Critically, a lack of matches is not a measure of your worth. Research shows that low match rates on dating apps may lead to negative mental health outcomes because the apps create a false equivalence between algorithmic compatibility and personal worth.
- Take promising connections beyond the swipe cycle
Participants seeking closeness often wanted more than an exchange of quick reactions. Some moved conversations off the app or made plans to meet, rather than continuing to browse indefinitely. You can do this at a pace that feels comfortable to both people. The point is to give a connection a chance to develop in a setting where the next profile is not constantly competing for attention.
The importance of psychological sovereignty
Finally, give yourself permission to leave.
One participant in our study, Alan, deleted an app when dating began to feel like a game, though he sometimes returned later. Taking a break need not mean giving up on meeting someone. It can be a way to check whether the app is still helping you pursue what you want. We call this reclaiming psychological sovereignty. Put plainly, it means keeping hold of your ability to decide what matters to you, how much attention you give the app and when you have had enough. You cannot control who appears on your screen or how the platform ranks profiles, but you can decide what you do next.
Dating apps can open doors, but it is important to remember that you are the one who is in control. You get to choose whether to walk through this door, keep looking, or put your phone away, and no algorithm can make this decision for you.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
12.10.2026 à 15:05
« Vous pouvez nous prendre le téléphone, mais pas la parole » : le mouvement lycéen et le sentiment de ne pas être écouté
Annabelle Allouch, Maîtresse de conférences en sociologie, Université de Picardie Jules Verne (UPJV)
Katharine Throssell, Docteure en science politique, Marie Sklodowska Curie Fellow, Université catholique de Louvain (UCLouvain); Sciences Po Bordeaux
Texte intégral (1442 mots)
L’ESSENTIEL
Le mouvement lycéen entame sa quatrième semaine d’action, avec une grande manifestation prévue mardi 13 octobre.
Parmi les jeunes mobilisés, beaucoup se plaignent de ne pas être écoutés par l’école et les institutions.
Le dispositif d’orientation dans l’enseignement supérieur, Parcoursup, cristallise le sentiment d’incompréhension.
Une chose frappe à la lecture des pancartes des mobilisations lycéennes de ces dernières semaines : au même titre que de voir leurs enseignants remplacés et de ne pas pâtir de plafonds qui tombent dans les classes, les lycéens demandent à être entendus. Comme ils le disent, ils se considèrent « non pas mal éduqués mais mal écoutés ».
Cette revendication exprime le décalage entre les multiples sources de stress qu’ils expriment (manque de professeurs et d’investissements, et insécurité face à l’avenir) et les réponses jugées inadaptées du gouvernement.
La centralité de l’enjeu de l’écoute est d’ailleurs perceptible dans la plateforme de doléances mise en ligne par le ministère (qui ne manque pas d’évoquer les cahiers proposés aux gilets jaunes) ; ainsi que par le temps « banalisé » d’écoute dans l’établissement.
Une socialisation politique par la manifestation
Les travaux d’Annick Percheron sur la socialisation politique ont mis en évidence l’existence d’une double lecture du rapport des jeunes à la politique : d’un côté, les jeunes incarnent une innocence fantasmée et, par définition, apolitique ; de l’autre, leur politisation s’associe souvent pour les acteurs publics à un nécessaire recadrage.
Ce paradoxe est parfaitement illustré par la violence de la répression de la police, et par l’un des mots d’ordre du mouvement :
« Trop jeunes pour être écoutés, mais assez grands pour se faire gazer. »
Les travaux dans ce domaine ont, par ailleurs, montré l’impact personnel et politique de l’engagement précoce dans des mouvements sociaux (par exemple, Mai-68).
La prolifération des slogans qui renvoient à cet héritage (« La génération 6/7 refait Mai-68 ») souligne à quel point ces évènements peuvent produire des récits culturels et intergénérationnels, qui contribueront à une socialisation au politique au-delà des participants eux-mêmes.
À partir de nos enquêtes respectives sur les enfants de 10 ans à 17 ans face aux crises contemporaines pour l’une et sur les pratiques politiques des lycéens et des étudiants avant et après Parcoursup pour l’autre, nous postulons que le rapport à la citoyenneté des jeunes sera affecté par deux éléments concomitants : l’expérience de ne pouvoir exprimer sa frustration dans des espaces légitimés par l’institution, qu’elle soit politique ou scolaire, et celle du sentiment de ne pas être écouté par le pouvoir politique.
Les formes de la non-écoute
Dans le cadre d’une enquête sur le rapport des adolescents aux crises contemporaines et à la démocratie, nous avons mené des entretiens avant et pendant le mouvement lycéen, auprès de manifestants et de non-manifestants.
Avant le mouvement, le sentiment de ne pas être écouté renvoyait surtout à l’institution scolaire : manque d’opportunité de débats, superficialité des instances dites de « démocratie » scolaire, etc.
Dans les entretiens récents, cette non-écoute rejaillit sur d’autres institutions, notamment la police, dont la violence constitue pour certains le révélateur de la relation asymétrique qu’ils entretiennent avec le pouvoir :« Dès qu’on s’exprime, on se fait réprimer dans la violence », explique une manifestante de 16 ans (issue d’une famille politisée). On s’insurge aussi contre les propos de certains politiques sur ce point, « “Les jeunes n’ont qu’à s’asseoir et se taire” – ça m’a révoltée ! », note une manifestante de 17 ans (venant d’une famille peu politisée).
Plus largement, cette critique renvoie à l’idée que « normalement l’État est censé écouter directement le peuple » (fille, 17 ans, famille peu politisée) et au sentiment que le voir « dériver, c’est inquiétant pour la démocratie… ça m’a rappelé ce qu’on voit en cours d’histoire » (garçon, 17 ans, famille peu politisée).
Même chez les non-manifestants, voir leurs pairs se faire gazer politise ce constat de non-écoute. Ainsi, ces manifestations semblent nourrir l’appréciation d’un écart entre une idée abstraite d’État démocratique et la réalité constatée : ce qui constitue un apprentissage politique, que l’on soit sur le blocus ou non.
Sur Parcoursup : la sourde oreille
Dans le cadre de notre enquête sur Parcoursup avec Delphine Espagno-Abadie, nous avons identifié un processus qui illustre particulièrement bien la résurgence du sentiment de non-écoute.
La réforme Orientation et réussite des étudiants (ORE) de 2018 (qui crée la plateforme Parcoursup) entraîne non seulement la multiplication des épreuves, mais aussi la reconfiguration des espaces de discussion du jugement scolaire. Cela génère une angoisse qui s’ajoute à la distance créée par la dématérialisation de l’accès dans le supérieur.
Cette mise à distance des lycéens s’incarne par des formes faibles d’explication du jugement scolaire, particulièrement réduites et standardisées en cas de refus. C’est le cas de la mention fréquente « Le niveau scolaire (ou la motivation) apparaît insuffisant pour la formation, au regard de celui d’autres candidats »). Mais comment reconnaître la légitimité d’un jugement aussi succinct ?
Les numéros verts gérés par les rectorats ne proposent pas non plus d’explicitation au jugement des formations, mais des solutions de compensation. Il s’agit moins d’écouter les plaintes des élèves que de les conserver dans les canaux de la plateforme pendant les différentes phases. Alors que la réforme devait valoriser le choix personnel et authentique du lycéen éclairé par un travail d’orientation au long cours, la faiblesse des espaces de négociation et d’écoute fait de Parcoursup un couperet, dont la sélectivité ne se justifie, par ailleurs, pas toujours par le prestige ou la rareté de la formation recherchée.
On voit alors comment un tel système peut non seulement entraîner un fort sentiment d’injustice (« Pourquoi suis-je mal classée dans une formation pour laquelle je suis motivée ? ») qui va nourrir les formes de contestation « à bas bruit » (la plainte sur les terrasses des cafés ou dans les repas de famille) comme les luttes ouvertes dans la rue, ainsi que nous le montre le mouvement actuel.
L’importance de la demande d’écoute dans les revendications lycéennes nous fournit ainsi une illustration des travaux de Laurent Lardeux et de Vincent Tiberj pour qui les revendications des jeunes sont les « révélateurs des apories de nos démocraties ». Elle nous montre aussi à quel point les apories de la démocratie sont aussi la fondation d’une socialisation politique. Comme dit une pancarte : « Si on ne nous écoute pas, on crie. »

Katharine Throssell a reçu des financements européens pour cette recherche en tant que Marie Sklodowska Curie Fellow.
Annabelle Allouch ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
12.10.2026 à 12:53
Raphaël Glucksmann désigné par les sociaux-démocrates : pourquoi les primaires ne sont pas forcément des machines à perdre
Pierre Bréchon, Professeur émérite de science politique, Sciences Po Grenoble, Auteurs historiques The Conversation France
Texte intégral (1422 mots)
L’ESSENTIEL
Raphaël Glucksmann a largement remporté la primaire réunissant les candidats de la gauche sociale-démocrate (Parti socialiste, Place publique, Gauche républicaine et socialiste).
Parfois présentées comme une « machine à perdre », les primaires ont de nombreuses vertus : sélection des candidats, médiatisation, choix démocratique.
Distancé dans les sondages par Jean-Luc Mélenchon, Édouard Philippe et Marine Le Pen, Raphaël Glucksmann bénéficiera-t-il d’une nouvelle dynamique ?
L’organisation de primaires pour sélectionner un candidat à la présidentielle est relativement récente. Elle permet de limiter le nombre de candidats de la même tendance et donc faciliter la sélection de l’un des prétendants du même segment de l’électorat pour le tour décisif. Cette procédure est apparemment vertueuse parce qu’elle évite que se renouvelle ce qui était arrivé à Lionel Jospin au premier tour présidentiel de 2002, éliminé de peu par la multiplicité des candidatures de gauche. Elle assure une large publicité – avec un ou plusieurs débats télévisés entre les prétendants – pour faire connaître les orientations d’une tendance. Elle peut être aussi considérée comme un outil de participation démocratique puisqu’elle associe les adhérents dans une primaire interne ou même les simples sympathisants dans une primaire ouverte alors qu’autrefois le candidat était « auto-sélectionné » ou désigné par les instances des partis. Accessoirement elle peut dégager des bénéfices pour le ou les partis organisateurs, lorsque les votants doivent payer leur inscription.
Mais la primaire n’a pas toujours bonne presse. Elle est souvent présentée par ses détracteurs comme une « machine à perdre », car le débat public de la primaire met en évidence les divisions d’un camp, ce qui peut être un handicap pour le tour décisif. Elle est aussi rejetée pour des raisons idéologiques par ceux qui estiment que l’élection présidentielle doit être « la rencontre d’un candidat avec son peuple ».
La première primaire – interne aux adhérents – fut organisée fin 2006 par le Parti socialiste (PS). Celui-ci avait adopté peu avant une modification du tarif de l’adhésion (seulement 20 euros), ce qui avait fait adhérer environ 100 000 personnes, doublant ainsi le nombre d’adhérents au PS. Face à Laurent Fabius et à Dominique Strauss-Kahn, Ségolène Royal avait acquis une aura importante, lui permettant de l’emporter. Cela avait été un atout pour sa campagne présidentielle, et on ne peut pas affirmer que c’est la mise en évidence des divisons entre candidats lors de la primaire qui lui aurait fait perdre l’élection présidentielle (avec 46,9 % au second tour, face à Nicolas Sarkozy).
Fin 2011, les socialistes innovent avec une primaire ouverte aux sympathisants du PS et des radicaux de gauche. C’est un succès de participation : 2,7 millions de votants au premier tour et près de 2,9 millions au second. Là aussi, la primaire aura été un tremplin important pour la victoire de François Hollande à la présidentielle. Au même moment, les écologistes ont organisé une primaire interne (33 000 inscrits). Le Parti communiste français (PCF) avait aussi organisé un vote de ses adhérents pour choisir entre un soutien à Jean-Luc Mélenchon (Parti de gauche) et la désignation d’André Chassaigne (député communiste du Puy-de-Dôme).
Une nouvelle primaire socialiste, organisée tardivement en janvier 2017, réunit environ 2 millions de votants dans un contexte de grande division du parti entre les soutiens du président Hollande et les « frondeurs ». C’est un frondeur, Benoît Hamon, qui sort des urnes. La primaire l’a beaucoup fait monter dans les sondages présidentiels, mais il régresse au fil de la campagne et finit à 6,4 %. Une primaire écologiste a aussi lieu, mais l’élue se retirera de la présidentielle au vu de ses faibles scores dans les sondages.
Pour la même élection présidentielle, la droite et le centre décident également de sélectionner leur candidat dans une primaire ouverte. C’est un grand succès populaire : 4,4 millions de votes au second tour. François Fillon crée la surprise : il est élu avec 66,5 % des voix alors que Nicolas Sarkozy et Alain Juppé, qui passaient pour les favoris, ont été éliminés. C’est probablement une caractéristique des primaires – surtout ouvertes – de faire mentir les pronostics journalistiques. À la sortie de ces primaires, François Fillon semblait avoir de bonnes chances de devenir le prochain président de la République. Mais la révélation d’une « affaire » portant sur l’emploi fictif de son épouse, suivie d’une mise en examen en mars 2017 pour détournement de fonds publics, lui font perdre plusieurs points dans les sondages. Son élimination au premier tour de l’élection présidentielle n’est pas due à la primaire, mais bien aux conséquences de sa mise en accusation.
En 2022, alors que la droite a perdu beaucoup d’électeurs depuis 2017, Les Républicains (LR) décident – après avoir tenté de désigner leur candidat en fonction des résultats des sondages – d’organiser une primaire limitée aux adhérents (près de 149 000 personnes à la veille du scrutin). Valérie Pécresse en sort vainqueur, mais cela ne lance pas une dynamique de campagne, vu le caractère limité de cette primaire interne. La même histoire se déroule au PS, avec une primaire interne (seulement 22 150 votants, du fait du fort déclin du parti) gagnée par Anne Hidalgo. Les écologistes ont aussi organisé une primaire ouverte (près de 123 000 inscrits). Ces primaires de 2022 ne peuvent, pour autant, être considérées comme des « machines à perdre » : elles montrent surtout la faiblesse des forces politiques concernées.
Pour l’élection présidentielle de 2027, une première primaire vient d’être remportée dès le premier tour par Raphaël Glucksmann, avec 66,2 % des suffrages, loin derrière les autres candidats (Olivier Faure devant se contenter de 14,5 %). C’est l’indication du rejet de l’union avec Jean-Luc Mélenchon et La France insoumise (LFI) par la gauche sociale-démocrate. C’est aussi l’illustration de la méfiance d’une large partie de l’opinion pour les profils partisans. C’est probablement enfin la marque d’un « vote utile » en faveur du candidat de gauche non mélenchoniste qui semble le mieux placé en vue de la présidentielle.
Finalement, nombre des primaires évoquées ont créé une dynamique importante pour les candidats en position de l’emporter à la présidentielle. Une nouvelle étape commence donc pour Raphaël Glucksmann qui était plutôt ce dernier mois à la baisse dans les sondages, passant de 11,5 % à 9,6 % entre début septembre et le 12 octobre.
Il faudra observer les prochains sondages pour voir si les résultats de la primaire lui permettent de progresser de façon significative. Il est, pour l’instant, largement dominé par Marine Le Pen (23,8 %), Jean-Luc Mélenchon (16,6 %) et Édouard Philippe (16 %). Le fossé est large pour espérer une qualification de Raphaël Glucksmann en vue du second tour. Mais toutes les élections présidentielles réservent des surprises qui peuvent redistribuer les cartes !

Pierre Bréchon ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
12.10.2026 à 10:40
Les artistes ne rendent pas les salariés créatifs : ils les autorisent à le redevenir
Pierre Poinsignon, Enseignant-chercheur, Burgundy School of Business
Sophie Reboud, Professeur, Chercheur en management des PME et innovation, Burgundy School of Business
Thomas Blonski, Professeur assistant en stratégie et entrepreneuriat, ICN Business School
Texte intégral (1754 mots)
L’ESSENTIEL
Résidences, ateliers, séminaires : les entreprises font de plus en plus appel à des artistes pour stimuler la créativité de leurs équipes.
La créativité ne se transmet pas comme une méthode. Mieux vaut en être conscient avant de se lancer.
Ces rencontres fonctionnent surtout lorsqu’un intermédiaire construit un espace où les salariés se sentent autorisés à créer.
« Qu’importe leur valeur ? La muse est toujours belle… »
– Alfred de Musset.
Depuis une vingtaine d’années, les résidences d’artistes, les ateliers de création et les séminaires artistiques se multiplient dans les organisations, ce que la recherche n’a pas manqué d’observer, à l’instar de Schiuma, de Taylor & Ladkin, ou plus récemment dans un ouvrage qui leur est consacré. Un plasticien vient travailler dans une usine, un metteur en scène anime un comité de direction, un musicien accompagne une équipe de recherche. L’objectif affiché est presque toujours le même : développer la créativité des salariés.
L’idée paraît aller de soi. Après tout, qui, mieux qu’un artiste, pourrait apprendre à être créatif ? Pourtant, cette intuition est loin de faire consensus dans la recherche. Artistes et managers ne poursuivent pas les mêmes objectifs, ne travaillent pas sous les mêmes contraintes et ne donnent pas le même sens au mot « créativité », ce qui a été synthétisé par Ancelin Bourguignon, Dorsett et Azambuja. Dès lors, comment une compétence développée dans un atelier pourrait-elle être transférée dans une entreprise ?
Deux créativités qui s’ignorent
C’est cette question que nous explorons dans notre article « Les conditions de l’interstice créatif. Comment la médiation des interventions artistiques en organisation active et légitime la créativité » (à paraître). Notre enquête repose sur 25 entretiens avec 11 dirigeants ou managers, 10 intermédiaires et 4 artistes impliqués dans ces projets. Le résultat est plus surprenant qu’il n’y paraît : les salariés n’apprennent pas la créativité des artistes. Ils retrouvent plutôt une créativité qu’ils avaient progressivement cessé d’utiliser.
À lire aussi : Comment se servir de l'art pour former au management ?
Dans l’entreprise, une idée est généralement considérée comme créative si elle est à la fois nouvelle et adaptée à un problème. Or, la création artistique obéit à d’autres critères : elle peut rester incertaine, refuser l’utilité immédiate et n’être reconnue que longtemps après sa production.
Imaginer un simple transfert revient donc à considérer la créativité comme un paquet que l’artiste apporterait dans l’entreprise. Il lui suffirait de montrer sa méthode pour que les salariés la reproduisent. Or, les pratiques observées ne suivent pas ce scénario.
Sortir des routines
Les managers veulent que leurs équipes sortent de leurs routines, mais comprennent mal le prix, le temps ou l’incertitude du travail artistique. Les artistes y trouvent des matériaux, des moyens et de nouveaux terrains d’exploration, mais craignent d’être réduits à un outil de management. Quant aux participants, rarement à l’origine du projet, ils peuvent se demander pourquoi le budget de l’opération n’a pas été versé sous forme de prime.
Un retour vers les coquilles Saint-Jacques étudiées par le sociologue Michel Callon s’impose : il avait observé dans les années 1970 trois chercheurs qui tentaient d’enrayer la raréfaction de l’espèce en baie de Saint-Brieuc (Côtes-d’Armor). Appelant pêcheurs et collègues, et fixant les larves sur des collecteurs, ils ont réuni des acteurs qui ne partageaient pas les mêmes objectifs et qui ne parlaient pas la même « langue ». Callon nomme cet alignement « traduction » : formuler un problème commun et construire un point de passage partagé.
Le médiateur, un « mur absorbant »
Dans les interventions artistiques, ce rôle de traducteur revient à ce que nous appelons un intermédiaire : consultants, associations ou structures spécialisées. Ils écoutent la demande souvent vague de l’entreprise, choisissent un artiste, imaginent un format compatible avec sa pratique, puis ajustent le projet à mesure qu’il avance.
Ils expliquent à l’entreprise pourquoi une démarche artistique ne livre pas un résultat entièrement prévisible et aident l’artiste à comprendre ses contraintes. L’un des intermédiaires interrogés compare sa fonction à celle d’un « mur absorbant » : il reçoit les critiques d’un côté, puis n’en laisse passer que quelques gouttes de l’autre.
Surtout, les intermédiaires déplacent les obstacles particuliers vers une épreuve commune. Au lieu de demander aux salariés d’« être créatifs », ils leur proposent de réaliser une œuvre, une performance ou un objet avec l’artiste. Ce projet devient un « point de passage obligé ». Chacun y contribue pour ses propres raisons.
Une parenthèse où l’on peut essayer
Trois mécanismes se combinent alors. Le premier est l’apprentissage par la pratique. Les participants ne regardent pas l’artiste créer : ils manipulent, proposent, testent et recommencent. La créativité devient une expérience avant de devenir un discours.
Le deuxième tient à la présence de l’artiste. Sans fournir de recettes, il montre qu’il est possible d’avancer sans connaître le résultat, de traiter l’erreur comme une piste et de rendre visible une idée imparfaite. Il fonctionne moins comme un professeur que comme un modèle provisoire d’autorisation.
Le troisième mécanisme est temporel. L’intervention ouvre une parenthèse à distance des urgences, des procédures et de l’évaluation habituelle. Pendant quelques heures ou quelques jours, les participants peuvent suspendre leur autocensure et prendre un risque limité.
Cette combinaison crée un « interstice » (au sens de Berthoin Antal et Strauβ) : un espace protégé, entre le monde de l’art et celui de l’entreprise, où les règles ordinaires sont momentanément assouplies. La créativité n’y est pas importée. Elle y devient à nouveau praticable et légitime.
Pour autant, la présence d’un artiste ne constitue pas une formule magique. Sans soutien visible de la direction, sans temps réellement libéré ou sans médiation, l’intervention peut rester un événement sympathique, voire susciter du rejet. L’interstice doit être construit, puis protégé.
Notre enquête ne permet pas non plus d’affirmer qu’une expérience ponctuelle transforme durablement la culture d’une organisation. Elle peut constituer une première étape vers l’innovation, à condition que le droit d’essayer, de proposer et de se tromper survive au retour dans le travail quotidien.
La créativité est peut-être déjà là
Ce résultat conduit à déplacer la question. Depuis plusieurs années, les entreprises cherchent comment rendre leurs salariés plus créatifs. Elles multiplient les formations, les méthodes de design thinking ou les collaborations avec des artistes. Notre enquête invite à poser une autre question : et si les salariés étaient déjà créatifs ?
Le véritable enjeu serait alors moins de leur enseigner la créativité que d’identifier les mécanismes qui, au quotidien, l’inhibent progressivement, la peur de l’erreur, les routines, les contraintes de temps, les rapports hiérarchiques ou encore l’autocensure.
Sous cet angle, les interventions artistiques n’apparaissent plus comme un transfert de compétences entre deux mondes. Elles constituent surtout un révélateur. Elles montrent que la créativité dépend peut-être moins des individus que des environnements dans lesquels ils évoluent. Et c’est sans doute là que réside leur principal enseignement : avant de chercher des salariés plus créatifs, les organisations gagneraient peut-être à construire des situations où chacun se sent réellement autorisé à le (re)devenir.
Alors, les vers de Musset, dans Namouna (1832), prennent une résonance nouvelle. Si « la muse est toujours belle, même pour l’insensé, même pour l’impuissant », c’est que la création n’est pas réservée à quelques êtres d’exception. Dans l’organisation, l’artiste ne descend pas du ciel pour transmettre un don qui lui appartiendrait : il ouvre un passage par lequel chacun peut retrouver ses propres capacités créatives. Encore faut-il que l’organisation permette à ses salariés de l’emprunter…
« Qu’importe leur valeur ? La muse est toujours belle,
Même pour l’insensé, même pour l’impuissant ;
Car sa beauté pour nous, c’est notre amour pour elle.
Mordez et croassez, corbeaux, battez de l’aile.
Le poète est au ciel ; et lorsqu’en vous poussant
Il vous y fait monter, c’est qu’il en redescend. »

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
12.10.2026 à 10:40
Voici pourquoi les animaux influenceurs vous font dépenser plus d’argent sur les réseaux sociaux que les humains
Dr Laura Lavertu, Professeur Associé, GEM
Texte intégral (1667 mots)
L’ESSENTIEL
Près d’un propriétaire d’animal de compagnie sur trois a créé un compte consacré à ce dernier sur les réseaux sociaux.
Quelques-uns de ces comptes rassemblent des milliers d’abonnés, et chats ou chiens, véritables stars d’Internet, deviennent des « petfluenceurs ».
Une nouvelle étude scientifique révèle que certains animaux sont de meilleurs vendeurs que les humains sur les réseaux ; ils inspirent une sincérité que ces derniers peinent à égaler.
Doug The Pug, un carlin star des réseaux sociaux, fait la promotion de l’assistant vocal intelligent Alexa d’Amazon, et tout ça sans dire un mot. Nala the Cat, avec plus de 4 millions d’abonnés, multiplie les contrats avec de grandes enseignes et pèserait plusieurs millions de dollars grâce à ses partenariats et à sa propre gamme de nourriture pour chats.
Les animaux de compagnie ne se contentent plus d’être nos fidèles compagnons : ils sont devenus de véritables créateurs de contenu. Sur Instagram, sur TikTok et d’autres réseaux sociaux, nombreux sont les comptes dont les animaux sont les célébrités. Ces animaux influenceurs, aussi appelés « petfluenceurs », semblent au premier abord relever de la simple distraction et du passe-temps.
Avec près de 3,5 millions de comptes actifs dans le monde, le phénomène des petfluenceurs est en pleine expansion. Loin du simple animal de compagnie apparaissant de temps à autre sur le profil de son propriétaire, il s’agit d’influenceurs à part entière : tout comme leurs homologues humains, ces animaux de compagnie disposent de leur propre compte, d’une communauté fidèle et peuvent être rémunérés pour promouvoir des marques.
Cela n’a pas échappé aux marques qui font de plus en plus souvent appel à ces nouveaux créateurs de contenu à quatre pattes. Plus surprenant encore, des marques de tout bord, de l’automobile à la mode, et même jusqu’à l’alcool, s’arrachent ces influenceurs redoutablement efficaces.
Pourquoi choisir un petfluenceur plutôt qu’un humain, surtout lorsque le produit ne leur est pas destiné ?
Animaux plus vendeurs que les humains
Ces petfluenceurs sont-ils aussi efficaces que les influenceurs humains traditionnels ? Une étude démontre que choisir un petfluenceur plutôt qu’un influenceur humain peut être le pari gagnant.
Prenez une même publicité, diffusée sur Instagram pour la même bouteille de vin. Dans une version, un chat en fait la promotion ; dans l’autre, une influenceuse humaine. Résultat : les consommateurs exposés à la version féline se disent prêts à payer jusqu’à 43 % de plus pour le produit.
Sincérité difficile à trouver chez les humains
Pour expliquer pourquoi un animal est plus efficace qu’un humain pour vendre, il faut se pencher sur l’apparente sincérité que l’on attribue aux animaux, plutôt que sur la nouveauté du format, la beauté de l’influenceur ou sa crédibilité.
Rien d’étonnant à l’heure où la confiance envers les influenceurs s’érode. Selon une étude, 81 % des 20-35 ans disent avoir déjà douté de la véracité d’un contenu d’influence. Cette méfiance risque de prendre de l’ampleur avec la montée de l’intelligence artificielle générative, qui rend d’autant plus difficile la distinction entre les vraies et les fausses informations.
Au cœur de cette course à l’authenticité, que les influenceurs humains commencent à perdre, les petfluenceurs gagnent du terrain.
Contrairement aux influenceurs humains, que l’on soupçonne souvent d’être motivés par l’argent ou par la célébrité, les animaux semblent échapper à ces perceptions négatives dans l’esprit des consommateurs. Que l’on soit propriétaire d’un animal ou pas, on ne lui prête ni mauvaises intentions, ni agenda personnel, ni matérialisme.
Cette sincérité innée se révèle être un atout de taille dans le monde du marketing d’influence.
Angle mort réglementaire
En France, la loi du 9 juin 2023 encadre les pratiques commerciales des influenceurs, avec notamment une obligation de transparence sur les partenariats rémunérés ainsi qu’une liste de produits et services ne pouvant pas être mis en avant.
Comme ce texte a été pensé pour des créateurs humains de contenu, une question demeure : qu’en est-il des comptes tenus au nom d’un animal ? Bien que gérés par les propriétaires, nombreux sont les comptes de petfluenceurs ne faisant pas preuve de transparence sur la nature commerciale de leur contenu. Même un simple paquet de croquettes reçu gratuitement est considéré comme une contrepartie ; il devrait faire l’objet d’une indication d’intention commerciale.
À lire aussi : Quand votre chien s’habille en Prada… Les marques de luxe surfent sur votre affect pour vous vendre leurs produits
Au Royaume-Uni, l’organisme d’autorégulation de la publicité (Advertising Standards Authority, ASA) a déjà publié une liste de règles à respecter par les petfluenceurs, ou plutôt pour les propriétaires derrière ces comptes :
être transparent sur la nature commerciale du partenariat, même lorsqu’il s’agit de simples produits offerts ou d’invitations. Cela implique une mention claire, lisible et identifiable telle que « Publicité » ou « Collaboration commerciale » ;
au-delà de l’obligation de vérifier que le produit peut être légalement promu en ligne, les propriétaires doivent s’assurer qu’il n’est pas potentiellement dangereux pour les animaux. Par exemple, mettre en avant du chocolat sur un compte petfluenceurs dont le chien est la vedette peut laisser penser que les canidés peuvent consommer ce genre de produits, ce qui n’est pas le cas ;
être responsable. Cela implique notamment de ne pas mettre en scène son animal dans des situations potentiellement dangereuses ou irresponsables, comportements qui pourraient être émulés par d’autres propriétaires d’animaux.
Le bien-être animal, grand absent du débat
L’essor des petfluenceurs interroge les conditions dans lesquelles ces animaux sont sollicités. Même si pour beaucoup, ces comptes représentent une opportunité de partager l’amour que les animaux nous apportent de manière sincère, ce n’est malheureusement pas toujours le cas.
Tournages répétés, mises en scène pour capter l’attention, exposition constante aux flashs et aux foules sont autant de contraintes qui peuvent peser sur les animaux. Ne l’oublions pas, ils n’ont jamais consenti à devenir des supports publicitaires.
Un récent scandale a attiré l’attention du grand public. Un influenceur français ayant reconnu avoir orchestré le faux kidnapping de son chien en ligne a mis en lumière l’utilisation des animaux comme levier d’audience et de contenu, mais surtout sur ses dérives. Des associations animales ont porté plainte. Elles ont rappelé la banalisation de comportements irresponsables aux dépens des animaux et l’absence de régulation spécifique.
Le futur du marketing d’influence ?
Si la loi de 2023 a été pensée pour protéger les consommateurs de la publicité déguisée par des humains, elle ne protège pas de la publicité déguisée sous du contenu mettant en avant des animaux et ne protège pas les animaux eux-mêmes. Pourtant, il faut rappeler que les petfluenceurs faisant fortune sont rares, et beaucoup ne reçoivent que quelques produits gratuits de manière occasionnelle. La création d’un compte doit donc d’abord découler d’un désir sincère de partage plutôt que d’un attrait uniquement financier.
Un petfluenceurs efficace est surtout un animal heureux dont les propriétaires prennent soin et dont le contenu reflète le quotidien réel et léger, mais surtout responsable.
Avec l’arrivée de l’intelligence artificielle et de nouveaux compagnons à quatre pattes virtuels (et donc fictifs), l’avenir des petfluenceurs est encore voué à évoluer. En attendant une régulation claire sur le sujet, les petfluenceurs continuent de divertir le public sur les réseaux sociaux et d’offrir à certains une opportunité de monétiser les nombreuses photos et vidéos de leurs compagnons. Un phénomène qui a du chien !

Dr Laura Lavertu ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
12.10.2026 à 10:39
Quand la chimie rencontre le marketing : l’art de vendre l’eau à prix d’or
Aurore Ingarao, Maitre de conférences en Marketing , Université d’Orléans
Jérôme Chancolon, Maître de conférences en Chimie spécialité Matériaux et Formulation, Université d’Orléans
Texte intégral (1742 mots)
L’ESSENTIEL
L’eau reste l’ingrédient majoritaire des produits cosmétiques, souvent à plus de 75 %.
À travers les termes comme aqua ou water, le marketing en vient à vous faire acheter de l’eau potable au prix de l’or.
L’obligation de publier la composition des ingrédients par l’Union européenne peut menacer une industrie florissante.
Surnommée « or bleu », l’eau représente une préoccupation mondiale. Alors que le gouvernement met en place 53 mesures pour la préserver, le marketing semble jouer avec l’eau. Dans le secteur agroalimentaire, pour vendre de l’eau, un produit fait fureur sur les réseaux : les gourdes Air Up.
Allant de 35 euros à 99 euros, elles exigent de renouveler régulièrement des achats de « pods », des capsules odorantes permettant de tromper le cerveau. Le consommateur pense qu’il boit de l’eau aromatisée alors que seul son odorat est mobilisé. L’industrie de la consommation en arrive à facturer une ressource quasi gratuite en produit à forte valeur ajoutée.
Il existe un autre secteur dans lequel le marketing est particulièrement présent et dans lequel l’eau se transforme en or : celui de la cosmétique. Le marché français de la beauté a dépassé 22 milliards d’euros en 2024 portant à 6,8 % l’augmentation annuelle du secteur.
De nombreux produits cosmétiques voient leurs formules composées d’environ 75 % d’eau se vendre jusqu’à 7 266 euros le litre. D’autres marques se vantent de proposer des produits sans eau ajoutée, et sans eau à l’utilisation, traduisant la tendance waterless, quand, pour d’autres encore, le composant « eau thermale » est mis en avant.
Bien que parfois pointés du doigt, des chercheurs défendent la cause des cosmétiques en soulignant la remise en cause d’une cosmétophobie. Si la tentation est grande d’opposer les « sciences dures » aux « sciences molles », qu’en est-il sur le terrain, lorsque marketing et chimie travaillent de concert ?
Pour analyser cette tendance, nous associons nos compétences, l’un en marketing et l’autre en chimie.
De l’eau aux cosmétiques
L’eau, élément le plus présent sur notre planète, connaît pour formule chimique H₂O, un atome d’oxygène central relié à deux atomes d’hydrogène.
En cosmétologie, la science qui étudie la conception, fabrication des produits cosmétiques, l’eau utilisée est bien souvent de l’eau du robinet, qu’elle soit purifiée ou non, contenant quelques milligrammes de minéraux naturels.
Les produits cosmétiques sont globalement un mélange d’une phase aqueuse, l’eau, et d’une phase huileuse qui sont, dans des conditions dites « normales », non miscibles afin de pouvoir les associer. Pour réaliser une émulsion stable, un ingrédient de la famille des tensioactifs est ajouté, qui permet de stabiliser l’ensemble sous forme de gouttelettes dispersées dans une phase continue.
L’eau, l’ingrédient majoritaire
La composition des produits cosmétiques est passée à la loupe. Depuis la directive 76/768/CEE de l’Union européenne qui oblige à faire figurer la liste complète des ingrédients entrant dans leur composition sur les emballages des produits cosmétiques, l’intérêt pour les produits cosmétiques est grandissant. Au-delà de la composition, c’est la qualité des produits ainsi que leurs origines, synthétiques, végétales, animales, qui est interrogée.
Les marques cosmétiques ne tarissent pas d’arguments concernant la composition de leur produit pour conduire le consommateur à l’achat. L’exemple des huiles sous toutes les formes en est une illustration parfaite. Les emballages des produits cosmétiques vantent leur pouvoir relipidant, anti-irritations, apaisant, émollient, etc. et n’ont pour ingrédient majoritaire que… de l’eau.
Ingrédient cosmétique
Si l’eau est à la base d’une majorité de produits cosmétiques, elle est utilisée principalement comme solvant. Pour ce faire, l’eau n’est jamais pure ; elle connaît différents traitements :
adoucie : eau allégée en calcium et magnésium, comme les sprays d’eau thermale ;
déionisée : eau ne contenant pas d’ions, mais pouvant contenir des composés organiques ou des bactéries, comme les fonds de teint liquides ;
désinfectée : eau ne contenant plus de composé organique, mais contenant des sels minéraux ou des ions, comme les lotions toniques ;
distillée : dans sa forme la plus pure, ne contient aucun ion, aucun sel minéral et aucun composé organique, comme les produits cosmétiques stériles postopératoires.
L’eau peut également être purifiée et stérilisée, conduisant l’eau à n’avoir plus aucune propriété spécifique. Elle devient un ingrédient « mort ».
L’International Nomenclature of Cosmetic Ingredients (INCI), qui décrit la nomenclature internationale des ingrédients cosmétiques, a été conçue en 1973 par la Cosmetic,Toiletry and Fragrance Association, une association états-unienne regroupant des fabricants de cosmétiques, et détermine la nomenclature obligatoire au dos des emballages.
L’eau ne s’affiche pas sous le terme familier d’eau, mais utilise les termes latin aqua ou anglais water, véhiculant une distance linguistique reflétant une référence médicale ou scientifique au produit.
Marketing de la chimie
À l’instar de certaines marques d’eau cosmétique, l’eau de La Roche-Posay se présente comme l’eau la plus riche en sélénium, substance pourtant interdite. Malgré une illégalité, certaines marques n’hésitent pas à en faire un argument commercial.
Les sérums, cas spécifiques des cosmétiques, n’échappent pas à la règle. Même si les discours commerciaux vantent ces produits comme beaucoup plus concentrés que pour les crèmes, l’eau demeure l’ingrédient principal.
À lire aussi : Shampoing solide : pourquoi est-il si difficile de changer une formule et nos habitudes ?
Typology, une marque de cosmétiques en vogue, qui a fait sa place sur le marché grâce aux réseaux sociaux, adopte une démarche pédagogique en expliquant la place de l’eau dans les cosmétiques :
« S’il existe bien un ingrédient présent dans la majorité des produits de soin, c’est bien l’eau ou encore “Aqua” voire “Water”, ses appellations officielles dans la Nomenclature internationale des ingrédients cosmétiques. »
L’entreprise développe une démarche d’autant plus intéressante qu’elle illustre ses explications, tel que le ferait un enseignant de chimie. La marque termine d’ailleurs ses explications avec un mémo « L’essentiel à retenir sur l’utilisation de l’eau en cosmétique ». La marque fait du marketing de la chimie pour expliquer le bien-fondé de sa composition chimique.
Mettre ou non l’eau en avant
Si le Code de l’environnement considère que l’eau fait partie du patrimoine commun de la nation, son utilisation dans différents secteurs interroge, de l’eau minérale en bouteille aux cosmétiques.
La question de l’eau en marketing n’est pas nouvelle, notamment lorsqu’il s’agit de l’eau en bouteille. Des marques très variées ont su s’imposer sur le marché : accessibles comme Cristalline, plus haut de gamme comme l’Eau de Cristallo Tributo a Modigliani qui détient le record de l’eau la plus chère au monde – 60 000 dollars états-uniens la bouteille de 750 ml.
Finalement, la question que l’on peut se poser est de savoir s’il faut mettre en avant l’eau pour rassurer le consommateur ou faire oublier que l’eau est le principal ingrédient. Il ne s’agit pas d’oublier que les prix se justifient par les aspects de recherche et développement déployés par les marques ou encore par la recherche des nouveaux ingrédients, souvent d’origine naturelle, donc parfois difficile à extraire.

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
11.10.2026 à 08:54
What is umami?
Loïc Briand, Biologiste moléculaire et spécialiste du goût, Directeur de Recherche et Directeur du CSGA, Inrae
Texte intégral (3082 mots)
Characterised at the beginning of the 20th century in Japan, umami literally means “delicious taste” or “tasty taste”. Umami flavour was accepted as one of the five basic tastes at the beginning of the 2000s, on the basis of its detection by the taste receptors present within the patches of tissue or papillae on our tongue. Umami’s distinctive, savoury flavour is mainly produced by certain amino acids that make up proteins, including glutamic acid or its salt form, glutamate (sodium).
Umami has a unique characteristic: a phenomenon of synergy. This means that the flavour of glutamate is drastically increased by certain compounds found in certain foods or ingredients such as bonito – a cousin of tuna – dried (katsuobushi) or yeast extracts.
A mysterious flavour in the West
Although many molecules can produce the umami taste, it is one of the most little known and difficult sensations to describe, mainly because of the rarity of compounds that possess a pure umami taste.
The umami taste can however be generated among foods that are far more widespread than you would imagine: this is the case for algae (kombu algae), mushrooms (shiitake, truffle…) and also as has long been the case with basic kitchen staples like cheese (Parmesan, mature Comté, for example), cured meats (salami, dried ham…), fresh fish (especially bonito, salmon), seafood (shrimp, crabs, scallops…) or simply… tomato juice.


Glutamate is the reference molecule mainly behind umami, although it gets its salty taste from the presence of sodium ions. In powder form it tastes like cooking broth or soy sauce if you disregard its strong, salty flavour. In many Asian countries, glutamate (where its flavour is well known) is used in cooking as an ingredient in its own right.
Westerners on the other hand, lack a reference compound so tend to refer to a broth-like taste or borrow soy sauce as a familiar umami food which despite its strong saltiness, produces a pronounced umami taste.
The History of how umami was discovered
The discovery of umami is a long story. In his book la Physiologie du goût, published in 1826, French gastronome Jean Anthelme Brillat-Savarin describes a specific taste associated with the water-soluble part of meat. In 1866, German chemist Karl Heinrich Ritthausen found and chemically identified glutamic acid by breaking down wheat gluten and separating out a new compound, noting that it is capable of generating a different flavour.


The umami flavour concept was then put forward in 1908 by Kikunae Ikeda. A professor of chemistry at the time at the Tokyo Imperial University, Ikeda isolated glutamate from dried seaweed and was the first to describe its unique taste properties, which sit apart from the other basic tastes (sweet, bitter, sour and salty), and giving the flavour a Japanese name, in her “mother tongue”.
In 1913, Professor Shintaro Kodama highlighted the synergy (or the ability to amplify) of glutamate with compounds derived from RNA degradation (“ribonucleotides” such as inosinate and guanylate).
But it wasn’t until the 21st century that the umami flavour receptor called TAS1R1/TAS1R3 was identified in human papillae in 2002. From then onwards the umami flavour was completely accepted as the fifth basic taste among the scientific community.
The physiological role of umami
Our sense of taste is a chemical detection system dedicated to assessing food’s nutrient content. Its physiological role is to guide our food choices.
Therefore, detecting sweet molecules allows us to identify energy-rich nutrients, which is why we are naturally drawn to sweet things.
It’s a different story for the bitter taste, which provides the basis for our aversions to certain foods, allowing us to avoid potentially toxic compounds that have an unpleasant taste.
Detecting saltiness is of primary importance for maintaining our electrolyte balance. It is essential for finding sodium in our environment, because our bodies constantly lose sodium through our bodily excretory and secretory processes (sweat and urine).
Finally, acidity is an indicator of fruit maturity or the presence of microbial contamination. Identifying acidity also helps protect the body against eating food that is highly acidic that could damage our teeth and skin tissue.
But what about umami? It is believed that the physiological role of this particular taste is to detect amino acids and reveal the presence of protein and molecule-rich foods, which are crucial for ensuring our body functions properly.
Umami in world cuisine
Ingredients rich in umami compounds were introduced into our diet in ancient times to improve cooking. Garum was a condiment used in Rome as early as the Etruscan period. This sauce, derived from the fermentation of the heads and intestines of pickled fish, was used in many dishes and is comparable to nuoc-mâm, a Vietnamese sauce made from fermented fish in brine, that’s almost inseparable from spring rolls. We can also compare garum to pissalat, a French sauce made from fish (mackerel, sardines and anchovies) that is macerated in salt.
Soy sauce is a condiment hailing from China, which was introduced in Japan and spread worldwide. It is obtained by fermenting soya beans mixed with roasted cereals, and salt water. Its umami taste is very intense, as is its saltiness!
Another less well-known example to mention is Worcestershire sauce, which is popular in the UK. Invented in 1837, it is made from molasses and malt vinegar containing anchovies, onions and various spices. Viandox based on soy sauce, yeast extract, and meat extract, launched in France at the beginning of the 1920s, also packs a strong dose of umami.
And last but not least, if there is one cuisine that has showcased this taste, it is Japanese cooking culture. Unlike French cuisine, which is built on layering elements and tastes, it seeks to refine the plate by extracting the quintessence of its most prized produce such as fish, seafood, and seaweed.
Umami is one of the first flavours for babies’ mouths
Glutamate, i.e. the salt of glutamic acid, is commonly used as a flavour enhancer in the food industry in the form of monosodium glutamate (E621). The most widely consumed food additive, it has a global production estimated at several billion tons.
Although glutamate is the focus of debate over the risk of over-consuming it, it should be remembered that it is the most concentrated, free amino acid in breast milk, where it is present at a concentration of 175 milligrams per litre. Since this concentration sits above the threshold of what humans can detect (120 milligrams per litre), umami taste is one of the first flavours babies are exposed to.
Umami is lost on giant pandas
Umami’s physiological role is to alert carnivores to the presence of essential proteins. For example, physiological studies into cat food preferences have shown that our feline companions are also very fond of amino acids.


However, genetic studies have shown that the giant panda is insensitive to the umami taste. But what makes pandas (aguesiac or who have lost their sense of taste) unable to detect umami? The giant panda belongs to the ursid family, of the carnivore order. Their diet (bamboo represents 99% of what they eat) sets them apart from their other animal cousins as they are vegetarian, which paradoxically, makes them strict herbivores.
As mentioned above, umami compounds are detected in the mouth by a single receptor consisting of two subunits (TAS1R1 and TAS1R3). However, a study of the genetic heritage of the giant panda’s genetic heritage has shown that the gene encoding one of the subunits is defective, leading to an inactive umami-like receptor. It is for this reason that giant pandas have no perception whatsoever of umami. It is thought that, during evolution, this gene was lost, simply because the selection pressure on this receptor was let go of, as the species’ survival did not depend on its ability to identify protein.
This article is published as part of the Fête de la science, an annual event in France honouring Science in all its forms (which runs until October 12, 2026) – A The Conversation France partner event. This new edition focuses on the theme “Saveurs Savantes”. Find all the events at Fetedelascience.fr.
A weekly e-mail in English featuring expertise from scholars and researchers. It provides an introduction to the diversity of research coming out of the continent and considers some of the key issues facing European countries. Get the newsletter!

Loïc Briand is the President ofthe European Chemoreception Research Organization (ECRO).
11.10.2026 à 08:53
La perte du « goût » est en réalité souvent une perte d’odorat
Thierry Thomas-Danguin, Directeur de recherche - Centre des sciences du goût et de l'alimentation (UMR CSGA), Inrae
Texte intégral (2360 mots)
L’ESSENTIEL
Notre système gustatif ne perçoit que cinq saveurs : le sucré, le salé, l’acide, l’amer et l’umami.
Les goûts que nous percevons résultent de l’intégration de ces informations avec celles issues de la détection de molécules odorantes par le nez, et de sensations « chimiques » provoquées par diverses molécules spécifiques.
Les véritables pertes sensorielles du goût, qui concernent les cinq saveurs, sont beaucoup moins fréquentes que les pertes olfactives.
Un café devenu presque indiscernable d’une tasse d’eau chaude, une pêche dont il ne reste que la douceur et la texture : c’est souvent ainsi que l’on se rend compte d’une « perte du goût ».
Tout le monde peut être concerné, temporairement ou durablement, que ce soit à la suite d’une infection, d’un traumatisme, de la prise de certains traitements, ou encore simplement en raison de l’avancée en âge.
Il faut pourtant savoir qu’il est très rare que ce que l’on appelle « perte du goût » en soit vraiment une, autrement dit que cette expression ne désigne qu’une incapacité à percevoir les saveurs. En réalité, le plus souvent, il s’agit d’une altération de l’odorat.
Pour comprendre pourquoi une même expression peut recouvrir plusieurs troubles sensoriels, il faut se pencher sur la façon dont fonctionne le système qui nous permet de percevoir, non pas uniquement les goûts, mais plutôt les « flaveurs ». Explications.
De la bouche au cerveau, où se construit la flaveur ?
Dans le langage courant, le mot « goût » désigne l’ensemble des sensations éprouvées lorsque nous mangeons. Cependant, pour les scientifiques, cette perception globale correspond en réalité à la « flaveur ».
Ce terme désigne le résultat de l’intégration de trois types principaux d’informations : les saveurs, les odeurs et les sensations « trigéminales ». Ces dernières sont transmises par le nerf trijumeau, un nerf crânien dont les terminaisons sensitives innervent notamment les muqueuses de la bouche et du nez.
Avant tout, rappelons que c’est le système gustatif, situé dans la sphère orale, qui permet de percevoir les saveurs : le sucré, le salé, l’acide, l’amer et l’umami. Les molécules responsables de ces saveurs, libérées par les aliments et dissoutes dans la salive, stimulent les bourgeons gustatifs localisés principalement sur la langue.
Qu’est-ce que l’umami ? Le terme japonais umami peut se traduire approximativement par « savoureux ». Il désigne notamment la saveur caractéristique du dashi, un bouillon traditionnel japonais préparé à partir d’algue kombu. Cette saveur est principalement liée au glutamate, un composé naturellement présent dans les tomates mûres, les champignons, les fromages affinés ou certains bouillons.
Mais alors, pourquoi les goûts que nous percevons ne se limitent-ils pas à ces cinq saveurs ? Parce que d’autres informations sont également collectées lorsque nous mangeons.
Ainsi, le nerf trijumeau est lui aussi activé par certaines molécules, notamment celles responsables des sensations, telles que le piquant du piment, la fraîcheur de la menthe. Ces perceptions relèvent de la « chemesthésie ». Ce terme désigne l’ensemble des sensations provoquées par l’action de certaines molécules sur les terminaisons sensitives du nerf trijumeau. La chemesthésie exprime donc une notion de « sensibilité chimique ». Elle comprend, par exemple, le piquant du piment, la fraîcheur de la menthe, le pétillant d’une boisson gazeuse ou la sensation brûlante de l’alcool.
Les aliments libèrent également des molécules odorantes, qui sont détectées dans le nez par le système olfactif. Ces molécules sont transportées par les flux d’air liés à la respiration et atteignent la partie supérieure de la cavité nasale, où elles activent des récepteurs portés par les neurones sensoriels olfactifs. Ces derniers transmettent ensuite l’information au bulbe olfactif, puis à différentes régions cérébrales.
Ce sont ces molécules odorantes qui contribuent largement à l’identité aromatique de ce que nous goûtons, qu’il s’agisse d’une pêche, d’un café ou du bouquet d’un vin. En effet, avant même qu’un aliment n’entre dans la bouche, certaines molécules volatiles atteignent la cavité nasale lorsque nous respirons son odeur. Cette première activation olfactive, qui se produit lorsque les molécules parviennent au nez via l’air ambiant inspiré, est dite « orthonasale ».
Pendant la mastication, d’autres molécules sont libérées dans la bouche, puis remontent vers le nez par l’arrière-gorge, où elles vont être détectées : on parle alors d’olfaction rétronasale. Celle-ci joue un rôle essentiel dans la perception des aliments.
Pourtant, lorsque nous attribuons au café que nous buvons son arôme torréfié, nous n’avons pas forcément conscience que cette information est détectée dans le nez : elle semble provenir de la bouche, comme les saveurs !
Ces trois sortes d’informations (gustatives, trigéminales et olfactives) sont transmises au cerveau par des voies nerveuses distinctes. Elles y sont ensuite traitées conjointement, dans différentes régions cérébrales. C’est ainsi que le cerveau construit la représentation d’une flaveur, et fait d’une perception multisensorielle une expérience cohérente.
Point intéressant à souligner : la flaveur peut être influencée par la texture, la température et la couleur des aliments, ainsi que – c’est plus surprenant – par certains sons.
Dans un dessert, une texture plus épaisse peut, par exemple, diminuer la perception de la saveur sucrée ou l’intensité de l’arôme de vanille ; sa température agit également sur la libération des molécules odorantes et sur la perception de certaines saveurs.
La vision intervient elle aussi. Ainsi, un vin blanc artificiellement coloré en rouge peut être décrit à l’aide du vocabulaire associé à l’univers des fruits rouges (cassis, framboise…). Enfin, les sons produits lors de la mastication d’une chips participent à la perception de son caractère croustillant.
Pas « une » mais « des » pertes du goût
« Perdre le goût » peut donc correspondre à plusieurs situations. L’hyposmie et l’anosmie correspondent, par exemple, aux atteintes de l’odorat.
Une personne anosmique, dont l’odorat n’est plus fonctionnel, peut ainsi reconnaître qu’un aliment est sucré, salé, acide ou amer, tout en éprouvant des difficultés à l’identifier. L’aliment conserve ses saveurs et sa texture, mais perd une grande partie de son identité aromatique. Une plainte de « perte de goût » révèle donc souvent une perte d’odorat.
D’autres personnes peuvent souffrir d’hypogueusie, un terme désignant une diminution de la perception des saveurs, ou d’agueusie, dans le cas où ces dernières ont complètement disparu.
Les troubles ne se limitent pas toujours à une baisse de sensibilité. Les patients atteints de parosmie, perçoivent, par exemple les odeurs de manière déformée : le café ou le chocolat peuvent ainsi sembler systématiquement avoir une odeur de plastic brûlé.
La phantosmie correspond à une odeur perçue sans source présente. Enfin, la dysgueusie désigne une perception gustative modifiée, comme une saveur amère ou métallique persistante.
On comprend pourquoi l’expression « perte du goût » ne suffit pas, à elle seule, à identifier le problème. Pour orienter l’évaluation clinique, il est crucial de distinguer ces troubles, qui peuvent par ailleurs être transitoires ou persister.
La validation d’un test olfactif à visée clinique, auprès de personnes âgées de 15 à 91 ans, a permis de caractériser les déficits de détection et d’identification des odeurs.
Qui est concerné ?
Il faut souligner que les véritables pertes gustatives – c’est-à-dire celles qui concernent les cinq saveurs – sont beaucoup moins fréquentes que les pertes olfactives.
Une altération de l’odorat ou de la gustation peut néanmoins survenir à tout âge. Elle peut être brutale. C’est le cas lorsqu’elle résulte, par exemple, d’une infection respiratoire, de maladies nasales, sinusiennes ou neurologiques, ou d’un traumatisme crânien. Elle peut aussi s’installer progressivement. Enfin, il arrive qu’elle soit présente dès la naissance : certaines personnes viennent en effet au monde sans odorat.
Cette anosmie congénitale, qui peut être isolée ou associée à un syndrome génétique, comme le syndrome de Kallmann, reste toutefois très rare, puisqu’elle concernerait environ une personne sur 10 000. Elle est parfois découverte tardivement, lorsque la personne compare son expérience à celle de son entourage. Une telle anosmie réduit la perception des arômes et la capacité à détecter certains dangers, mais les personnes concernées développent souvent précocement des stratégies de compensation.
Les capacités olfactives tendent également à diminuer avec l’âge, en fonction de l’état de santé et des médicaments consommés (certains médicaments et traitements altèrent en effet l’odorat ou la gustation).
Le Covid-19, révélateur des troubles chimiosensoriels
Le Covid-19 n’a pas créé les pertes olfactives, mais les a fait connaître à une échelle sans précédent. Dès le début de la pandémie, la disparition soudaine de l’odorat, parfois sans nez bouché, est apparue comme un signe évocateur de l’infection.
Une enquête internationale menée auprès de plus de 4 000 personnes déclarant avoir reçu un diagnostic de Covid-19 a étudié séparément l’odorat, la gustation et la chemesthésie. Les participants rapportaient une forte diminution de l’odorat et de la gustation ainsi qu’une altération moindre des sensations trigéminales. Le Covid-19 pouvait donc toucher plusieurs composantes de la perception chimiosensorielle.
Chez la plupart des personnes, les perceptions se sont progressivement rétablies. Mais une étude de suivi conduite jusqu’à onze mois après l’infection a montré que certains participants conservaient une diminution de l’odorat ou développaient une parosmie ou une phantosmie. Recommencer à percevoir des odeurs ne signifie donc pas toujours retrouver celles d’avant la maladie.
Pourquoi est-il important d’en parler ?
La perte ou la déformation de la perception de la flaveur ne constitue pas seulement une curiosité sensorielle. Lorsque les aliments deviennent fades ou méconnaissables, le plaisir associé aux repas peut diminuer, tout comme l’envie de cuisiner ou de manger avec d’autres personnes, ce qui peut dégrader la qualité des relations sociales.
Certains patients concernés mangent moins et perdent du poids, ce qui est préoccupant chez les personnes âgées, malades ou déjà fragilisées. D’autres compensent en privilégiant des aliments plus sucrés ou salés, les épices, le croquant ou les contrastes de température. Dans une telle situation, il faut en effet réapprendre à choisir, préparer et apprécier ce que l’on mange.
La parosmie entraîne quant à elle des difficultés particulières : des aliments appréciés peuvent devenir insupportables. Or, leur éviction peut réduire la diversité alimentaire. S’y ajoutent la perte d’un plaisir quotidien, le sentiment d’isolement et la difficulté à partager les repas.
Enfin, n’oublions pas que l’odorat contribue aussi à la détection de potentiels dangers, qu’il s’agisse d’une odeur de fumée, de gaz ou d’aliment altéré. Sa disparition peut donc exposer à des risques qui dépassent l’alimentation.
En définitive, perdre le goût ne signifie donc pas toujours perdre les saveurs des aliments. Identifier la composante sensorielle atteinte est essentiel pour en comprendre la cause et limiter ses conséquences sur l’alimentation, la qualité de vie et la sécurité.
Cet article est publié dans le cadre de la Fête de la science (qui a lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Thierry Thomas-Danguin ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
11.10.2026 à 08:52
Grand âge : comment les Ehpad repensent leurs liens avec la vie locale
Manon Labarchède, Docteure en sociologie - Architecte D.E. Postdoctorante en sociologie, Projet ANR-COMPAC | Laboratoire Passages (UMR CNRS 5319), Centre national de la recherche scientifique (CNRS)
Texte intégral (2125 mots)
L’ESSENTIEL
Longtemps conçus comme des lieux autonomes de vie et de soins, les Ehpad cherchent à mieux s’ancrer dans leurs territoires.
Tiers-lieux et services ouverts aux habitants transforment progressivement leur relation à l’extérieur.
Cette ouverture oblige aussi à repenser l’architecture et les usages des établissements.
Aujourd’hui, en France, l’accompagnement des personnes âgées les plus dépendantes repose en majorité sur les établissements d’hébergement pour personnes âgées dépendantes (Ehpad). Loin de faire l’unanimité, ces structures sont souvent considérées comme des solutions par dépit lorsque le maintien à domicile, solution d’accompagnement largement privilégiée par les personnes âgées elles-mêmes et par les politiques publiques, n’est plus envisageable.
Cette image négative s’est renforcée au cours des dernières années sous l’effet d’une médiatisation importante des difficultés rencontrées par les établissements, notamment lors de la crise du Covid-19, mais aussi avec la parution de l’ouvrage les Fossoyeurs, de Victor Castanet (2022), qui dénonce les conditions de vie et de prise en charge au sein d’un groupe d’établissements privés lucratif. Dans ce contexte, la question de l’avenir des Ehpad fait l’objet de débats nourris.
Des établissements historiquement conçus pour favoriser l’autarcie résidentielle
Héritiers des hospices du XXᵉ siècle, les Ehpad ont connu, au cours des quarante dernières années, de profondes transformations visant à améliorer les conditions de vie des personnes âgées accueillies. Ces évolutions cherchaient notamment à faire de ces structures des lieux de vie, et non plus uniquement des lieux de soins.
À lire aussi : Personnes âgées : une solidarité familiale trop souvent passée sous silence
Dans cette perspective, les établissements se sont peu à peu efforcés de recréer, autant que possible, les conditions de vie que les résidents connaissaient à leur domicile en cherchant à leur offrir l’ensemble des services, qu’ils soient médicaux ou sociaux, dont ils ont besoin pour vivre. Ainsi, des services habituellement accessibles à l’extérieur ont été intégrés au sein même des établissements (coiffeur, restaurant, lieu de culte, espace bien-être, etc.) afin d’en faciliter l’accès aux résidents.
Si cette logique répond à des objectifs légitimes d’amélioration de la qualité de vie des résidents, elle produit également des effets ambivalents.
D’un point de vue architectural, elle implique une diversification et une augmentation des surfaces à intégrer au programme : aux chambres et espaces de vie des résidents s’ajoutent de nombreux espaces collectifs, médicaux, techniques et logistiques dédiés à l’accompagnement de la vie quotidienne des résidents.
De même, la concentration au sein d’un même espace de l’ensemble des services nécessaires à la vie quotidienne favorise les logiques d’entre-soi et limite les occasions d’interactions avec l’extérieur.
L’amélioration de la qualité de vie peut alors s’accompagner d’un sentiment de mise à l’écart du reste de la société vécus par les résidents, comme perçu par le reste de la société.
À lire aussi : Tout sauf l’Ehpad ? Les ambiguïtés de la politique du grand âge
Surtout, cette logique d’autarcie tend à limiter les liens entre l’établissement et son environnement d’implantation. L’Ehpad est alors pensé comme un modèle largement reproductible, relativement indépendant des spécificités locales et territoriales. Cette standardisation contribue à rendre ces établissements facilement identifiables, mais aussi à les distinguer du tissu social et urbain dans lequel ils s’inscrivent, participant à une forme de stigmatisation des personnes qui y sont hébergées.
Des établissements qui s’ouvrent progressivement sur l’extérieur
En avril dernier, Camille Galliard-Minier, ministre déléguée chargée de l’autonomie et des personnes en situation de handicap, a annoncé un projet de transformation des Ehpad à travers la labellisation de l’ensemble des établissements en « Maisons France Autonomie » d’ici 2027. L’objectif est d’« accompagner la transformation des établissements en des maisons ouvertes sur l’extérieur, en lieux de vie ».
Présentée comme une des six priorités du plan France Autonomie, cette proposition s’inscrit dans la continuité du « virage domiciliaire » engagé par les différents gouvernements depuis une dizaine d’années. Il désigne la réorientation des politiques publiques vers le maintien à domicile, afin de permettre aux personnes âgées de rester autant que possible dans leur environnement de vie. Il repose sur le développement et la coordination des services d’aide et de soins à domicile, l’adaptation des logements, le développement de solutions d’habitat intermédiaires (habitat inclusif, résidences autonomie, etc.) et le soutien aux proches aidants.
Le virage domiciliaire interroge aussi la place de l’Ehpad. S’il ne conduit pas nécessairement à sa disparition, il implique la redéfinition de sa fonction et de son rôle dans les parcours des individus. Ainsi, les réflexions sur l’« Ehpad du futur », portées par les acteurs du champ et les politiques publiques, ne se limitent pas à l’évolution de l’organisation et de modes d’accompagnement des établissements, jugés trop rigides, médicalisés et ne respectant pas toujours les volontés et libertés des personnes. Elles interrogent aussi l’inscription de l’Ehpad dans des dynamiques territoriales à travers l’ouverture des établissements.
En ce sens, une première approche vise à ouvrir davantage les Ehpad sur leur territoire en étendant leurs interventions au-delà du périmètre des établissements.
Dans un premier temps, les expérimentations de dispositifs d’ « Ehpad hors les murs » ont ainsi permis de développer des services externalisés et une prise en charge renforcée afin de favoriser le maintien à domicile des personnes âgées : accès à des professionnels spécialisés dans le champ de la gérontologie, solutions de répit, téléassistance, transport, activités sociales, etc.
Plus récemment, les centres de ressources territoriaux (CRT), financés par appels à projets des Agences Régionales de Santé, ont prolongé et élargi cette dynamique. À l’accompagnement renforcé des personnes âgées à domicile s’ajoute à présent un appui aux professionnels libéraux du territoire intervenant à domicile, à travers par exemple des actions de formation, la mise à disposition d’équipements ou encore le partage d’expertise.
Dans une approche davantage centrée sur la dimension sociale que sanitaire, le développement de tiers-lieux au sein des établissements, largement soutenu et financé par la Caisse nationale de solidarité pour l’autonomie (CNSA) est pensé dans l’optique de créer :
« Un lieu, dans l’enceinte de l’établissement, qui soit librement accessible aux résidents comme aux habitants des environs, et qui permette les échanges, les rencontres, les animations entre personnes de tous âges. »
Restaurant, épicerie, jardin partagé, médiathèque ou même bistrot, sont autant d’espaces, qui voient le jour au sein des établissements.
Si elle peut paraître très institutionnalisée, l’ouverture des établissements sur leur environnement est aussi pensée par les acteurs de terrain et s’appuie sur une multitude d’initiatives plus informelles, développées localement par les établissements, les associations ou les habitants eux-mêmes afin de favoriser la rencontre et l’échange.
À Bordeaux, par exemple, l’Ehpad Village Terre-Nègre a ouvert un café associatif destiné à accueillir à la fois les résidents et les habitants du quartier, faisant entrer des activités ordinaires de la vie locale au sein de l’établissement. À Brest, c’est le restaurant de l’Ehpad qui accueille une clientèle nouvelle et élargie.
Repenser l’architecture des Ehpad pour les ouvrir sur leur territoire
Dans la conception même des établissements, l’ouverture implique un changement profond. Celui-ci repose à la fois sur une meilleure prise en compte du contexte local d’implantation (services disponibles à proximité, desserte des établissements, offre manquante sur le territoire) et sur l’organisation des espaces au sein des établissements. L’ouverture ne peut être envisagée comme une simple caractéristique fonctionnelle ; elle constitue un principe structurant de production de l’espace institutionnel.
Elle influence non seulement la relation de l’établissement à son environnement immédiat et le traitement de ses interfaces avec l’extérieur, mais également l’organisation des espaces intérieurs et les usages qui s’y déploient entre accès au public et intimité. Une logique d’autant plus importante, que l’analyse des établissements, tels qu’ils sont construits aujourd’hui, souligne déjà des incohérences obligeant par exemple les résidents à passer par les espaces collectifs pour se rendre aux douches communes, ou encore les visiteurs à traverser l’ensemble du couloir desservant les chambres pour se rendre dans un lieu collectif.
L’ouverture des établissements poursuit donc un objectif commun : renforcer les interactions entre l’Ehpad et son environnement de proximité. Il s’agit de faire de l’établissement non plus seulement un lieu d’hébergement et de soins, mais également un lieu inscrit dans une dynamique sociale et d’offre de proximité du territoire.
Dans cette perspective, il est nécessaire de ne pas oublier qu’ouvrir l’Ehpad sur son environnement ne consiste pas seulement à proposer de nouveaux services ou à faire entrer des acteurs extérieurs dans l’établissement. Il s’agit aussi de permettre aux résidents de bénéficier davantage des ressources déjà présentes sur le territoire : activités culturelles et sportives, commerces, services publics, associations ou lieux de sociabilité.
Le projet COMPAC sur lequel s'appuie cet article est soutenu par l’Agence nationale de la recherche (ANR), qui finance en France la recherche sur projets. L’ANR a pour mission de soutenir et de promouvoir le développement de recherches fondamentales et finalisées dans toutes les disciplines, et de renforcer le dialogue entre science et société. Pour en savoir plus, consultez le site de l’ANR.

Manon Labarchède a reçu des financements de la Fondation Médéric Alzheimer pour sa thèse de doctorat en sociologie "Les espaces de la maladie d'Alzheimer: conditions de vie, hébergement et hospitalité" (Université de Bordeaux, 2021)
11.10.2026 à 08:52
Trump peut-il acheter les midterms ?
Frédérique Sandretto, Adjunct assistant professor, Sciences Po
Texte intégral (1687 mots)
L’ESSENTIEL
Donald Trump a promis 5 000 dollars à chaque citoyen des États-Unis si les républicains conservent la majorité au Congrès à l’issue des élections de mi-mandat du 3 novembre.
Cette approche relève d’une « politique-business » propre au magnat new-yorkais : l’État est présenté comme une entreprise dont les citoyens sont les actionnaires, qui ont donc droit à un « dividende » quand l’État fait des bénéfices.
Or, les États-Unis affichent un déficit budgétaire colossal et le financement de cette promesse semble pour le moins douteux. D’ailleurs, les électeurs semblent peu enclins à y croire…
La scène était exceptionnelle à plus d’un titre. À Dallas, le 10 septembre dernier, Donald Trump a transformé la première convention républicaine organisée à l’occasion des élections de mi-mandat en un immense meeting à sa gloire.
À l’approche des midterms du 3 novembre, le président ne s’est pas contenté de soutenir les candidats de son parti. Il a voulu faire de cette élection un référendum sur sa propre personne. Il a même demandé aux électeurs de voter comme si son nom lui-même figurait sur le bulletin de vote. Pendant près de deux heures, le locataire de la Maison-Blanche a occupé la scène, multipliant les attaques contre les démocrates et affirmant que son bilan était exceptionnel et devait nécessairement se traduire par une victoire de sa formation.
Surtout, il a dégainé un argument massue : si les républicains conservent la majorité à la Chambre des représentants et au Sénat, chaque citoyen états-unien adulte recevra 5 000 dollars (l’équivalent de 4 500 euros).
Un dividende de 5 000 dollars
Trump a choisi un mot extrêmement révélateur pour désigner cette somme : le « dividende ».
Le terme n’est pas anodin. Un dividende est normalement une somme versée aux actionnaires d’une entreprise lorsque celle-ci réalise des bénéfices. En utilisant ce vocabulaire, le chef de l’État se place une nouvelle fois dans une posture de chef d’entreprise. Il présente les États-Unis comme une immense société dont les citoyens seraient les actionnaires, invités à reconduire l’équipe dirigeante s’ils souhaitent bénéficier d’un joli chèque.
Mais de quelle somme parle-t-on réellement ? Le pays comptant environ 260 millions de citoyens adultes, une allocation de 5 000 dollars représenterait potentiellement près de 1 300 milliards de dollars. À titre de comparaison, le budget de la défense des États-Unis, premier poste de dépense du gouvernement fédéral, sera de 1 150 milliards de dollars en 2027, un montant jamais atteint jusqu’ici.
La question du financement surgit donc immédiatement. Or Trump n’a pas expliqué précisément comment ce programme serait financé. Il n’a pas présenté de dispositif législatif détaillé, alors qu’un tel versement nécessiterait l’intervention du Congrès. Le président ne peut pas décider seul de distribuer 1 300 milliards de dollars aux citoyens. Le caractère spectaculaire de l’annonce est donc très supérieur, pour le moment, à sa traduction juridique et budgétaire.
Cette promesse rappelle surtout les précédents de la politique économique trumpienne. En 2025, l’idée d’un DOGE dividend avait déjà circulé. Le principe était alors de reverser aux contribuables une partie des économies que l’éphémère Department of Government Efficiency, dirigé pendant les premiers mois de son activité par Elon Musk, devait permettre de réaliser. Le chiffre de 5 000 dollars avait déjà été évoqué. Donald Trump avait lui-même repris l’idée, mais elle ne s’était jamais transformée en programme concret.
Vers un modèle de « politique-business »
Ce précédent est important parce qu’il permet de comprendre la mécanique politique actuelle. L’idée n’est pas simplement de distribuer de l’argent, mais de transformer des instruments de politique publique en produits politiques immédiatement compréhensibles.
Les économies réalisées par le DOGE deviennent un dividende. Les recettes douanières deviennent un remboursement. Les bons résultats économiques deviennent une prime. Et maintenant, la victoire républicaine aux élections devient la condition permettant d’obtenir 5 000 dollars.
Cette « politique-business » repose sur une conception très transactionnelle du pouvoir. La politique est présentée comme un contrat. Trump affirme qu’il apporte de la croissance, de la puissance, des investissements, des emplois ou des économies ; en échange, l’électeur lui doit sa confiance et surtout son vote.
Une promesse risquée
La question est évidemment de savoir si une telle promesse peut réellement faire pencher la balance du côté du parti républicain.
La réponse est plus complexe qu’il n’y paraît. Sur le plan psychologique, 5 000 dollars représentent une somme suffisamment importante pour attirer l’attention de millions d’électeurs. Dans une période où le coût de la vie, l’inflation et le prix de l’énergie préoccupent fortement les Américains, la promesse d’un versement direct peut avoir un impact immédiat. D’autant qu’elle permet également à Donald Trump de déplacer la campagne sur un terrain qui lui est favorable : celui de l’argent, du pouvoir d’achat et de la capacité à obtenir des résultats concrets.
Mais cette promesse comporte également plusieurs risques.
Le premier est sa crédibilité. Les électeurs ont déjà entendu parler du DOGE dividend et du tariff dividend (en novembre 2025, Trump avait promis de redistribuer aux Américains au moins 2 000 dollars par personne, ce qui représentait selon lui une partie des recettes supplémentaires provenant des droits de douane qu’il avait instaurés) sans jamais recevoir les sommes annoncées. La promesse des 5 000 dollars peut donc être reçue avec un certain scepticisme.
D’ailleurs, d’après un sondage conduit mi-septembre, seuls 21 % des personnes interrogées croient que, en cas de victoire, Trump mettra réellement cet engagement en œuvre. Et selon une autre enquête, conduite quelques jours plus tard, la promesse de Trump ne change rien aux intentions de vote de 52 % des électeurs, tandis que 32 % affirment qu’elle les rend moins susceptibles de voter en faveur des candidats républicains, et 15 % seulement reconnaissent qu’elle peut les inciter à déposer dans l’urne un bulletin du parti du président.
Le deuxième risque est budgétaire. Le gouvernement fédéral affiche déjà un déficit extrêmement important. Le Bureau du budget du Congrès américain (CBO) prévoit un déficit annuel d’environ 2 100 milliards de dollars. Verser plus de 1 000 milliards de dollars supplémentaires supposerait soit d’obtenir de nouvelles recettes, soit de réduire massivement certaines dépenses, soit d’accroître la dette. Les économistes soulignent également qu’une injection aussi importante de liquidités dans une économie déjà confrontée à des tensions inflationnistes pourrait alimenter de nouvelles hausses de prix.
Le troisième risque est politique. Juridiquement, la promesse de Trump ne relève pas d’un achat de vote au sens strict, puisque le versement serait destiné à tous les citoyens, indépendamment de leur vote individuel et ne constituerait pas une récompense pour avoir personnellement voté républicain. Mais politiquement, l’annonce place plus que jamais Trump, en sa qualité de chef de l’État fédéral, au cœur de la campagne, ce qui peut, certes, mobiliser son électorat le plus fidèle, mais aussi éloigner les indépendants et certains électeurs modérés – et galvaniser l’électorat démocrate, qui pourrait aller voter plus massivement que si le président s’était tenu à l’écart de la campagne.
Quels enjeux pour le 3 novembre prochain ?
La question des prochaines semaines ne sera donc plus seulement de savoir si Donald Trump peut promettre 5 000 dollars à 260 millions de personnes, mais combien d’électeurs américains croiront à la promesse d’un tel dividende. Jusqu’où les électeurs sont-ils encore prêts à miser sur Trump ?
Le 3 novembre, l’Amérique dira si elle est encore prête à investir dans l’entreprise politique de Donald Trump ou si elle estime désormais que le rendement promis ne justifie plus le risque.

Frédérique Sandretto ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
11.10.2026 à 08:51
Pourquoi le prix du bois chute-t-il après un incendie ou une tempête ?
Marielle Brunette, Directrice de recherche, Inrae
Killian Baué, doctorant en économie forestière, Inrae
Texte intégral (2857 mots)
L’ESSENTIEL
Après une tempête ou un incendie, de nombreux arbres endommagés peuvent être vendus si on agit rapidement.
Un afflux de bois à écouler dans les plus brefs délais sur le marché fait alors baisser les prix.
Quelques années plus tard, l’inverse peut survenir : la production d’arbres a diminué et les prix remontent.
C’est un phénomène qui peut parfois surprendre : après des événements catastrophiques de type incendie ou tempête, le prix du bois a tendance à chuter. Le grand public peut souvent s’étonner de cette réalité, en pensant qu’il y a sûrement moins de bois disponible après ces fléaux et que la rareté de cette matière première en augmente forcément les prix. La réalité est tout autre, voici pourquoi.
Beaucoup de bois à écouler rapidement
Après une catastrophe de grande ampleur, beaucoup d’arbres sont endommagés simultanément. Mais cela ne signifie pas que le bois est perdu. S’il est récolté rapidement, il reste exploitable pour la plupart des usages, de la construction à l’énergie, même s’il perd l’accès aux débouchés les plus valorisants.
Une partie ne sera jamais récoltée, non parce qu’elle est inutilisable, mais parce que ce ne sera pas rentable. Le reste doit cependant être exploité rapidement afin de limiter leur dégradation et de préserver leur valeur commerciale. Il en résulte un afflux potentiel de bois sur le marché, mais la filière forêt-bois ne peut pas nécessairement absorber une telle quantité en peu de temps.
Un exercice périlleux en temps limité
Le premier verrou se situe en forêt, où les capacités d’exploitation habituelles, en bûcherons, en engins et en accès aux parcelles, ne suffisent pas à récolter dans le temps imparti l’afflux d’arbres abattus par une catastrophe. Prélever le bois endommagé en forêt est, dans la grande majorité des cas, le travail des entreprises de travaux forestiers (ETF), qui réalisent environ 80 % des travaux d’exploitation en France. Or, le Conseil général de l’alimentation, de l’agriculture et des espaces ruraux (CGAAER) souligne que la profession est confrontée à des difficultés d’attractivité et de recrutement. Les travaux de récolte sont en outre décrits comme physiquement exigeants et dangereux par l’interprofession nationale.
Dans le cas d’une tempête, par exemple, l’exploitation des chablis (les arbres renversés ou brisés par le vent) est particulièrement contraignante : enchevêtrés au sol, ils présentent des difficultés techniques et de sécurité spécifiques pour les exploitants (cf. photo ci-dessous). Pour cette raison, les [pouvoirs publics] ont notamment retenu un surcoût forfaitaire d’exploitation des chablis de 10 euros par mètre cube, déductible du revenu forestier des propriétaires sinistrés, après les tempêtes de 1999 et, dans le Sud-Ouest, après la tempête Klaus en 2009.
Dans ce contexte, la capacité effective de récolte peut être réduite au moment même où le volume à exploiter augmente fortement.
Une logistique complexe et des scieries de moins en moins nombreuses
Le deuxième verrou concerne la logistique. Les bois doivent être abattus, façonnés, débardés (sortis des parcelles jusqu’en bord de route), transportés et, lorsque leur conservation l’exige, stockés dans des conditions permettant de ralentir leur dégradation.
Lors des grandes tempêtes, une partie des troncs abattus (les grumes) a été conservée par aspersion : un arrosage continu maintient le bois saturé en eau, ce qui limite l’apport d’oxygène et ralentit le développement des champignons et insectes responsables de sa dégradation (cf. photo ci-dessous). Cette technique a permis notamment de réguler l’afflux de chablis sur le marché.
La tempête Caetano, en novembre 2024, illustre cette contrainte dans la vallée de la Tarentaise, en Savoie : l’Office national des forêts (ONF) estimait à environ 60 000 mètres cubes le volume de chablis à exploiter, soit, pour la seule commune des Allues, l’équivalent d’environ vingt années d’exploitation habituelle. Un an après, en novembre 2025, l’essentiel de ces bois avait été évacué, façonné et écoulé auprès d’acheteurs partout en France, grâce à des contrats d’approvisionnement mobilisés en urgence.
Le troisième verrou est industriel. Selon l’Agreste, la France comptait 1 214 scieries en 2022, contre 9 000 en 1973, selon la Cour des comptes. La Cour des comptes souligne surtout le sous-dimensionnement de l’outil français : avec une surface forestière inférieure d’environ un tiers, l’Allemagne produit plus de deux fois plus de sciages.
S’y ajoute un décalage structurel, le « paradoxe français » : les sciages portent à 80 % sur des résineux alors que la forêt est feuillue à environ deux tiers. La France importe ainsi chaque année environ 2 millions de mètres cubes de sciages résineux.
Un choc d’offre
Il résulte de cette situation un décalage : après une tempête, un incendie ou une infestation de scolytes (des petits coléoptères qui coupent la circulation de la sève de certains conifères en creusant des galeries dans le bois), la quantité de bois qui pourrait être vendue dépasse largement la quantité qui peut effectivement être récoltée, transportée et transformée dans la fenêtre de temps où ce bois conserve sa valeur. Les prix s’effondrent, tandis qu’une partie des volumes se dégrade sur pied ou en forêt avant d’avoir pu être mobilisée.
En langage économique, on dit que l’offre est supérieure à la demande. Dans ce contexte, la réaction du marché, c’est une chute des prix. En effet, plus un produit est disponible, plus son prix est bas et, inversement, plus un produit est rare, plus il est cher. Il n’est donc pas surprenant qu’un afflux massif de bois sur le marché génère ce que l’on appelle un « choc d’offre ».
Un tel choc fut observé à la suite des tempêtes de 1999 et de 2009. D’après le Centre d’études et de prospectives (CEP) du ministère de l’agriculture, le prix du pin maritime a ainsi chuté de près de 60 % après la tempête Klaus de 2009.
Ce phénomène a également été observé, dans une moindre mesure, dans l’est de la France, en 2018 à la suite des ravages des scolytes. Les conséquences économiques de ces ravages ont été encore plus manifestes dans d’autres pays, en République tchèque par exemple, où la crise des scolytes de 2018 a provoqué une hausse de 340 % des quantités de bois endommagés, engendrant une chute des prix du bois de 73 %.
Un contrecoup possible
Un choc d’offre, cela signifie une urgence à traiter immédiatement, mais aussi des problèmes d’approvisionnement à anticiper. En effet, beaucoup de bois maintenant, cela signifie moins de bois plus tard, car les arbres mettent du temps à pousser. Par conséquent, une baisse brutale des prix peut être suivie après quelques années par une hausse brutale, puisque le bois devient plus rare. On l’observe clairement sur le graphique ci-dessous avec le prix du pin maritime qui s’est effondré à la suite de la tempête Klaus de 2009 avant de remonter progressivement jusqu’à atteindre deux fois le prix d’avant tempête (environ 25 euros par mètre cube en 2005 versus 50 euros en 2018).
Certaines caractéristiques peuvent contribuer à accentuer cette chute de prix. Tout d’abord, si les dommages sont concentrés dans une zone assez restreinte, le marché local va s’effondrer. De plus, la baisse du prix est plus importante quand le bois est homogène en essence et en usage.
Ces deux caractéristiques ont été rencontrées lors de la tempête Klaus de 2009. Cette tempête a touché essentiellement le sud-ouest de la France, endommageant principalement du pin maritime. La chute de prix qui s’est ensuivie fut spectaculaire, atteignant un prix de zéro en 2009-2010. Dans ce cas précis, il devient urgent d’alimenter un marché plus large, d’évacuer les bois vers d’autres régions, voire d’autres pays. Si la catastrophe avait touché plusieurs régions et des essences variées, l’impact aurait été moindre, comme ce fut le cas avec la tempête de 1999 (cf. graphique).
Peut-on minimiser la baisse des prix ?
Comment, dès lors, limiter ces chutes et hausses des prix ?
Les propriétaires peuvent utiliser des contrats d’approvisionnement qui stipulent une date de récolte et un prix, de manière à ne pas subir la volatilité courante des prix du bois. Toutefois, cet instrument ne fonctionne pas en cas d’aléa, car le propriétaire impacté n’est pas en mesure de respecter les clauses du contrat, notamment en matière de qualité et de diamètre.
Une pratique souvent mise en œuvre est de demander aux propriétaires d’être solidaires. En effet, on va suggérer aux propriétaires qui n’ont pas été touchés d’attendre, de décaler leur récolte afin de limiter les bois disponibles sur le marché. Par exemple, après les incendies de 2022 dans le Sud-Ouest, les ventes d’automne par appel d’offres ont été annulées afin de permettre la récolte des bois sinistrés dans les meilleures conditions.
Ensuite, plusieurs politiques publiques peuvent être mises en œuvre, dont certaines ont déjà été testées. Par exemple, une politique de stockage a déjà été mise en œuvre à la suite des tempêtes de 1999 et de 2009. Il s’agit d’entreposer les bois sur des aires de stockage spécifiques, ce qui permet de lisser l’offre de bois dans le temps, c’est-à-dire d’écouler les bois sur le marché plus lentement.
Des subventions au transport ont également déjà été mises en place après les mêmes tempêtes. Elles ont pour objectif de favoriser la circulation des bois sur le territoire et au-delà, c’est-à-dire d’élargir le marché. Enfin, la fixation d’un prix plancher est également une mesure disponible, mais qui, à notre connaissance, bien que parfois discutée, n’a jamais été décidée. Cette fois, il s’agit d’imposer un prix minimum de vente afin d’éviter la ruine du vendeur.
Des aléas de plus en plus fréquents
Sous l’effet du changement climatique, les aléas naturels deviennent plus fréquents et plus intenses. On observe notamment une récurrence d’aléas dans les mêmes zones géographiques. Le Sud-Ouest a ainsi subi une sécheresse en 2021, des incendies de l’été 2022 et les attaques de scolytes qui ont suivi. Ou encore, plus récemment, avec l’arrivée de la nématode du pin à Seignosse dans les Landes en novembre 2025, suivie de la tempête Nils en février 2026, et des grands incendies de l’été 2026. Ces risques multiples et en cascade vont encore accentuer l’instabilité du marché du bois et accroître la volatilité des prix.

Ce travail a bénéficié de l’appui de l’Observatoire pour L’Economie de la Forêt (OLEF) - https://doi.org/10.17180/hk4v-2a37, plateforme de l’UMR BETA. Les auteurs remercient Alexandra Niedzwiedz pour ses conseils et la réalisation du graphique. Ce travail a reçu le soutien du MP XRisques d’INRAE et du projet X-RISKS du PEPR FORESTT (ANR-24-PEFO-0005).
Ce travail a bénéficié de l’appui de l’Observatoire pour L’Economie de la Forêt (OLEF) - https://doi.org/10.17180/hk4v-2a37, plateforme de l’UMR BETA. Les auteurs remercient Alexandra Niedzwiedz pour ses conseils et la réalisation du graphique. Ce travail a reçu le soutien du MP XRisques d’INRAE et du projet X-RISKS du PEPR FORESTT (ANR-24-PEFO-0005).
11.10.2026 à 08:51
Près de 2,7 € de retombées économiques pour chaque euro investi : les universités, moteurs de croissance des territoires
Yannick L’Horty, Économiste, professeur des universités, Université Gustave Eiffel
Laetitia Challe, Docteure en Sciences Économiques - Ingénieure de recherche, Université Gustave Eiffel
Texte intégral (1590 mots)
L’ESSENTIEL
Par leurs dépenses et les publics qu’elles attirent, les universités irriguent le tissu économique.
Si ces retombées se repèrent vite, leurs effets sur la compétitivité sont plus difficiles à mesurer localement.
Un champ de recherche en essor permet d’estimer plus clairement l’apport des universités aux territoires.
Les retombées économiques des établissements d’enseignement supérieur et de recherche (ESR) sur leurs territoires sont souvent peu identifiées par les citoyens.
Le programme Investigation socio-économique sur l’impact territorial des universités (In Situ) permet de les mettre en lumière, en procédant à une réévaluation systématique de la mesure de leur impact local. Déployé en 2025 sur les 6 universités membres de l’association L’initiative, il concernera plus de 10 universités fin 2026.
Ces travaux révèlent qu’1 € investi par l’État dans les universités implique 2,7 euros de retombées économiques pour les collectivités. Il s’agit là d’un résultat robuste, confirmé pour toutes les universités où ce type de calcul a été réalisé.
Différents canaux d’impact
Par leur mission d’enseignement, ces établissements améliorent les compétences des étudiants, ce qui s’apparente, d’un point de vue économique, à un investissement en capital humain. Par leur mission de recherche, ils produisent et diffusent des innovations, des brevets et des connaissances scientifiques qui alimentent le progrès technique, la compétitivité et l’efficacité globale de l’économie.
Ces relais majeurs améliorent les conditions de l’offre de biens et services et jouent un rôle de premier plan dans un contexte de transitions technologique, écologique et sociétale. Mais ils sont spatialement diffus et, bien souvent, ne sont ni perceptibles ni même mesurables à une échelle locale.
Il n’en va pas de même des relais du côté de la demande. Une université est aussi un agent économique et, comme toutes les entreprises ou les acteurs institutionnels, elle engage des dépenses qui ont un effet direct sur la croissance économique et la création d’emplois. L’université réalise par elle-même des dépenses de fonctionnement et d’investissement dans le cadre de ses missions. Ses personnels génèrent des dépenses là où ils résident, en matière de logement, de transport et de consommation. Les étudiants sont aussi des consommateurs et ils peuvent occuper des emplois salariés pendant leur formation, en cas d’alternance. Ces flux irriguent le tissu économique local et méritent d’être objectivés.
Des régions de plus en plus investies
Les collectivités l’ont bien compris et elles investissent depuis plusieurs années dans le financement de l’enseignement supérieur et de recherche (ESR). Si la région est la collectivité territoriale la plus contributrice, à hauteur de 67 %, entre 2018 et 2021, les communes, les intercommunalités et les départements contribuent également alors même que la compétence de l’ESR y est facultative ou optionnelle.
L’État demeure néanmoins le financeur principal de l’ESR, avec la subvention pour charge de service public (SCSP), introduite en 2001, qui représente près de 70 % du budget des universités, auquel s’ajoutent les frais d’inscription et les recettes issues du secteur économique (apprentissage, formation continue, partenariats).
Des difficultés méthodologiques à considérer
Les travaux qui se proposent de mesurer l’impact économique d’une Université se situent dans un champ qui s’est développé depuis plus d’une cinquantaine d’années, principalement aux États-Unis, depuis l’étude de Caffrey et Isaacs Estimating the Impact of a College or University on the Local Economy, publiée en 1971, puis en Europe et notamment en France où un grand nombre de travaux ont été menés à bien selon la même perspective.
Une signature de ce champ de littérature est de distinguer des effets directs et indirects, en adoptant une approche quasi-comptable, et des effets induits, en faisant alors appel à une modélisation d’inspiration keynésienne.
Cette littérature est toutefois marquée par plusieurs limites bien identifiées. D’une part, la grande hétérogénéité des multiplicateurs régionaux retenus et leurs niveaux parfois très élevés (valeurs allant de 1 à 7 selon les études) reflètent des choix méthodologiques et des hypothèses souvent peu harmonisés.
D’autre part, la plupart des applications reposent sur des données agrégées et sur des matrices input-output construites à des niveaux géographiques relativement larges, ce qui limite la capacité à suivre finement les flux de dépenses selon l’identité des fournisseurs ou la localisation précise des étudiants et des personnels.
Dépense publique et effets de proximité
Le programme In Situ repose quant à lui sur l’exploitation de données internes de gestion exhaustives et localisées à la commune, combinées à des données d’enquête et à des simulations, selon une méthode harmonisée permettant de comparer les établissements entre eux, dans l’espace et dans le temps. L’étude pilote sur le périmètre de l’Université Gustave-Eiffel illustre la force des effets de proximité en montrant que sa commune d’implantation, Champs-sur-Marne, capte à elle seule 30,5 % de l’effet emploi de la communauté d’agglomération de Paris-Vallée de la Marne, alors qu’on y dénombre 12,5 % des emplois. La communauté capte elle-même 34,9 % de l’effet départemental, alors qu’elle en représente 17 % des emplois. Le département de Seine-et-Marne capte 40,2 % de l’effet régional alors qu’il représente 8 % de l’emploi de la région Île-de-France.
Ce programme a d’ores et déjà couvert les six universités membres de l’association l’Initiative. Sur ce périmètre qui correspond à une cohorte de 206 000 étudiants, l’impact économique total atteint près de 4 milliards d’euros au niveau national, soit environ 0,13 point de PIB, pour 83 500 emplois en équivalent temps plein, soit l’équivalent d’un grand groupe industriel.
Cette mesure d’impact a été rapportée à la subvention pour charge de service public, pour conclure que chaque euro investi par l’État dans ces universités génère en moyenne 2,7 euros d’activité économique dans les territoires, avec un effet multiplicateur compris entre 2,3 et 3,4 selon les établissements.
Ce résultat central est très solide. Il repose sur des données de gestion localisées et sur très peu d’hypothèses. Surtout, environ 80 % de cet effet transite uniquement par le canal des dépenses des étudiants, ce qui rend la dépense publique universitaire tout à fait singulière : l’université est le seul établissement public qui détermine la mobilité résidentielle de ses usagers, les étudiants, et les concentre durablement dans l’espace, conduisant à des effets économiques de proximité de grande ampleur, sans équivalent dans d’autres établissements publics.
Cet effet d’entraînement territorial unique mériterait d’être mieux pris en compte dans les arbitrages budgétaires sur le financement de l’enseignement supérieur et de la recherche.
Cet article est publié à l’occasion du Congrès 2026 de France Universités, autour de la question « Quel pacte universitaire pour la France de demain ? », organisé le 15 octobre 2026.

Yannick L’Horty a reçu des financements de l'ANR et de plusieurs agences publiques. Le programme In Situ est soutenu par L'initiative, qui réunit 6 universités lauréates I-Site.
Laetitia Challe a reçu des financements de l'ANR.
11.10.2026 à 08:50
Programmes « sérieux » ou « intenables » : rendre les hypothèses économiques discutables est un enjeu démocratique pour 2027
Kilian Rouge, Doctorant au CIRED, AgroParisTech – Université Paris-Saclay
Matthieu Bordenave, Doctorant MSCA en économie écologique, Università di Siena
Texte intégral (1748 mots)
L’ESSENTIEL
En 2027, les programmes économiques des candidates et candidats à la présidentielle seront chiffrés et comparés à l’aide de modèles macroéconomiques.
Ces modèles peuvent aboutir à des conclusions très différentes, sans que leurs hypothèses soient discutées publiquement.
L’enjeu est démocratique : avant même le débat politique, ces hypothèses déterminent ce qui paraîtra « sérieux » ou « intenable ».
En 2022 puis en 2024, deux modèles macroéconomiques appliqués à des programmes de gauche très proches concluaient, l’un à une hausse de la dette publique de plus de cinq points de PIB, l’autre à une baisse de dix points. L’écart tenait en grande partie aux modèles eux-mêmes et à leurs hypothèses, restées hors du débat. En 2027, les programmes présidentiels passeront à leur tour au crible de modèles macroéconomiques, et leurs hypothèses pèseront sur ce qui paraîtra « sérieux » ou « intenable ».
Concrètement, un modèle macroéconomique est une représentation de la réalité mettant en cohérence des informations telles que l’emploi, le produit intérieur brut ou l’inflation. Il peut servir à estimer les effets d’une réforme avant sa mise en œuvre, mais également à mieux comprendre les mécanismes économiques, à arbitrer entre objectifs contraires et à évaluer les incertitudes.
En France, ces outils sont mobilisés par les ministères, l’Insee, la Banque de France ou les laboratoires de recherche. Ces modèles macroéconomiques ne sont pas neutres. Des choix techniques orientent la manière dont les problèmes économiques sont appréhendés ; ils contribuent à définir le champ des politiques jugées possibles.
Nous avons consacré à ces outils un chapitre de la feuille de route remise au Conseil des droits de l’homme en juin 2026. Nous y montrons que les hypothèses retenues pour construire un modèle influencent ses résultats, alors même qu’elles restent largement absentes du débat public.
L’enjeu est démocratique : en amont des choix politiques, ces hypothèses décident déjà de ce qui paraîtra réaliste ou impossible.
Choix des modèles
« Tous les modèles sont faux, mais certains sont utiles », résumait le statisticien George Box. Un modèle isole certains mécanismes et écarte les autres. Ce qui importe est de comprendre ce que le modèle macroéconomique choisit de représenter et comment il le fait. Trois choix sont à prendre en compte :
Ce que le modèle représente
Un modèle ne produit de résultat que sur ce qu’il représente.
Par exemple, de nombreux modèles d’équilibre général utilisés en France réduisent l’ensemble des ménages et des entreprises à un agent représentatif, un « Français moyen ». Une réforme peut ainsi, à première vue, sembler bénéfique pour Monsieur ou Madame Tout-le-Monde, alors que ses effets sont en réalité très inégalement répartis entre les ménages riches et pauvres.
Comportement des Français et des Françaises
Les modèles macroéconomiques font des hypothèses sur la manière dont les ménages et les entreprises adaptent leurs comportements lorsque leur situation économique change.
De nombreux modèles utilisés pour la transition écologique supposent par exemple que la hausse du prix des énergies fossiles conduit les entreprises à leur substituer des énergies décarbonées. Cette réponse à l’évolution des prix dépend d’un paramètre fixé à l’avance appelé élasticité de substitution ; plus il est élevé, plus la transition paraît simple et bon marché.
Qui s’ajuste à qui ?
Les équations comptables ne suffisent pas à elles seules à déterminer l’ensemble des variables. Il faut décider quelles variables sont fixées et lesquelles doivent s’ajuster. C’est ce qu’on appelle la « clôture du modèle ».
Deux exemples : est-ce l’épargne disponible qui limite l’investissement, ou l’investissement qui crée ensuite l’épargne ? Les salaires s’ajustent-ils pour préserver l’emploi, ou sont-ils rigides ?
Ces règles déterminent qui supporte les effets d’un choc. Face à la même crise, un modèle fera baisser les salaires, un autre supprimera des emplois.
Le cas de la transition écologique
Prenons un exemple pour illustrer l’enjeu de ces hypothèses. Pour construire sa stratégie de neutralité carbone 2050, la Commission européenne évalue les mêmes scénarios – mêmes objectifs climatiques et mêmes montants d’investissement – avec plusieurs modèles :
L’un d’eux, GEM-E3, suppose par construction une économie sans ressource inemployée, où l’investissement dans la rénovation empêche l’investissement productif ailleurs. L’économie tourne déjà à plein régime : mobiliser des travailleurs et de l’argent pour la transition revient donc à les retirer à d’autres secteurs.
Un autre, E3ME, suppose au contraire l’existence de moyens inutilisés – chômeurs, et usines au ralenti – et que l’investissement peut être financé sans qu’une épargne préalable soit nécessaire. Dans ce cas, la même dépense permet de faire travailler des personnes qui étaient sans emploi ou d’utiliser des capacités de production qui restaient disponibles. Elle contribue à relancer l’activité sans réduire celle des autres secteurs.
En 2050, le PIB est inférieur de 1,3 % au scénario de référence avec le premier modèle, et supérieur de 2,2 % avec le second. Même scénario, deux verdicts opposés.
Aucun modèle n’est parfait
Il n’existe pas de modèle parfait. Chacun est plus ou moins adapté à la question posée. L’enjeu est de rendre explicites les hypothèses retenues et de permettre la confrontation des résultats obtenus.
Alors, comment rendre leur usage plus démocratique ?
Besoin de transparence
Les institutions tiendraient un inventaire public des modèles qu’elles emploient et indiqueraient lesquels ont servi à chaque évaluation. Chaque modèle serait documenté par une fiche standardisée précisant son type, son usage prévu, ses conditions de calibration, ses hypothèses structurantes et ses limites connues.
Besoin de pluralisme
L’évaluation gagnerait à s’appuyer sur au moins deux traditions de modélisation distinctes. Si le recours à un modèle unique peut se justifier par la comparabilité qu’il assure au cours du temps, cet avantage ne doit pas empêcher la confrontation à des modèles différents.
Ce type d’exercice existe déjà. C’est le cas des travaux de la plateforme intergouvernementale scientifique et politique sur la biodiversité et les services écosystémiques (IPBES) mobilisant treize modèles de nature très différente – modèles de processus écologiques, approches statistiques, évaluation des services écosystémiques – pour l’évaluation des tendances en matière de biodiversité et de services écosystémiques.
Décrypter la fabrique de l’expertise économique
Comme on l’a vu, un modèle n’informe que sur ce qu’il représente. Tout comme les modèles d’équilibre utilisés avant 2008 n’ont pas vu venir la crise, faute de représenter en détail le fonctionnement du secteur financier et la possibilité d’un défaut de paiement, un modèle où ne figurent ni la santé ni les inégalités ni l’état des écosystèmes ne peut pas dire si une politique les améliore ou les dégrade.
C’est au regard de ces dimensions qu’il faudrait évaluer la viabilité de la transition.
Documenter et confronter les modèles ne les rendra pas neutres ; ils ne peuvent pas l’être. Cela rendra leurs hypothèses lisibles et discutables. Derrière les chiffres se trouve toujours une certaine représentation de l’économie : la finance est-elle un simple intermédiaire ? Les inégalités freinent-elles la croissance ? Les limites écologiques transforment-elles le fonctionnement même de l’économie ?
Décrypter la fabrique de l’expertise économique, c’est lever le brouillard technique au profit du débat démocratique.

Matthieu Bordenave est membre de Ecohésion France.
Kilian Rouge ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
11.10.2026 à 08:50
« Dark kitchens » : comment les cuisines fantômes transforment nos villes et notre manière de manger
Khuong Nguyen Huy, Doctorant en Sciences de Gestion, Université Paris-Panthéon-Assas
Jean-Baptiste Welté, Professeur de Sciences de Gestion, Université Paris-Panthéon-Assas
Texte intégral (1547 mots)
L’ESSENTIEL
Cuisines sans salle ni vitrine, les « dark kitchens » prospèrent dans les grandes villes avec l’essor des plateformes de livraison.
Ces établissements suivent d’autres logiques d’implantation que les commerces traditionnels. La proximité des zones à livrer compte plus que la visibilité de la façade.
Ce basculement dépasse l’urbanisme. Il dissocie la préparation, la commande et la consommation du repas. Et interroge ce qu’il reste de la coprésence alimentaire.
Vous avez peut-être déjà commandé un repas de cuisine fantôme sans le savoir. On ne peut pas s’y attabler, il n’y a aucune salle à l’adresse indiquée sur l’application. Ni terrasse, ni vitrine, ni enseigne. Dans la rue, on passe sans le savoir devant ces restaurants invisibles, qui redessinent nos villes depuis plusieurs années.
On appelle ces établissements des « dark kitchens » ou « cuisines fantômes ». Le principe est simple : on y prépare des repas uniquement pour la livraison. Des commandes arrivent par écran. Les préparateurs s’activent aux fourneaux. Enfin, des livreurs viennent récupérer les sacs de nourriture et repartent aussitôt.
Phénomène international
La Direction générale de la concurrence, de la consommation et de la répression des fraudes (DGCCRF) a contrôlé 646 établissements proposant des plats livrés en 2023, dont 103 dark kitchens, confirmant l’installation de ce modèle dans le paysage français.
Des rapports montrent aussi l’ampleur du phénomène à l’étranger. En Angleterre, les dark kitchens représenteraient environ 15 % des points de vente alimentaires référencés sur les trois principales plateformes de livraison, selon une étude publiée en 2025. Au Brésil, une enquête menée dans trois grandes villes a classé 27,1 % des établissements analysés comme cuisines fantômes.
Cet essor dépasse les questions d’urbanisme. Il touche quelque chose de plus profond : ce que le repas perd quand il n’a plus besoin d’un lieu commun.
Où installer son restaurant ?
Dans le commerce de restauration traditionnel, l’emplacement compte avant toute chose. L’attractivité du quartier. La visibilité de la façade. Le passage piéton à proximité.
Mais quelle est la valeur de l’emplacement lorsque le client ne se déplace plus ? Pour une dark kitchen, la localisation compte toujours. Mais ses critères changent de nature. La visibilité de la façade compte moins. Ce qui importe, c’est la capacité à couvrir rapidement une zone de livraison dense.
À lire aussi : L’avenir de la gastronomie française ne se joue pas uniquement dans l’assiette
Un rapport de l’Assemblée nationale relève que l’implantation des dark kitchens dépend notamment de la densité de population et des conditions de desserte. L’Atelier parisien d’urbanisme observe quant à lui que ces établissements s’installent souvent dans d’anciens commerces ou restaurants, en rez-de-chaussée, au pied des immeubles parisiens. Certains s’implantent également dans des communes limitrophes, afin de bénéficier de surfaces plus importantes et d’une zone de livraison couvrant Paris et la proche banlieue.
Comment les dark kitchens transforment la rue
Une étude géographique publiée en 2025 confirme cette logique à plus large échelle. Les dark kitchens privilégient l’accessibilité logistique et les zones résidentielles denses plutôt que l’attractivité visuelle des rues. Leur implantation tient moins aux critères classiques du commerce. Elle s’explique surtout par la position dans les flux de livraison.
À lire aussi : De Byzance à nos tables : l’étonnante histoire de la fourchette, entre moqueries, scandales et châtiment divin
Concrètement, cela change la nature de la rue. Une dark kitchen peut fonctionner derrière une façade parfaitement discrète. Elle peut même sembler fermée. Pourtant l’activité y est bien réelle. Les commandes arrivent, la préparation se fait, les livreurs vont et viennent… La différence n’est donc pas entre une activité présente et une activité absente. Elle est entre une activité conçue pour être vue et une activité qui n’a plus besoin de l’être. Plus un restaurant devient visible sur un écran, moins il a besoin de l’être dans la rue.
Ce que le repas perd sur le chemin de la livraison
Cette réorganisation spatiale ne se fait pas sans conséquences sociales. Car les cuisines fantômes défont ce qui réunissait la préparation, la commande, le service et la consommation d’un repas. Des étapes qui étaient souvent réunies dans un même lieu, au même moment.
Le sociologue Claude Fischler a montré comment la commensalité (c’est-à-dire le fait de partager son repas avec d’autres personnes) participe aux relations sociales et aux formes de sociabilité. On peut prolonger cette réflexion par une question. Que devient la coprésence des convives quand la production, la commande et la consommation sont séparées dans l’espace ?
La dark kitchen contribue, à sa manière, à dissocier les différentes étapes du repas. La préparation se déroule dans une cuisine spécialisée. La commande passe par une interface numérique. Un livreur assure le déplacement physique du repas. La consommation a lieu ailleurs : dans un logement, un bureau ou n’importe quel espace privé.
Le repas circule ainsi entre plusieurs lieux et plusieurs étapes. Ce n’est pas seulement le restaurant qui perd sa localisation. C’est l’expérience synchrone et partagée du repas qui peut s’en trouver reconfigurée.
Isolement alimentaire
Faut-il pour autant accuser les dark kitchens d’avoir inventé l’isolement alimentaire ? Non, ce serait excessif. Le fait de manger seul fait, depuis longtemps, l’objet de recherches en sciences sociales. Des travaux consacrés au solo dining (le fait de manger seul au restaurant) montrent notamment que manger en solitaire ne signifie pas nécessairement rompre avec toute forme de sociabilité : cette pratique peut aussi donner lieu à de nouvelles formes de commensalité.
Plus largement, une revue de littérature a recensé 29 études consacrées aux liens entre solitude, isolement social et comportements alimentaires, confirmant que ces relations constituent désormais un objet de recherche bien identifié.
Les dark kitchens n’inventent rien. Elles offrent simplement à ces pratiques une infrastructure économique et spatiale sur mesure. Elles pourraient ainsi en accélérer la diffusion.
Une question qui dépasse chaque cuisine isolée
Le véritable enjeu concerne les collectivités publiques. Une dark kitchen isolée ne menace pas à elle seule la vie d’un quartier. Mais que se passe-t-il quand une part croissante de l’alimentation urbaine fonctionne sans jamais rassembler personne au même endroit au même moment ?
On peut alors se demander si la rue ne perd pas aussi une fonction plus discrète. Celle de mettre en présence, même brièvement, des personnes qui n’avaient pas prévu de se rencontrer.
D’autres aspects du phénomène méritent chacun un traitement à part. De la gestion des emballages aux conditions de travail des livreurs, le cadre réglementaire reste encore largement à construire.
L’essor des dark kitchens oblige à reconsidérer une évidence qu’on tenait pour acquise. Un repas n’est pas seulement une nourriture qu’on consomme. C’est un moment et un lieu partagés. Lorsque le restaurant cesse d’être un lieu où l’on se rend, c’est peut-être toute la fonction du repas dans la ville qu’il faut repenser.

Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.
11.10.2026 à 08:49
Les animes du studio Ghibli et la culture du riz au Japon
Marica Gambina, Doctorante en études cinématographiques, Université de Lille
Texte intégral (2365 mots)
L’ESSENTIEL
Motif récurrent du quotidien nippon, le riz s’impose comme un marqueur culturel par excellence de la société japonaise.
Princesse Mononoke et le Voyage de Chihiro, notamment, produits par Ghibli, illustrent avec précision la pratique de la riziculture et la façon dont on consomme le riz au Japon.
Du point de vue culturel, ces films d’animation japonais du célèbre studio fondé en 1985 par Hayao Miyazaki et Isao Takahata font déjà partie des classiques du genre.
Le riz représente l’un des symboles du Japon par excellence tant à l’intérieur du pays qu’à l’international. Arrivée dans l’archipel vers 350 avant notre ère., la culture de cette céréale remplace progressivement le mode de vie des chasseurs-cueilleurs jusqu’à s’imposer comme l’un des piliers de l’identité japonaise. L’anthropologue Emiko Ohnuki-Tierney le résume ainsi :
« La symbolique du riz est double : d’une part, “le riz, notre nourriture” et, d’autre part, “les rizières, notre terre”, ces deux aspects se renforçant mutuellement. »
Les animes constituent l’un des principaux produits d’exportation du Japon et véhiculent de nombreuses représentations du riz, offrant au public non nippon un aperçu de ses implications sociales ainsi que historiques et territoriales. Les animes du studio Ghibli, sans doute parmi les plus appréciés à l’échelle globale, illustrent largement le riz. À travers des scènes allant de sa culture à sa consommation, inscrites dans divers contextes historiques, les films du studio Ghibli permettent de saisir l’importance du riz dans la société nippone.
La rizière : contexte agricole et développement urbain
Dans les animes (dessin animé japonais, ndlr) Ghibli, le paysage japonais d’autrefois se présente souvent avec une verdure luxuriante qui recouvre les montagnes encadrant la rizière entre ses flancs. Cette image du territoire japonais est présente jusque dans Princesse Mononoké (Hayao Miyazaki, 1997), dont l’intrigue se déroule à l’époque Muromachi (1337-1573).
La rizière y est déjà présente, mais avec une forme plutôt arrondie et des dimensions irrégulières. Bien qu’elle soit encore éloignée du modèle rectangulaire et homogène qui s’imposera au Japon au fil des siècles, sa présence encadre déjà le territoire japonais, tout en renvoyant aux bouleversements explorés dans le film, notamment la déforestation liée au développement technique et agricole.
Dans Mon voisin Totoro (Hayao Miyazaki, 1988), la rizière, en harmonie avec la forêt, est l’un des éléments fondamentaux de la représentation de l’univers narratif. Elle ne s’inscrit pas parmi les éléments perturbateurs du milieu naturel ; au contraire, elle participe à la description du paysage rural de la région de Tokyo dans les années 1950. Dans le film, cet espace rural, dernier témoignage de la vie traditionnelle nippone face au Japon de l’après-guerre en plaine modernisation, apparaît déjà profondément distinct de la ville, qui s’étendra et gagnera la campagne au cours des décennies suivantes.
La course à l’urbanisation pendant la Haute Croissance est au cœur de la narration dans Pompoko (Isao Takahata, 1994), où le paysage idyllique des rizières encadrées par les montagnes s’impose comme l’objet du désir, non pas des humains, mais des animaux menacés par l’expansion immobilière des années 1960.
Ce contexte rural constitue également un refuge pour les salariés qui quittent la grande ville. Dans Souvenirs goutte à goutte (Isao Takahata, 1991), il s’agit en effet d’échapper à une vie stable, mais dépourvue de passion, au profit d’un travail exigeant dans les champs, où le riz est cultivé selon des méthodes traditionnelles, les bottes et les mains plongées dans le fond aqueux de la rizière.
La préparation du riz et les changements alimentaires
La préparation du riz dans la Colline aux coquelicots (Gorō Miyazaki, 2011) intervient quelques secondes après le début du film, lors de la préparation du petit-déjeuner. Dans ce film, qui se déroule dans les Japon des années 1960, le riz apparaît immergé et vraisemblablement déjà lavé dans un donabe, cuiseur à riz traditionnel en terre cuite munie d’un couvercle en bois. Très présent dans les images des animes Ghibli, le donabe traditionnel renvoie non seulement au rituel quotidien de préparation du riz, mais également à l’omniprésence de cette céréale dans les repas, dont elle constitue un élément indispensable.
Les films Ghibli montrent également le remplacement progressif du donabe traditionnel par le rice cooker électrique ; ne relevant pas uniquement du progrès technique et du miracle économique nippon, sa présence témoigne également de l’évolution des habitudes alimentaires japonaise. En effet, le cuiseur électrique est souvent accompagné de produits alimentaires industriels – eux-mêmes issus du modèle d’importation conséquent au miracle économique – tels que le pain de mie et toute sorte de snacks et de boissons.
Le petit-déjeuner de la protagoniste de Si tu tends l’oreille (Yoshifumi Kondō, 1995), composé de pain industriel et dépourvu du traditionnel bol de riz, s’inscrit dans ces transformations des habitudes quotidiennes, comme le montre la présence du carton de lait (milk) à l’arrière-plan, qui témoigne de l’évolution de l’alimentation japonaise au XXᵉ siècle.
Cependant, les repas familiaux continuent d’inclure la préparation du riz. Par ailleurs, la distribution du riz par la mère, principale responsable du foyer, relève des coutumes sociales, puisqu’elle reflète la hiérarchie familiale.
Manger le riz : survie et identité
Dans le Tombeau des lucioles (Isao Takahata, 1988), la possibilité de consommer du riz détermine la survie des protagonistes dans le Japon vaincu de la fin de la Seconde Guerre mondiale. Les précieux kimonos de la mère des protagonistes deviennent alors la monnaie d’échange permettant de se procurer cet aliment humble et essentiel, nécessaire à la survie.
Cependant, le riz, le bien japonais par excellence, est lui-même rationné au sein du foyer : en raison de ses qualités nutritionnelles, il est réservé aux travailleurs de la nation qui, en contribuant au bien de la patrie, y ont davantage droit que les enfants.
Dans le Voyage de Chihiro (Hayao Miyazaki, 2001), les bols de riz constituent le repas des travailleurs du palais des bains de Yubaba. Miyazaki souligne ainsi la différence entre les mets de luxe souvent riches en protéines animales destinés aux kamis, les divinités clientes de Yubaba, et ceux réservés à la main-d’œuvre.
Toutefois, le riz est également l’un des éléments centraux de l’une des scènes les plus iconiques du film. Bouleversée par son arrivée dans ce monde parallèle au sien, où ses parents sont transformés en cochons, Chihiro perd son identité : en l’embauchant, Yubaba lui vole son prénom.
Son seul allié dans ce monde étranger est le dragon Haku, qu’elle retrouve en privé, à l’abri des massifs floraux. Le dragon la rassure en lui remettant des objets qui lui rappellent son identité, ainsi que des onigiris enchantés. Tout en dévorant les onigiris préparés par Haku, Chihiro fond en larmes.
Encas extrêmement simples, les onigiris que mange Chihiro sont des boulettes de riz triangulaires. L’enchantement de ces onigiris réside dans leur préparation manuelle, fondée sur le rituel préalable du lavage et de la cuisson du riz.
Destinés à réconforter Chihiro, ils dépassent ainsi la simple fonction alimentaire ; leur préparation ne relève pas seulement de l’acte culinaire, mais s’apparente à un geste d’amour. La simplicité de cet encas, dépourvu de toute sophistication de la matière, associée au don des objets personnels, contribue à raviver l’identité perdue de Chihiro par le biais du riz lui-même.
En effet, ces onigiris ne se limitent pas à leur statut de plat traditionnel ; leurs grains de riz évoquent le paysage natal – et idéalisé – des rizières, les efforts nécessaires pour se procurer un bol de riz pendant la guerre, le donabe (ou rice cooker) des repas familiaux… Les larmes de Chihiro coulent, car ces onigiris la ramènent symboliquement chez elle, au cœur d’un monde étranger.
Cet article est publié dans le cadre de la Fête de la science (qui a eu lieu du 2 au 12 octobre 2026), dont The Conversation France est partenaire. Cette nouvelle édition porte sur la thématique « Saveurs savantes ». Retrouvez tous les événements de votre région sur le site Fetedelascience.fr.

Marica Gambina ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.
- GÉNÉRALISTES
- Ballast
- Fakir
- Interstices
- Issues
- Korii
- Lava
- La revue des médias
- Time France
- Mouais
- Multitudes
- Positivr
- Regards
- Slate
- Smolny
- Socialter
- UPMagazine
- Le Zéphyr
- Idées ‧ Politique ‧ A à F
- Accattone
- À Contretemps
- Alter-éditions
- Contre-Attaque
- Contretemps
- CQFD
- Comptoir (Le)
- Déferlante (La)
- Esprit
- Frustration
- Idées ‧ Politique ‧ i à z
- L'Intimiste
- Jef Klak
- Lignes de Crêtes
- NonFiction
- Nouveaux Cahiers du Socialisme
- ✝ Période
- ARTS
- Actualitté
- Autre Quotidien (L')
- Beaux Arts
- Collateral
- Recours au poème
- Villa Albertine
- THINK-TANKS
- Fondation Copernic
- Institut La Boétie
- Institut Rousseau
- TECH
- Dans les algorithmes
- Framablog
- Goodtech.info
- Libre à lire (April)
- Quadrature du Net
- Revue Eur. Médias et Numérique
- INTERNATIONAL
- Alencontre
- Alterinfos
- Gauche.Media
- CETRI
- ESSF
- Inprecor
- Guitinews
- MULTILINGUES
- Kedistan
- Quatrième Internationale
- Viewpoint Magazine
- +972 mag
- PODCASTS
- Arrêt sur Images
- Le Diplo
- LSD
- Thinkerview